
人工智能技术文章
-
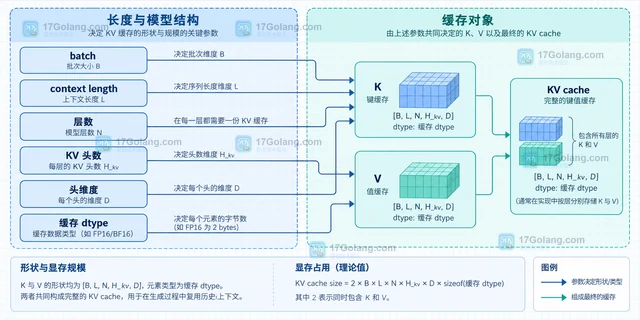 本地部署量化模型时,显存不只由模型参数量决定。本文用权重位宽、上下文长度、KV cache 和运行时余量拆出一套可复用的估算方法,帮助判断量化档位与单卡显存是否匹配。501 收藏
-
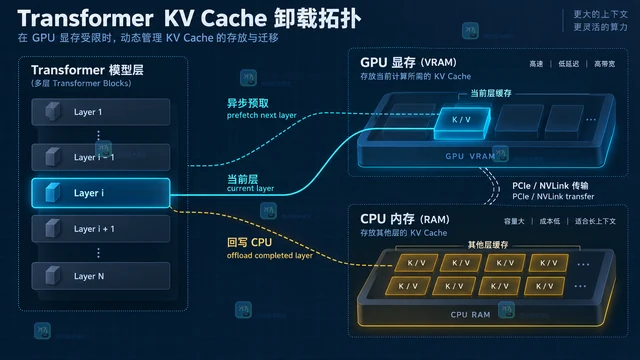 本文说明 Transformers 在显存不足时如何启用 KV cache 卸载,并给出直接配置、OOM 回退、方案选择与风险检查清单。499 收藏
-
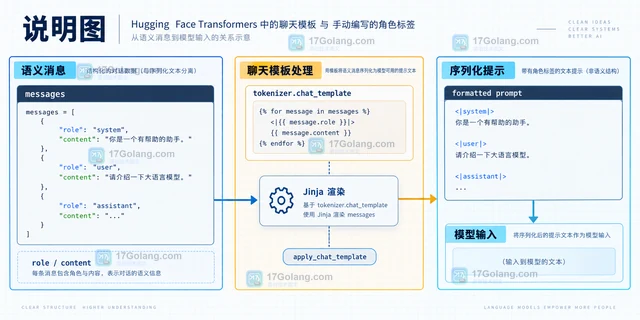 从 role/content 消息、Jinja 聊天模板、助手生成边界和特殊 token 四个方面,说明 Transformers 模板调用与手写角色标签的兼容条件。492 收藏
-
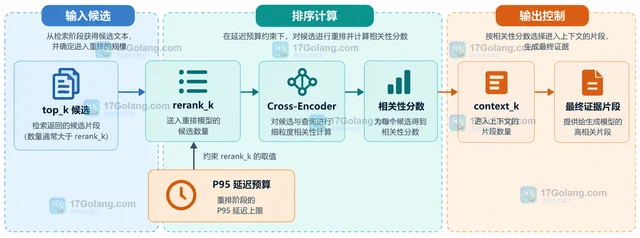 拆分 RAG 的 top_k、rerank_k 与 context_k,说明如何用候选覆盖率、重排延迟、来源去重和上下文预算逐步确定参数。491 收藏
-
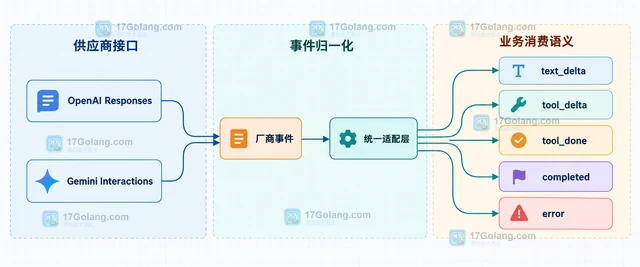 AI 流式接口会同时发送文本增量、工具调用参数和生命周期事件。本文用事件类型建立统一分流规则,说明 OpenAI Responses 与 Gemini Interactions 的差异,以及工具参数何时才适合解析。491 收藏
-
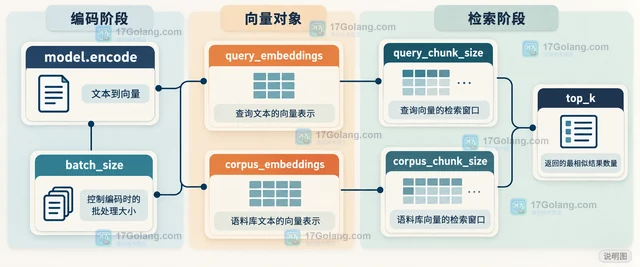 Sentence Transformers semantic_search 的分块大小由 query_chunk_size 和 corpus_chunk_size 控制。本文区分编码 batch_size、检索 chunk 与 top_k,给出按内存和耗时逐步调整的处理方法。491 收藏
-
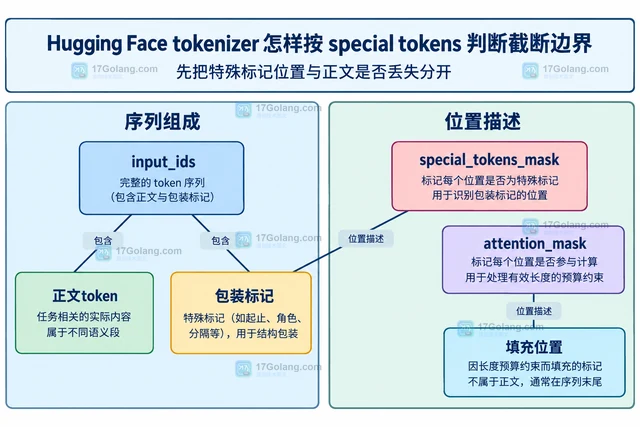 结合未截断编码、special_tokens_mask和模型包装开销,判断Hugging Face tokenizer的截断边界;解释文本对only_second、sequence_ids及SEP/EOS不能证明正文完整的原因。489 收藏
-
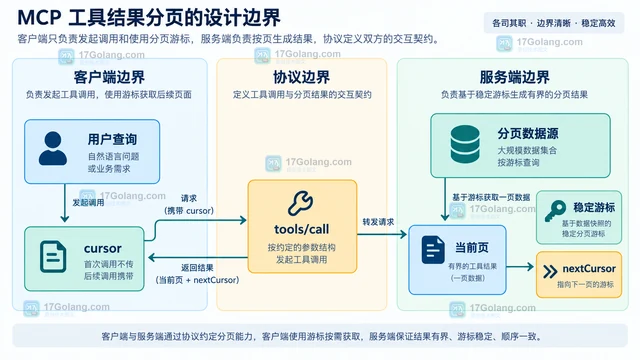 从 MCP 原生列表分页与工具自定义结果两条路径出发,说明如何用稳定游标、结构化续取信息和可读预览控制长列表,避免一次工具调用挤满模型上下文。486 收藏
-
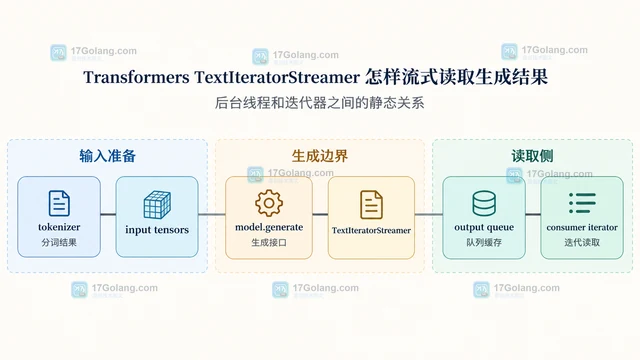 Transformers 的 TextIteratorStreamer 可以把 model.generate 放在独立线程中,再由消费端逐段迭代生成文本。本文按线程、队列、提示词、超时和异常边界说明一套可维护的写法。485 收藏
-
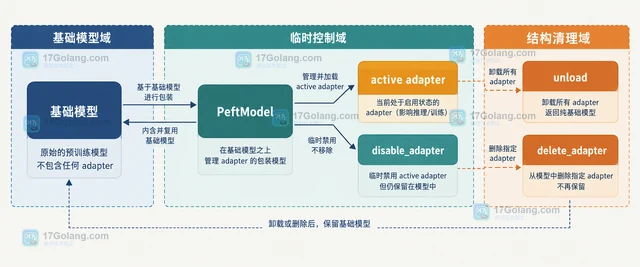 PEFT 中临时禁用 adapter、移除 LoRA 模块、删除命名 adapter 和合并权重是四种不同操作。本文用 unload 返回基础模型,说明为什么必须接住返回值,并整理多 adapter 与 Notebook 重跑时的排查边界。485 收藏
-
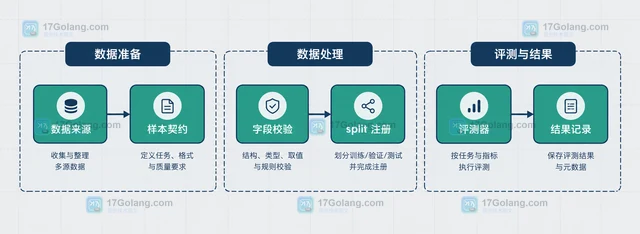 AI 模型评测实验集不能只把训练数据随机切一份。本文从样本契约、JSONL/Parquet 存储、validation 与 test 隔离、指标选择和版本记录五个方面,说明如何把评测边界固定下来,并用 Hugging Face Datasets 与 Evaluate 读取和计算结果。485 收藏
-
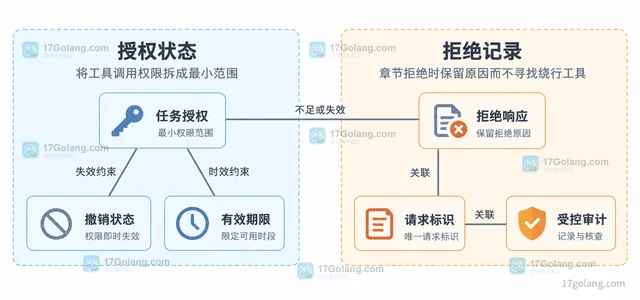 AI Agent 工具授权应拆分为动作、参数、资源、主体和任务有效期,并在可信后端执行默认拒绝。通过只读工单摘要示例,说明最小授权、逐次检查、拒绝处理与授权撤销的边界。484 收藏
-
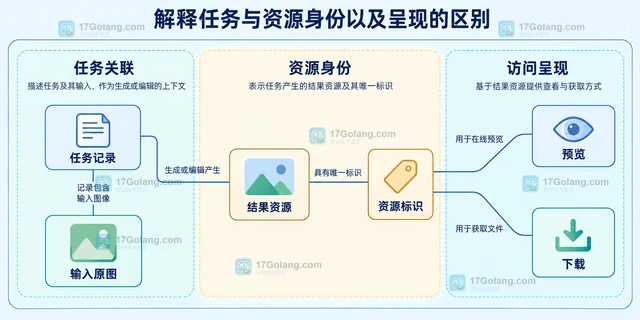 区分AI图片API的文本生成与原图编辑,从输入条件、模型能力、资源版本到预览下载、超时处理和文件清理,说明如何保留原图并避免模式误用。484 收藏
-
科技周边 · 人工智能 | 1星期前 | LoRa PEFT adapter save_pretrained adapter_model.safetensors selected_adapters save_embedding_layers
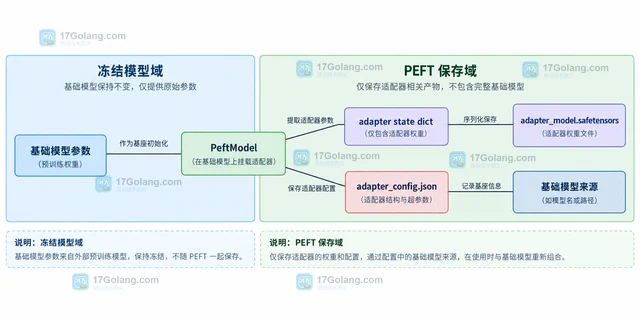 PEFT 的 save_pretrained 默认只保存 adapter 配置和增量权重,不会把冻结的基础模型一起复制。本文说明多 adapter 的 selected_adapters、embedding 层保存开关、重新加载边界,以及 Trainer checkpoint 与完整模型的区别。483 收藏
-
 用 previous_response_id 把 OpenAI Responses API 的两轮请求串起来,讲清指令是否继承、store 与响应保留、链式输入计费,以及何时应该改用 Conversations API。481 收藏