
人工智能技术文章
-
 用 Python 把大模型返回的 JSON 经过解析、字段校验和有限重试,避免把半截或缺字段的数据直接写入业务流程。501 收藏
-
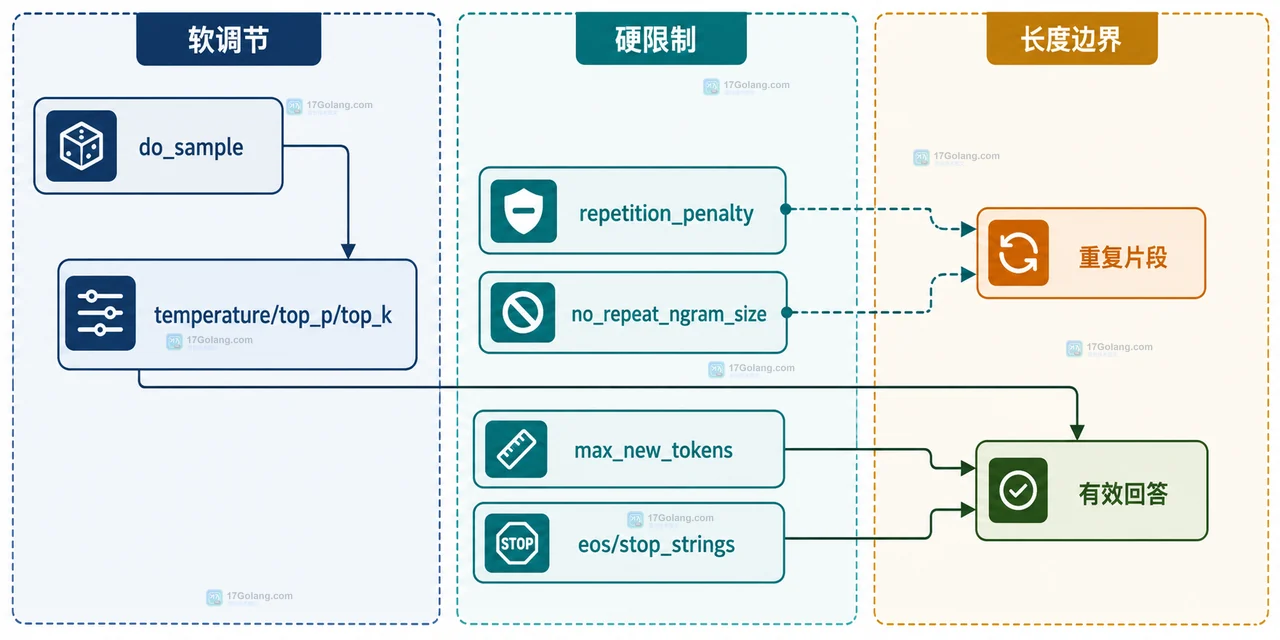 本地大模型反复输出同一句话时,从采样开关、temperature、top_p、repetition_penalty、no_repeat_ngram_size 和长度边界逐项调整,并给出 Transformers 示例。501 收藏
-
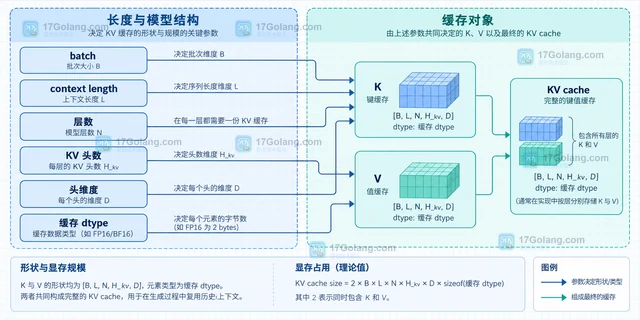 本地部署量化模型时,显存不只由模型参数量决定。本文用权重位宽、上下文长度、KV cache 和运行时余量拆出一套可复用的估算方法,帮助判断量化档位与单卡显存是否匹配。501 收藏
-
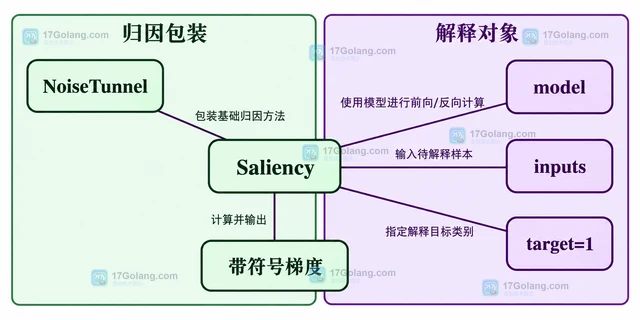 通过固定权重示例说明Captum NoiseTunnel如何包装Saliency完成多次加噪归因,介绍采样数、噪声幅度、分批处理,以及解释服务的资源限制与配置记录。500 收藏
-
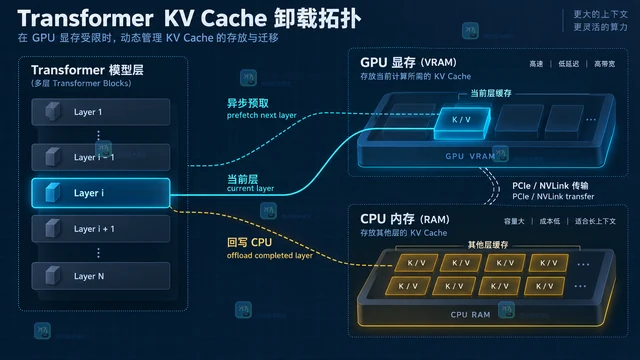 本文说明 Transformers 在显存不足时如何启用 KV cache 卸载,并给出直接配置、OOM 回退、方案选择与风险检查清单。499 收藏
-
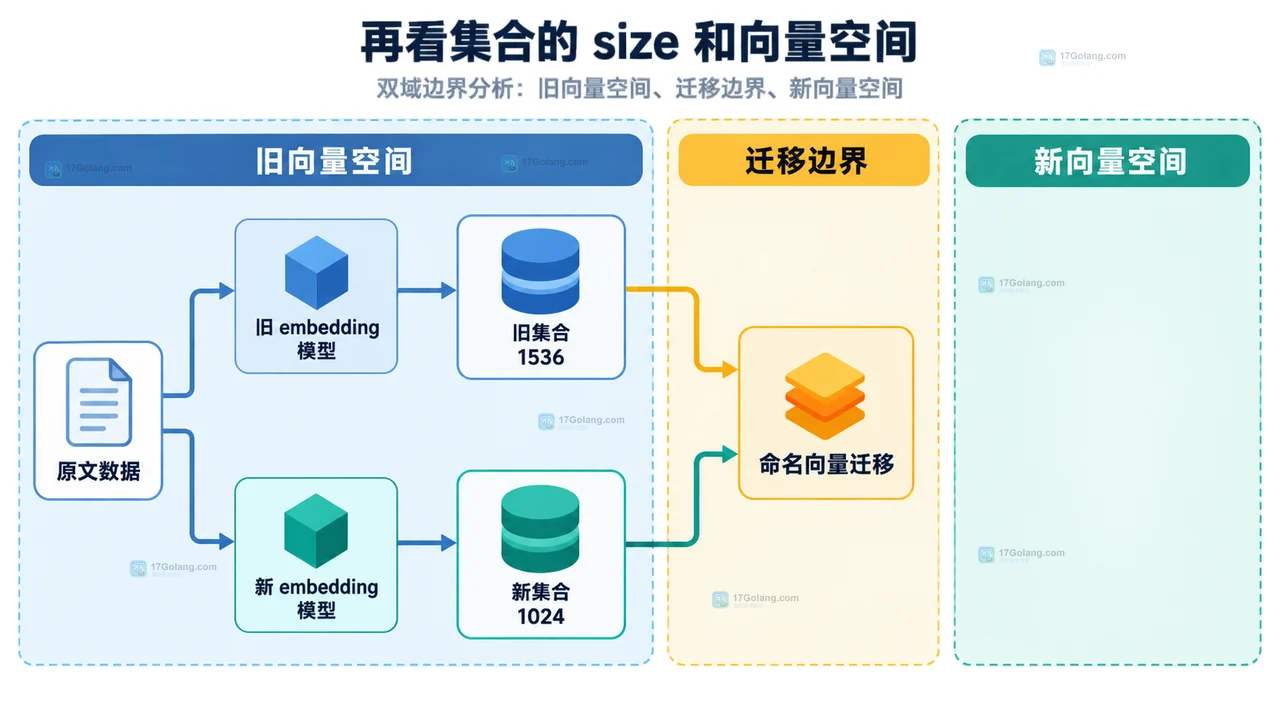 向量库维度不一致通常源于 embedding 模型输出、批量请求和集合 schema 没有对齐。本文给出从 expected/actual 到模型配置、命名向量和迁移方案的检查清单。498 收藏
-
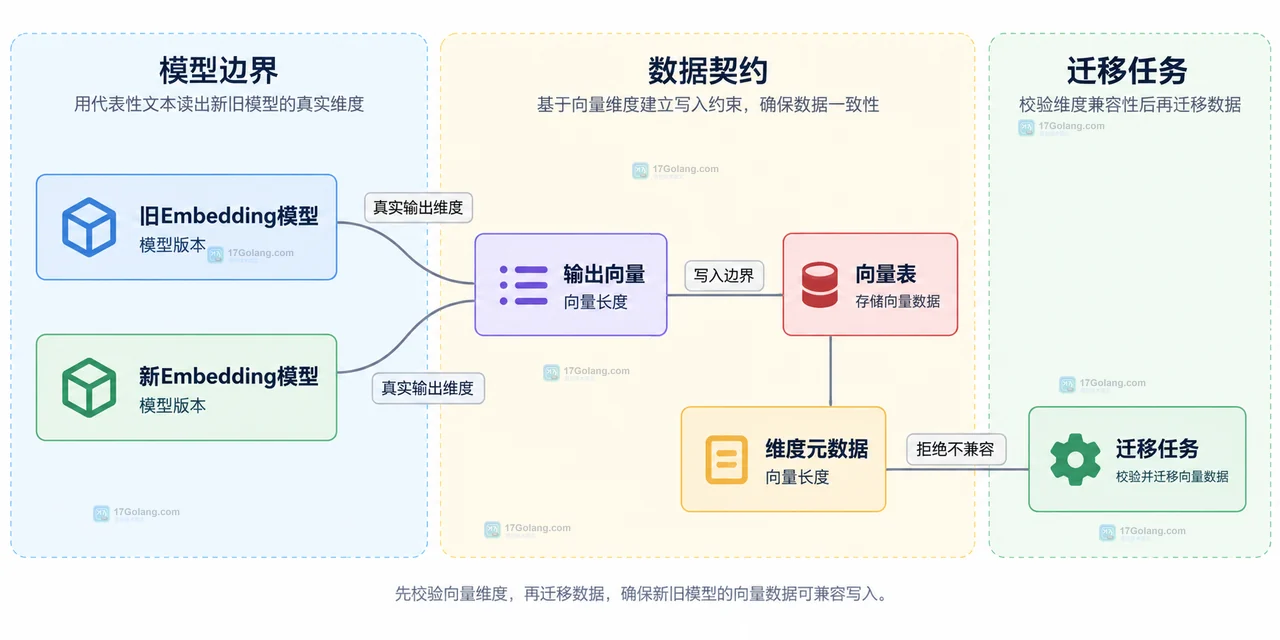 更换 embedding 模型时,先读取新旧模型的真实向量维度,再用模型版本、维度和距离度量建立双索引迁移边界,最后通过小批量回填验证后切换查询路由。498 收藏
-
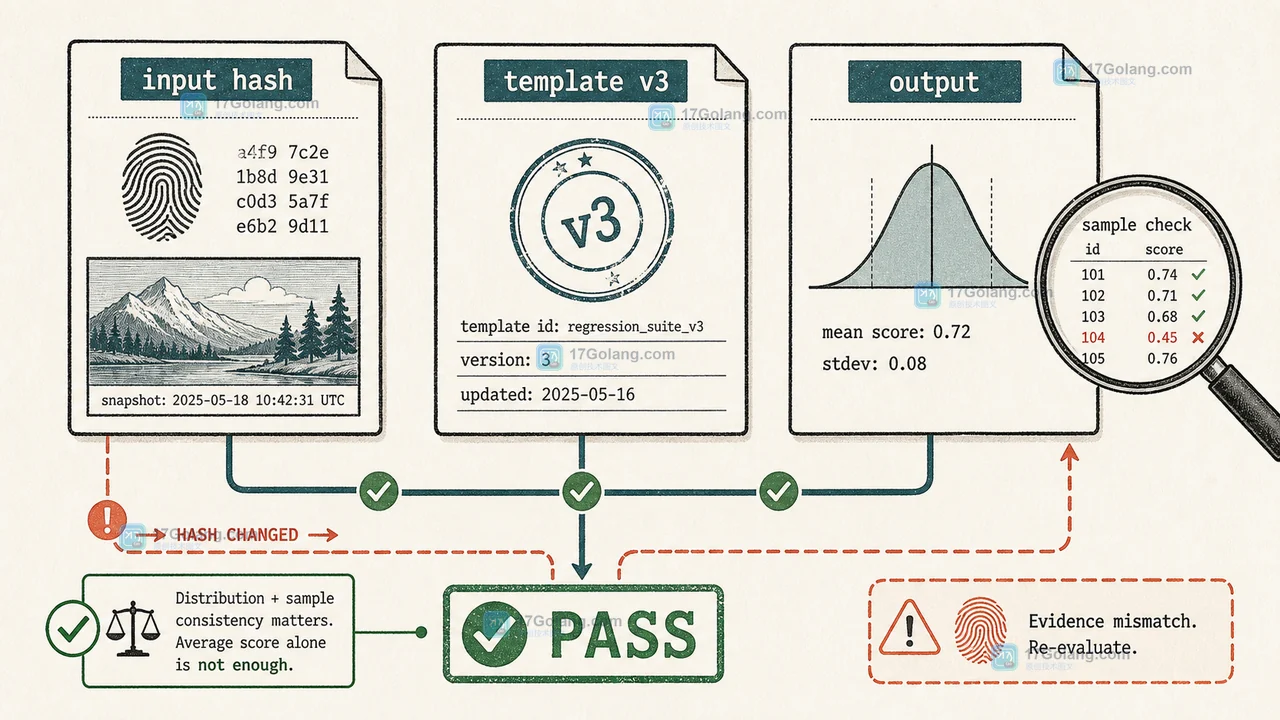 从评测样本、提示词模板和模型输出三层排查评测集污染,给出变量隔离、快照留存与回归验收方法。496 收藏
-
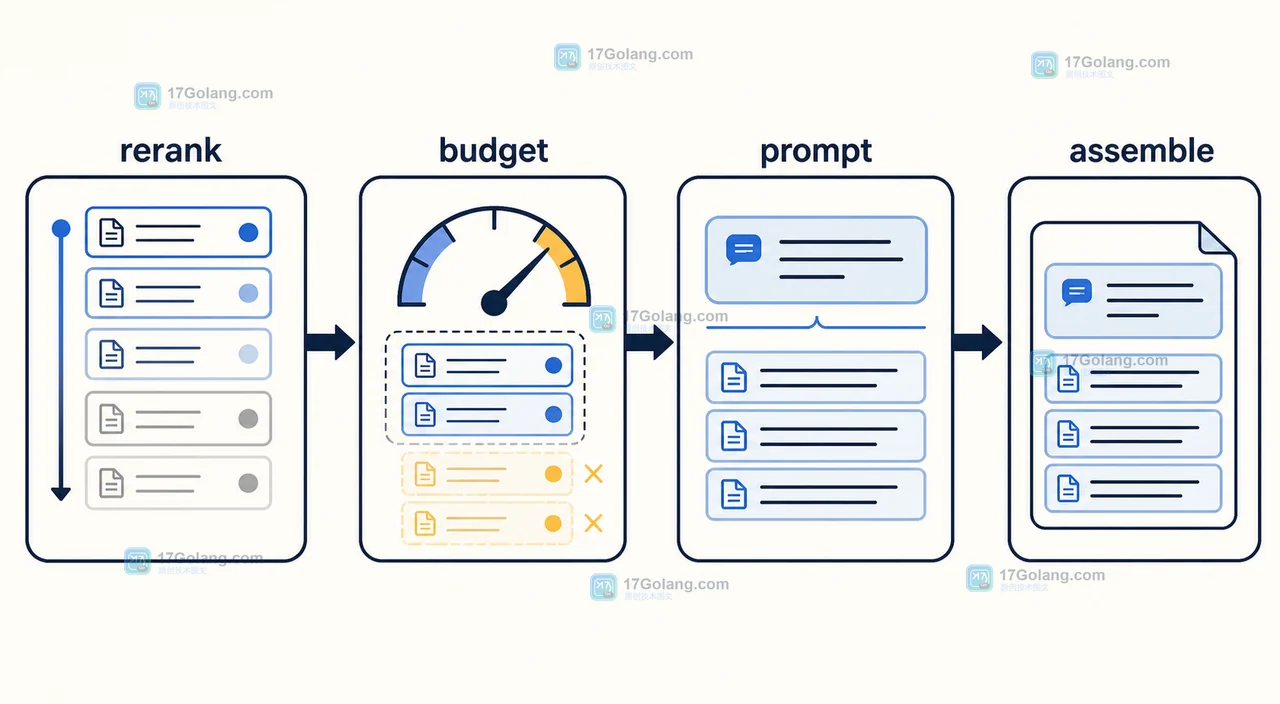 RAG 不是召回越多越好。本文从 retrieve、rerank、budget、prompt 四个真实环节拆解上下文被截断的原因,并给出可验证的预算分配与降级方案。495 收藏
-
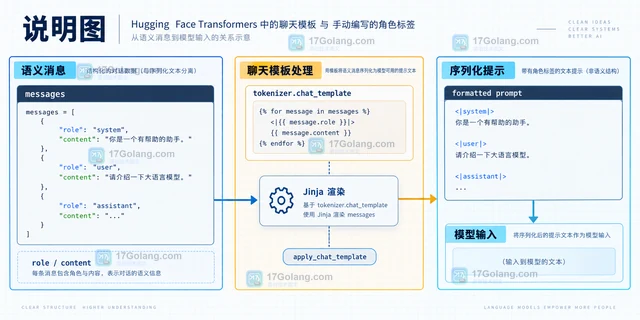 从 role/content 消息、Jinja 聊天模板、助手生成边界和特殊 token 四个方面,说明 Transformers 模板调用与手写角色标签的兼容条件。492 收藏
-
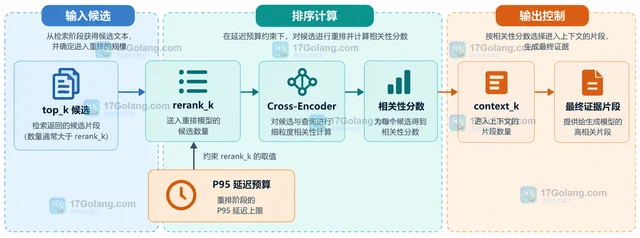 拆分 RAG 的 top_k、rerank_k 与 context_k,说明如何用候选覆盖率、重排延迟、来源去重和上下文预算逐步确定参数。491 收藏
-
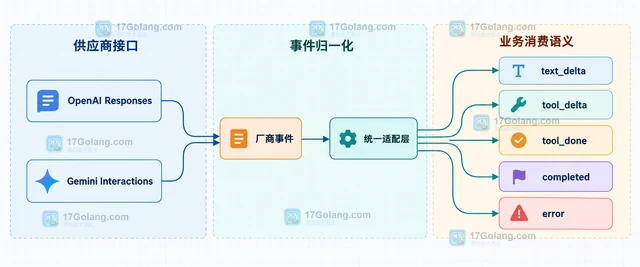 AI 流式接口会同时发送文本增量、工具调用参数和生命周期事件。本文用事件类型建立统一分流规则,说明 OpenAI Responses 与 Gemini Interactions 的差异,以及工具参数何时才适合解析。491 收藏
-
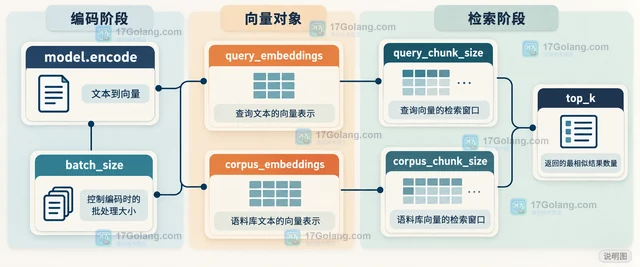 Sentence Transformers semantic_search 的分块大小由 query_chunk_size 和 corpus_chunk_size 控制。本文区分编码 batch_size、检索 chunk 与 top_k,给出按内存和耗时逐步调整的处理方法。491 收藏
-
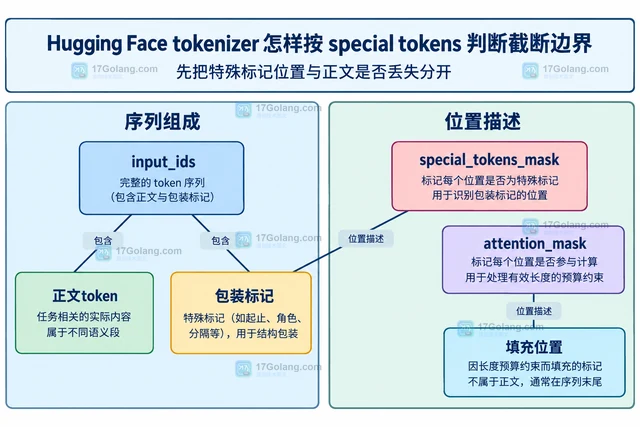 结合未截断编码、special_tokens_mask和模型包装开销,判断Hugging Face tokenizer的截断边界;解释文本对only_second、sequence_ids及SEP/EOS不能证明正文完整的原因。489 收藏
-
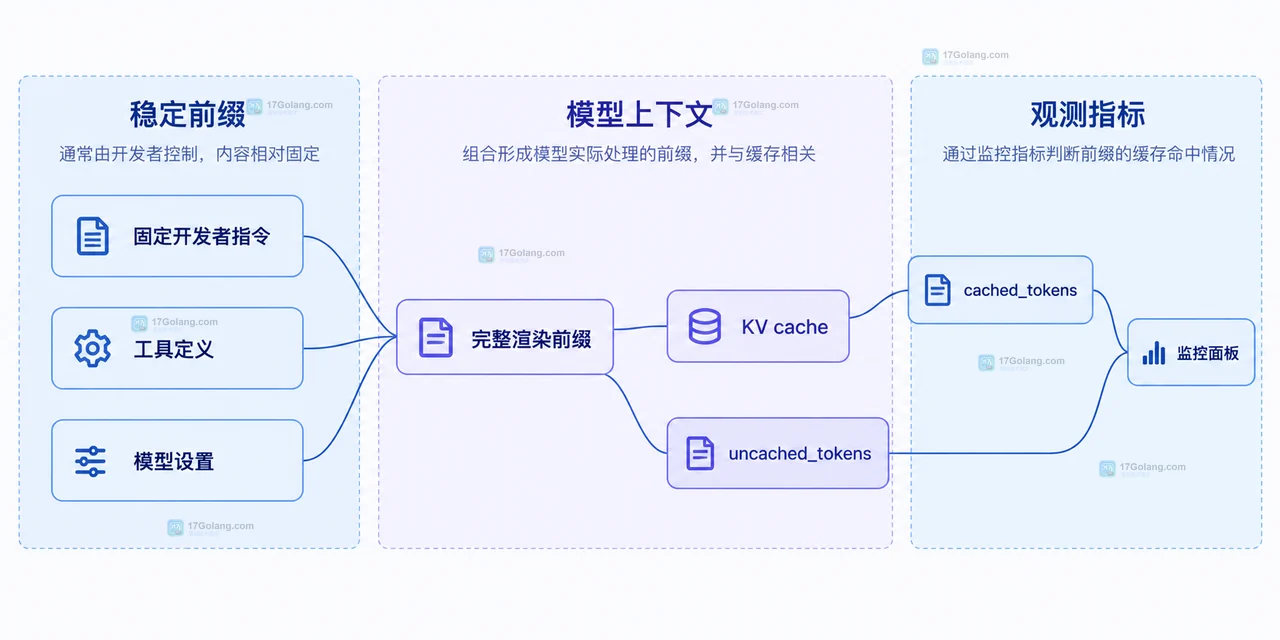 Prompt 缓存命中率下降时,先比较最终渲染前缀而不是源模板。本文用 cached_tokens、prefix hash、模型设置和动态字段边界给出一套可复查的排查方法。487 收藏