
人工智能技术文章
-
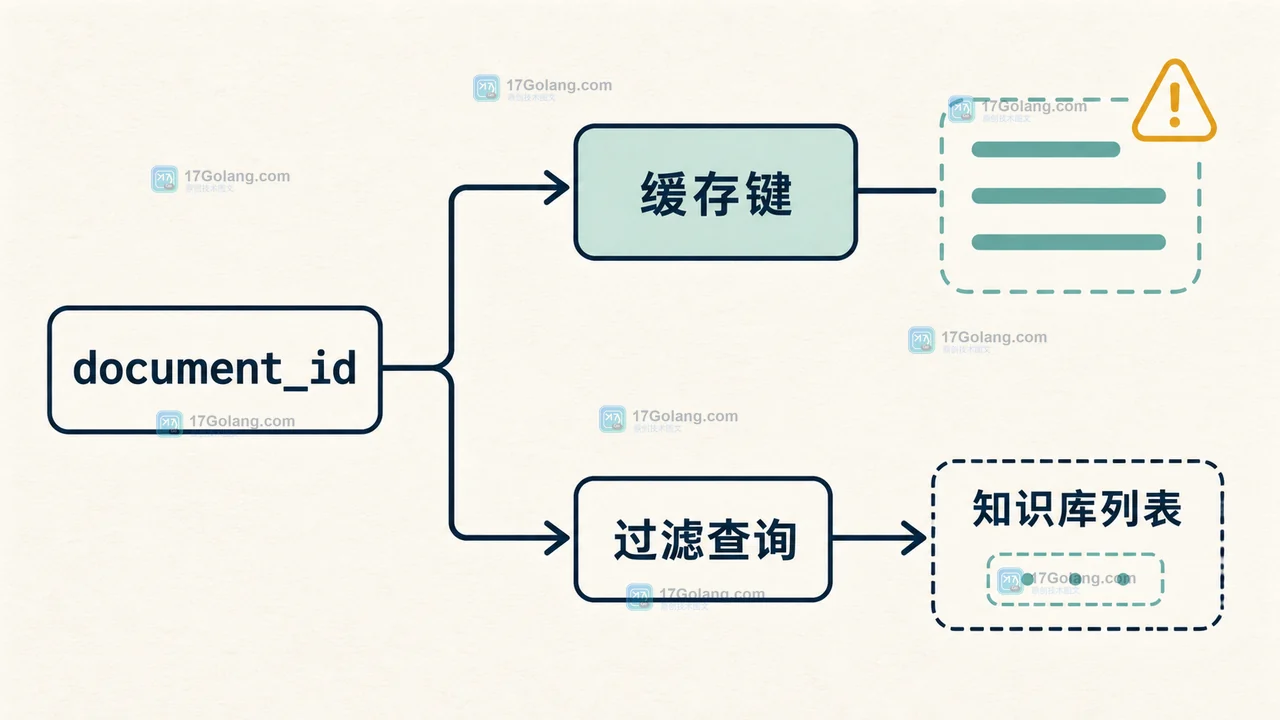 Qdrant 中删除文档后仍被检索到,通常不是删除接口失效,而是写入确认、索引可见性、分布式顺序或应用缓存处在不同阶段。本文用一条可复查的排查链定位并修复这个问题。482 收藏
-
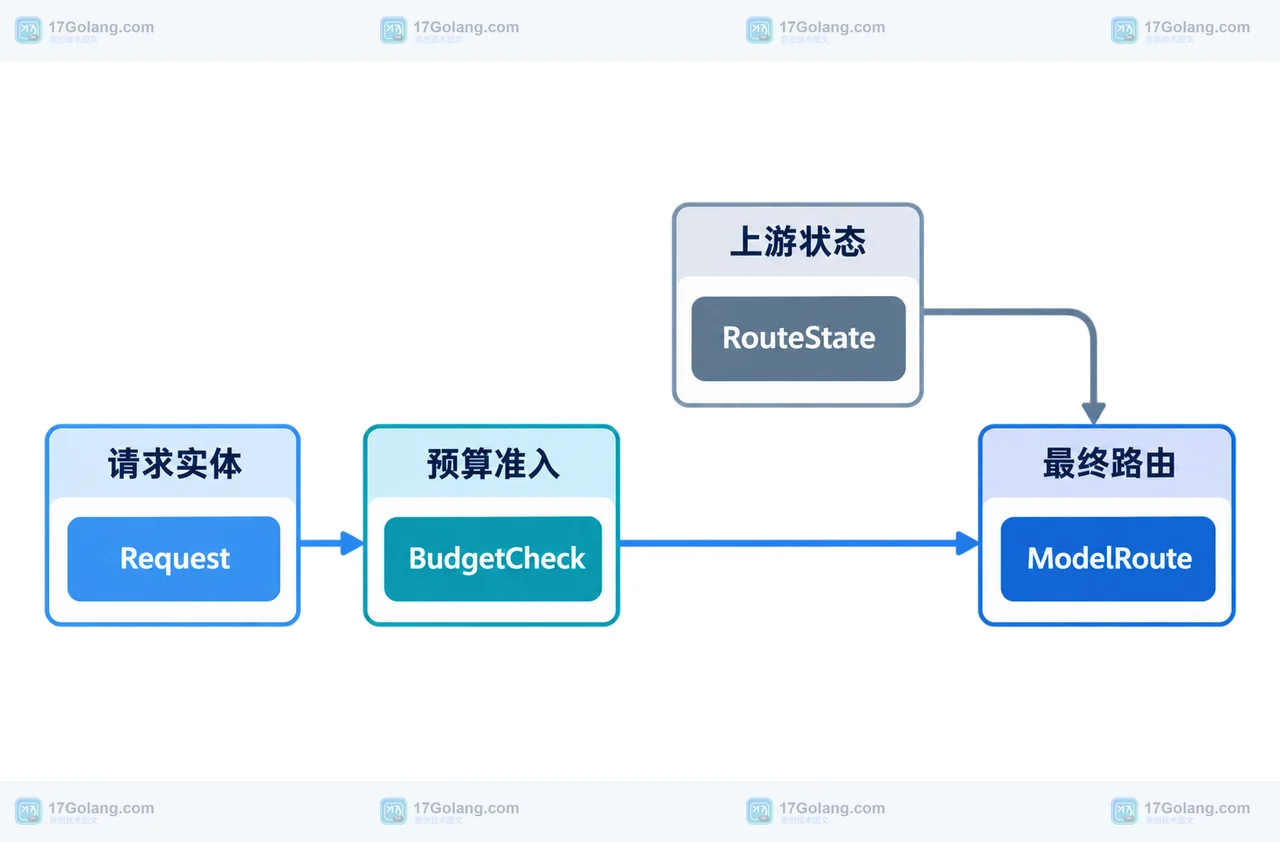 用 Go 实现一个请求级 AI 模型路由器,在选择上游前同时检查 token 预算、请求超时和上游降级状态,避免备用模型被误用或无限重试。481 收藏
-
 本地模型选 4-bit 还是 8-bit,不能只看显存节省。本文用统一基线、固定输入和实际测量比较显存、吞吐、延迟与精度风险,并给出 Transformers 加载示例和部署决策表。481 收藏
-
科技周边 · 人工智能 | 1星期前 | 人工智能 · 工程实践 · 多轮对话 OpenAI Responses API conversation state previous_response_id
 用 previous_response_id 把 OpenAI Responses API 的两轮请求串起来,讲清指令是否继承、store 与响应保留、链式输入计费,以及何时应该改用 Conversations API。481 收藏
-
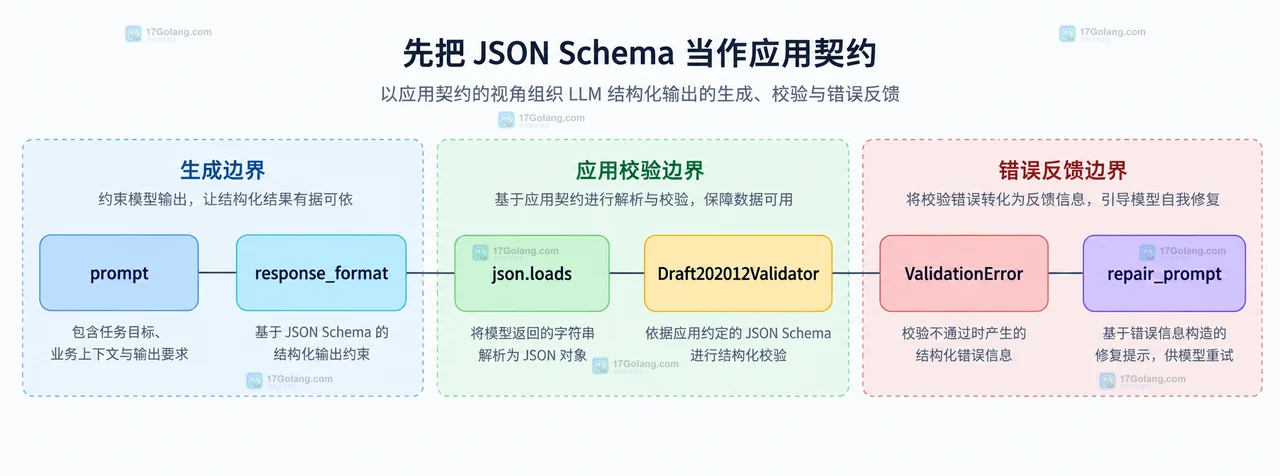 LLM 输出 JSON 不稳定时,不能只靠提示词要求“返回 JSON”。本文用一个工单分类小项目拆解解析、JSON Schema 校验、错误分类和有限重试,并说明为什么业务失败不该混入格式重试。480 收藏
-
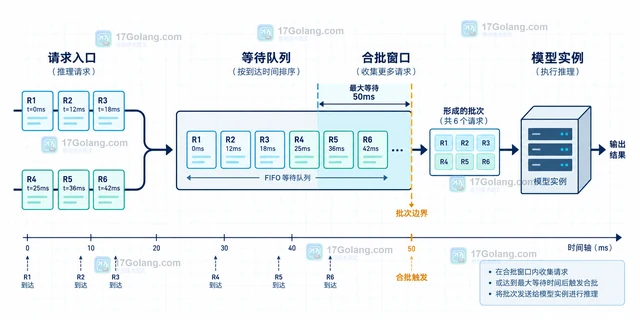 模型服务的批处理不是把 batch size 调大就结束。本文用 Triton 动态批处理和 TGI 连续批处理说明如何设置排队等待上限、批量或令牌预算,并用队列长度、prefill/decode 时长与端到端 p95 验证吞吐收益。479 收藏
-
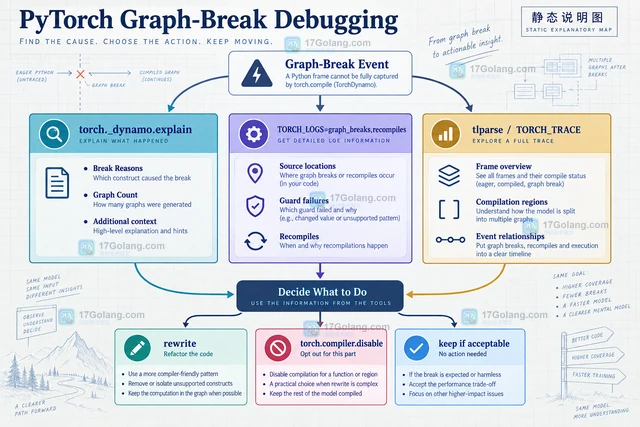 torch.compile 出现 graph break 时,先用 fullgraph=True 暴露首个断点,再用 torch._dynamo.explain 和 TORCH_LOGS 分析原因,最后决定重写、隔离还是保留。478 收藏
-
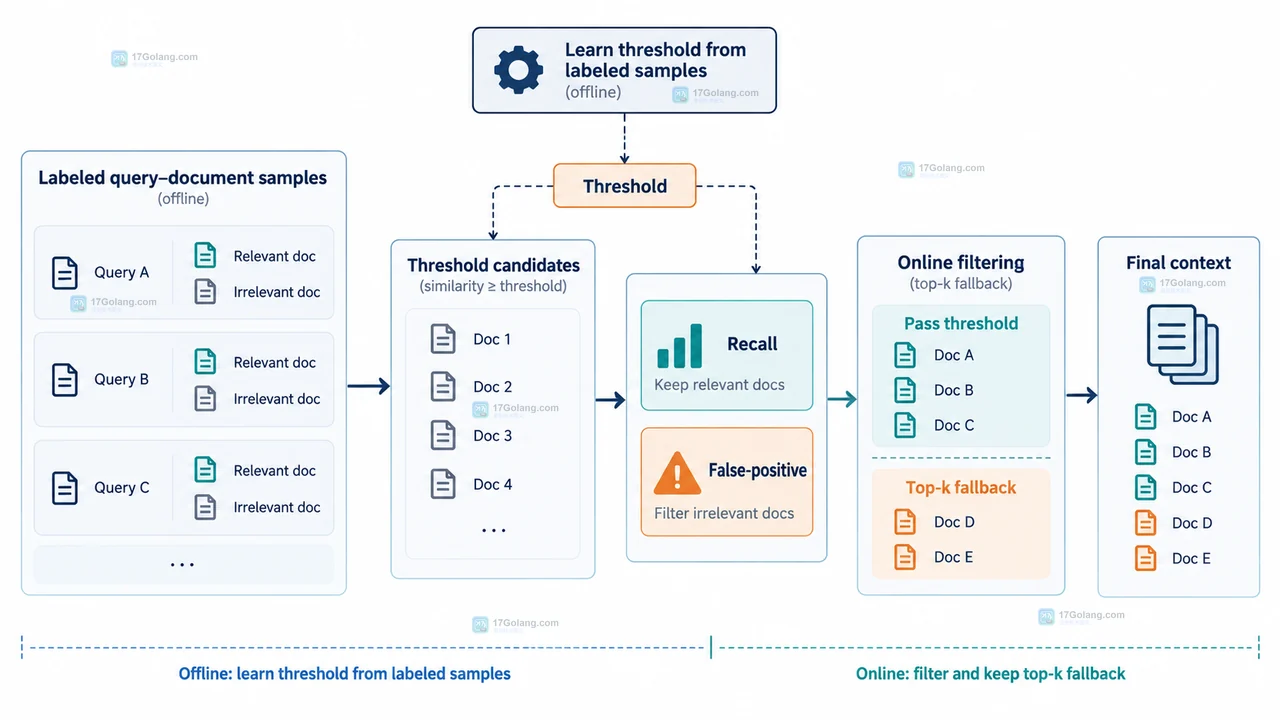 Reranker 分数不是通用的相关性刻度。本文从分数归一化、候选集标注、分层阈值和 top-k 兜底四个方面,说明如何减少相关答案被过滤的问题。477 收藏
-
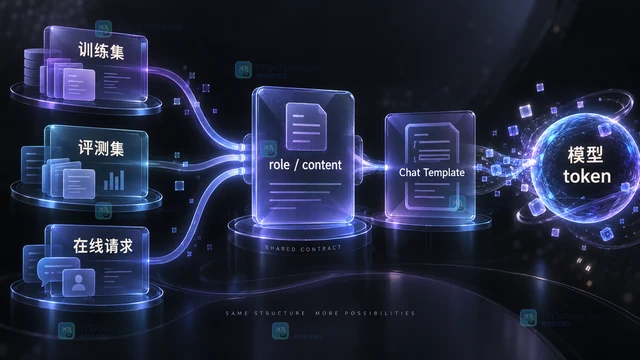 避免 Chat Template 角色格式不一致的关键,是让训练、评测和推理共享同一份 role/content 消息契约,并统一交给 tokenizer.apply_chat_template 序列化。本文给出参数区别、重复特殊 token 的规避方法和集中封装示例。477 收藏
-
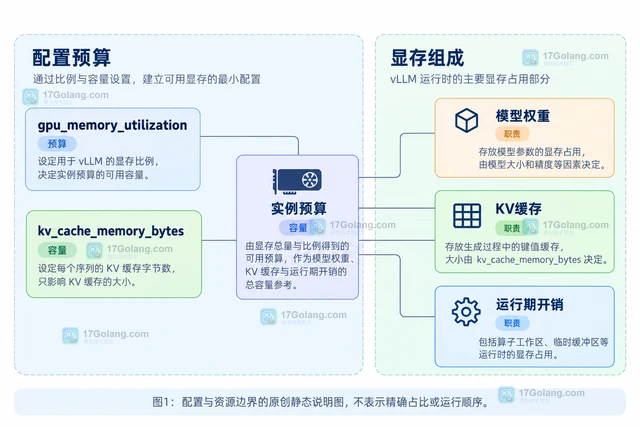 限制 vLLM 显存需区分实例比例预算、KV 缓存大小和上下文并发约束。本文给出保守启动示例,说明参数优先关系、共享GPU边界、失败回退与运行记录,不承诺固定节省比例。476 收藏
-
科技周边 · 人工智能 | 2星期前 | 人工智能 · 深度学习 · 内存优化 · 内存 PyTorch 按需加载 mmap checkpoint torch.load map_location state_dict
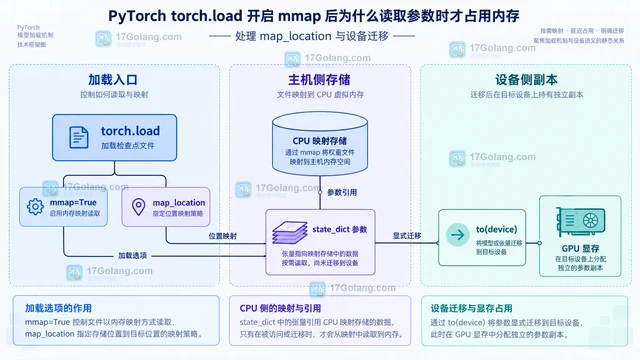 torch.load 的 mmap=True 建立的是检查点文件映射,不是把全部参数立即复制进物理内存。本文结合首次访问、CPU 映射和 to(device) 迁移,解释虚拟地址、驻留页与设备副本的区别,并给出大检查点的加载取舍。475 收藏
-
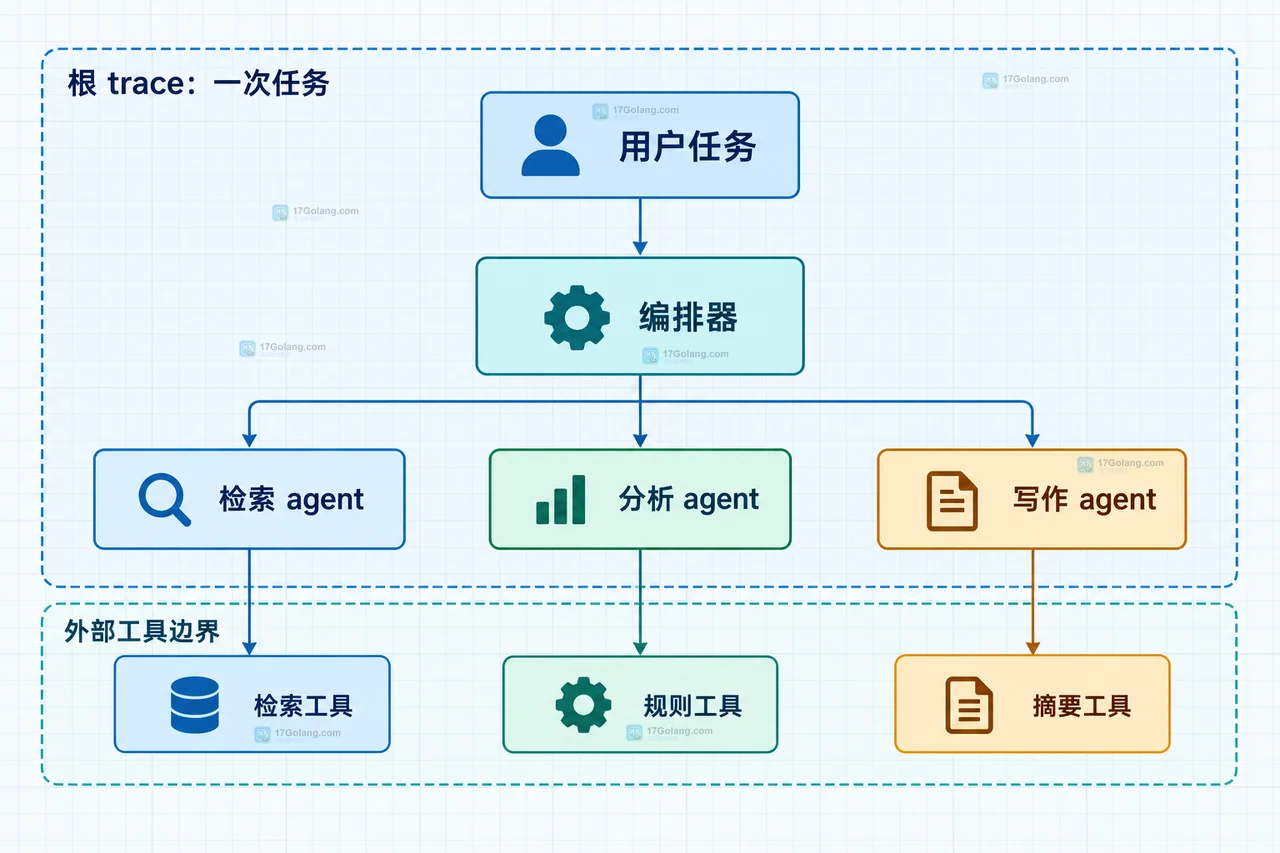 多智能体系统出错时,单看模型调用或 HTTP 状态往往找不到根因。本文从一次用户任务出发,拆解 agent 委派、交接、工具调用和记忆读写的追踪边界,给出可回放的链路设计与检查清单。474 收藏
-
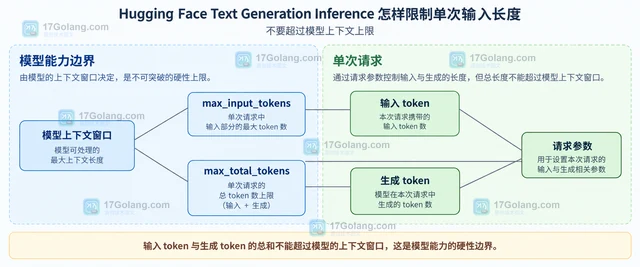 TGI 的输入长度不能只看 max_input_tokens。本文拆开 max_input_tokens、max_total_tokens、max_new_tokens 与模型上下文上限,给出配置示例、取舍和上线前检查方法。474 收藏
-
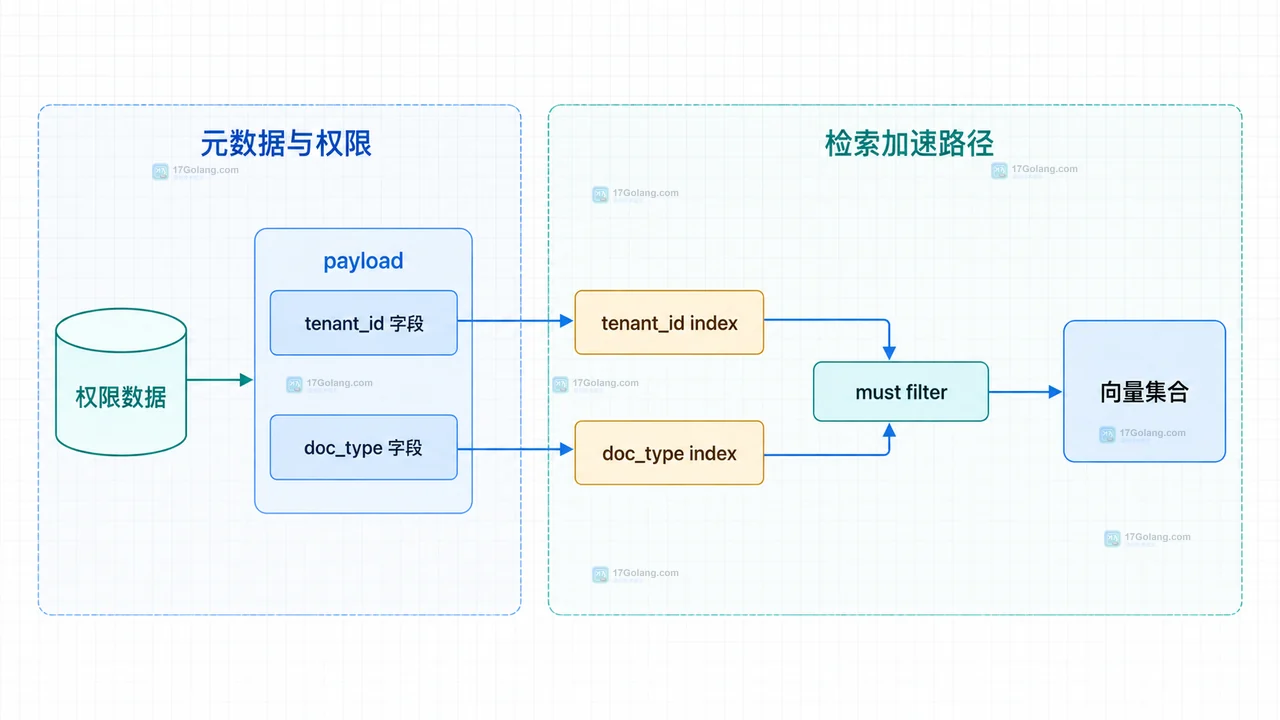 用 Qdrant payload 保存 tenant_id 和 doc_type,通过 must 组合租户与文档类型过滤条件,并为高频字段建立 payload index,让向量检索先守住知识库权限边界。473 收藏
-
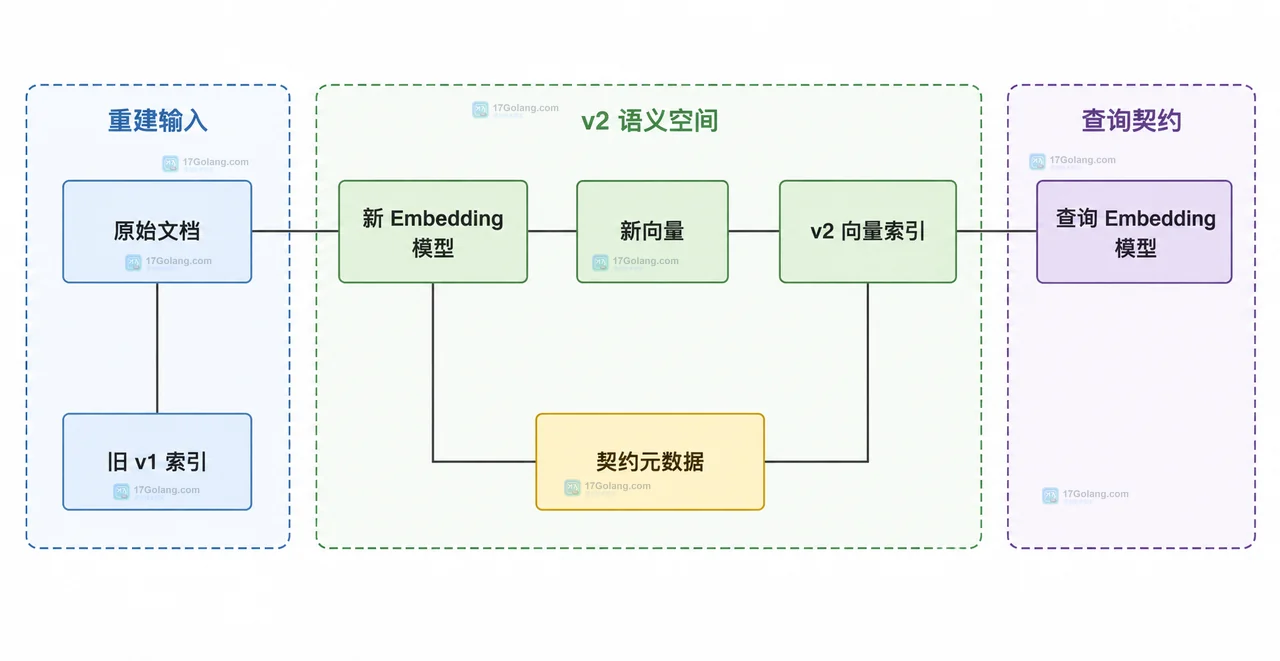 Embedding 模型切换时,旧向量不能只看维度是否相同。本文从维度、语义空间和索引元数据三个层面说明混用风险,并给出重嵌入、建新索引和灰度切换的迁移做法。473 收藏