
人工智能技术文章
-
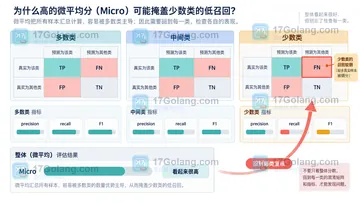 分类评测集不均衡时,macro 与 micro 不是谁更高级的问题,而是按类别平均还是按样本汇总。本文用统一口径、混淆矩阵和复核清单解释两者差异。473 收藏
-
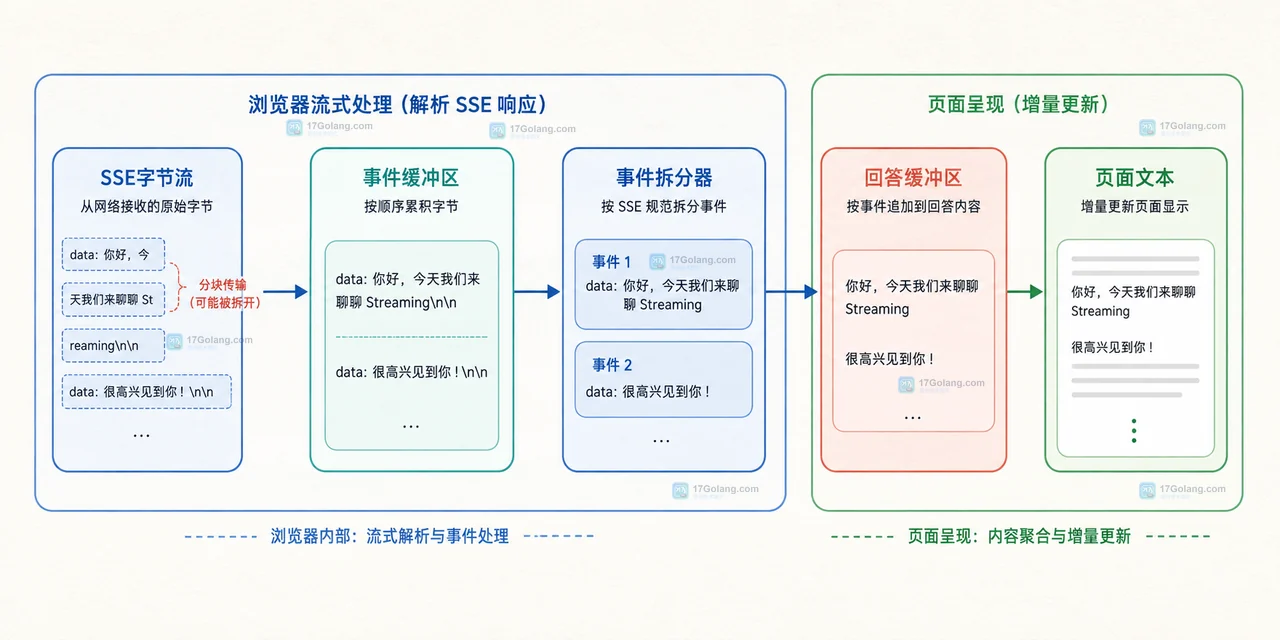 用 TextIteratorStreamer 接收 Transformers 的增量文本,再通过 FastAPI SSE 传给浏览器,完成一个可处理异常和断开的流式生成接口。472 收藏
-
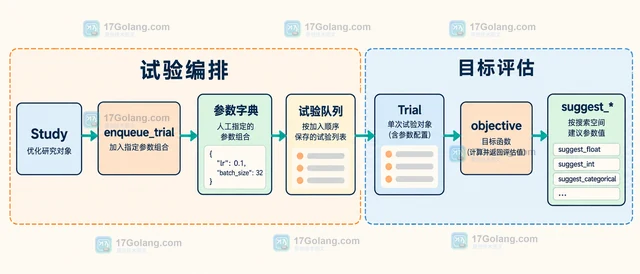 Optuna 的 enqueue_trial 可以把人工指定的参数组合放入试验队列,让 objective 先评估这些候选,再继续交给 sampler 搜索。本文演示调用顺序、skip_if_exists、参数范围和并发边界。472 收藏
-
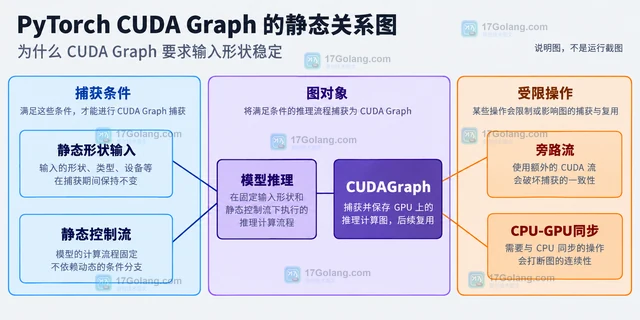 PyTorch CUDA Graph 适合重复执行、输入形状稳定且 CPU 调度开销明显的推理路径。本文用静态输入、旁路流预热、捕获和 replay 说明怎样固定形状复用流程,以及变长请求应该怎样分桶或回退。471 收藏
-
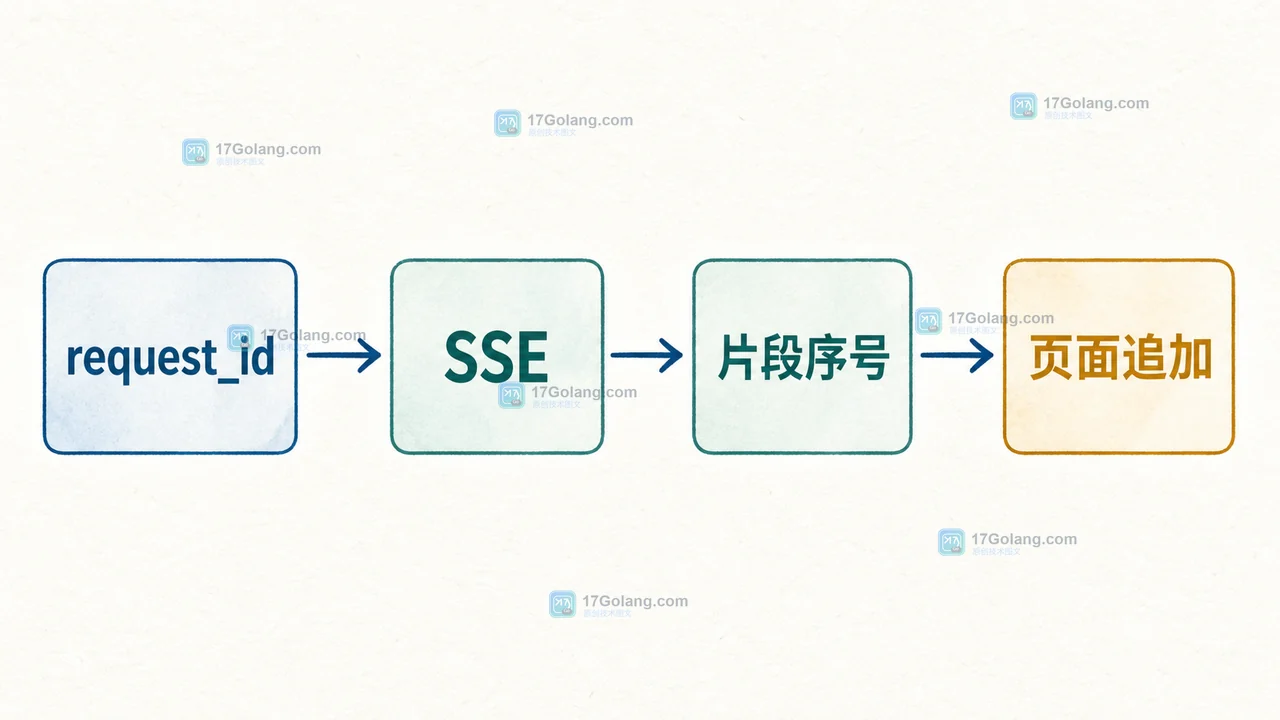 大模型回答出现整段重复时,不要只把 temperature 调高。本文按请求参数、采样范围和停止条件拆开排查,给出一个可复现的参数核对流程,并说明哪些现象属于模型能力边界,哪些是客户端拼接造成的。470 收藏
-
科技周边 · 人工智能 | 3星期前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size
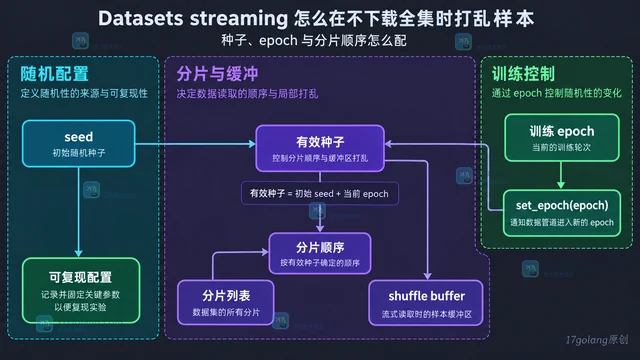 Hugging Face Datasets 的 streaming 模式可用 IterableDataset.shuffle 在有限缓冲区内随机采样,无需下载完整数据集。本文说明 buffer_size、seed、set_epoch、分片顺序以及 take/skip 的调用边界。470 收藏
-
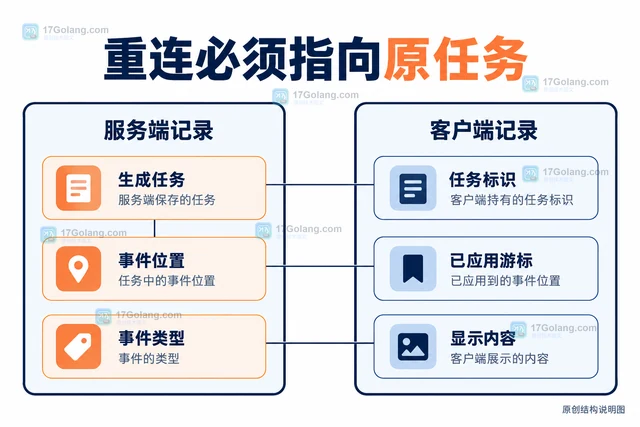 AI 流式断线恢复需区分连接重建、原任务事件重放与重新生成。本文说明 EventSource 和 fetch 的差异,给出任务标识、事件游标、去重、保留窗口与完成状态的设计方法。470 收藏
-
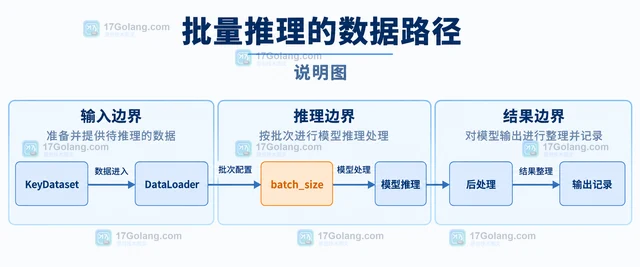 Hugging Face pipelines 的 batch_size 适合在可批处理的数据集推理中逐步调节。本文说明参数放在哪里、GPU 与 CPU 的边界、sequence_length 对显存的影响,以及如何记录吞吐、延迟和 OOM 风险。469 收藏
-
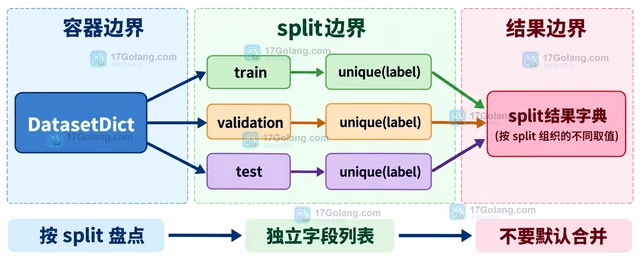 Hugging Face Datasets 的 Dataset.unique 和 DatasetDict.unique 可以直接列出字段的不同取值。本文用最小示例说明字段检查、split 结果、返回顺序以及高基数字段的内存边界。469 收藏
-
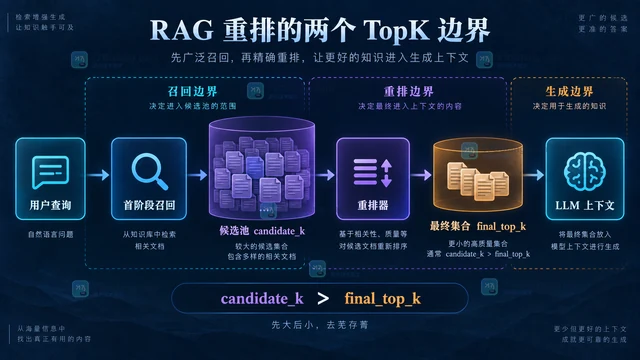 RAG 重排不要用同一个 TopK 同时控制召回和上下文。本文给出 candidate_k 与 final_top_k 的起始范围、三组评估指标、调参顺序和可直接落地的 Python 示例。468 收藏
-
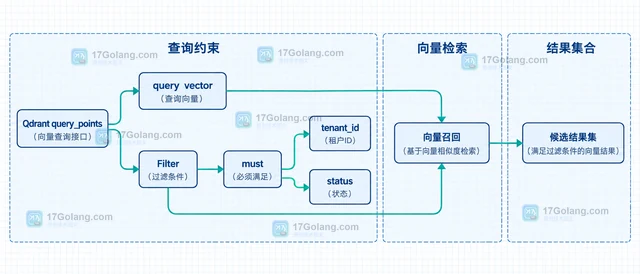 向量检索不应把租户、文档类型等硬约束交给 embedding 猜测。本文以 Qdrant 为例,把过滤字段写入 payload、提前建立 payload index,再用 Filter 绑定向量召回,并说明应用层后置筛选、字段选择性和索引成本的边界。467 收藏
-
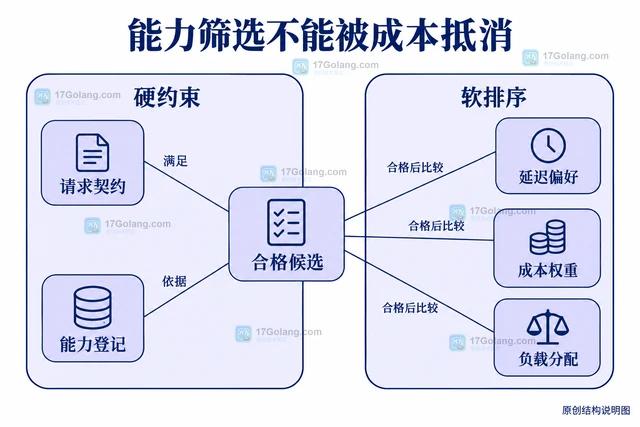 AI 网关应先按输入模态、工具、结构约束及业务允许范围过滤候选,再比较延迟和成本。本文说明端点能力登记、路由策略与故障回退边界,避免降级时丢失原请求语义。467 收藏
-
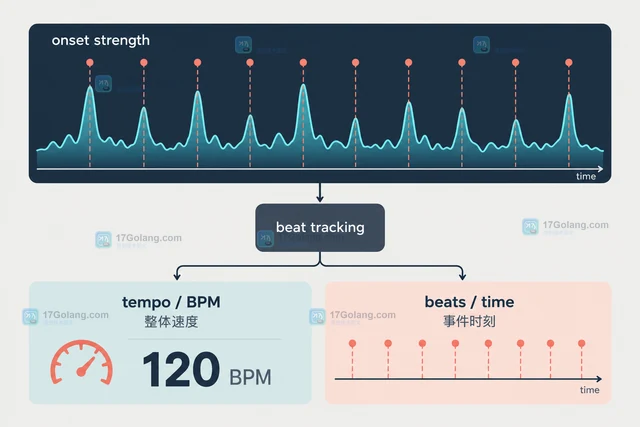 librosa beat_track 返回的 tempo 是速度估计,beats 是节拍事件位置。本文用实际调用拆解两者的单位、稀疏表示、时变 BPM 和常见误判,帮助你把节拍正确对齐到秒或帧。467 收藏
-
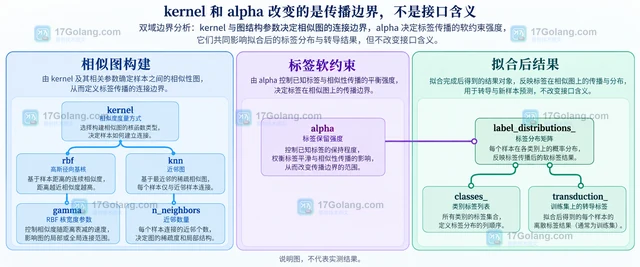 LabelSpreading 的 transduction_ 是 fit 阶段整张训练图上的传导标签,predict 与 predict_proba 则用于拟合后新样本的归纳式推断。本文按样本范围、接口、参数和上线检查清楚区分三者。467 收藏
-
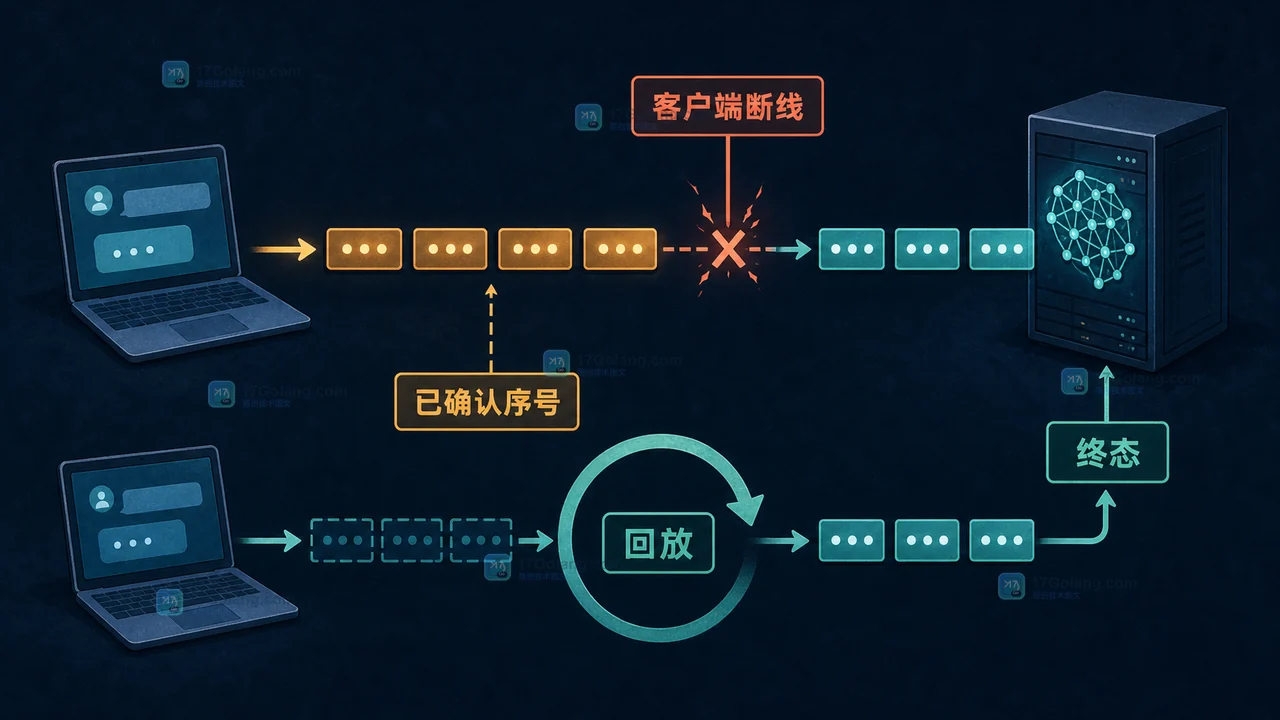 从首字延迟 TTFT、分段间隔和客户端断线三个信号入手,搭建大模型流式输出的观测口径,并给出 Go 服务端记录与回放验收方法。466 收藏