
人工智能技术文章
-
 把 AI 接口从普通聊天模型切到推理模型时,max_tokens 不是简单改个字段名。本文从请求兼容、推理 token 预算、截断判断和回滚核对四个方面,给出一套可复用的迁移检查方法。464 收藏
-
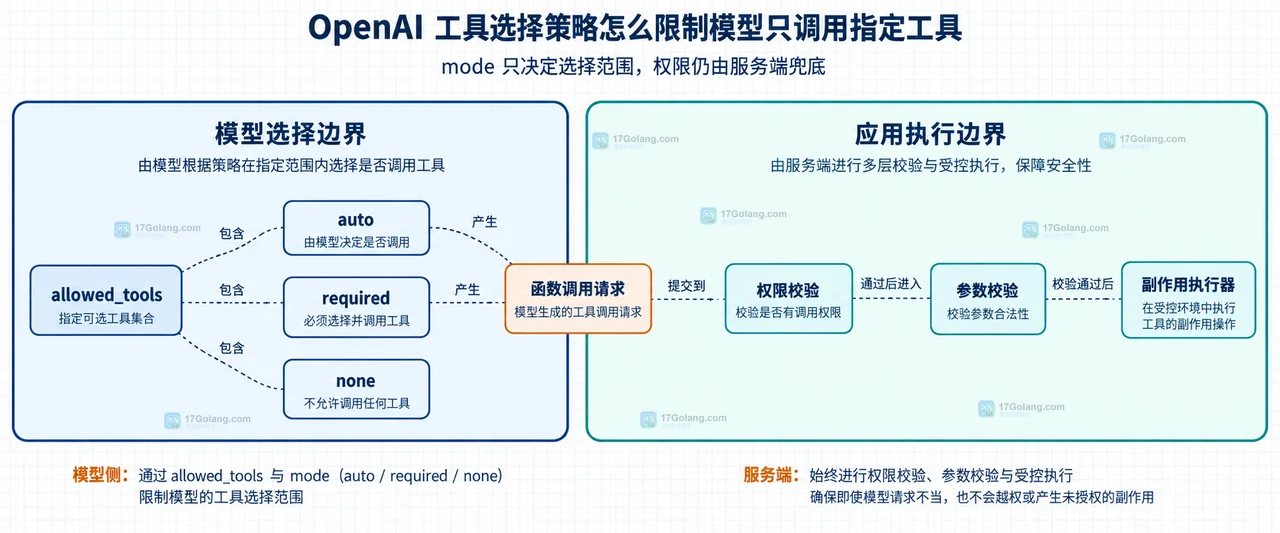 Responses API 同时声明多个函数工具时,可用 tool_choice 的 allowed_tools 将当前轮次限制到指定子集,再用 auto、required 或 none 表达调用策略。本文给出参数结构、选择边界和服务端安全检查。463 收藏
-
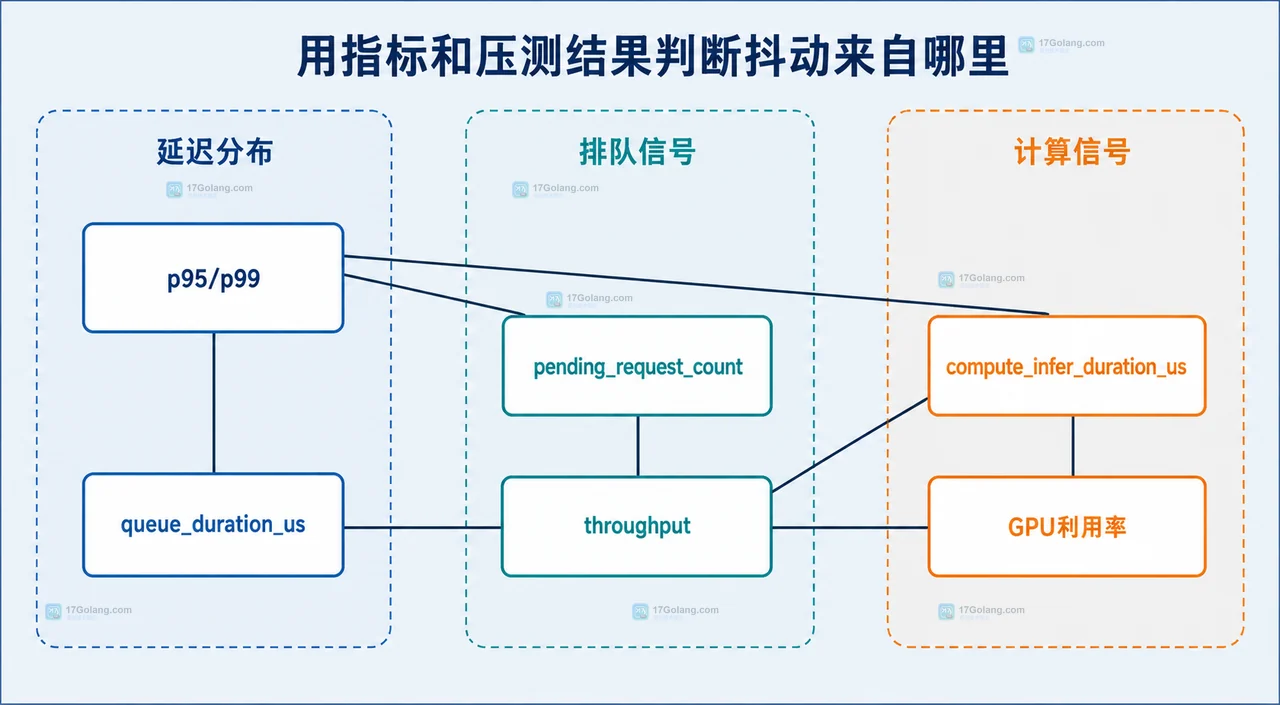 AI 推理服务的 p95、p99 延迟突然抖动时,不要只看 GPU 利用率。本文用请求、排队、输入处理、模型计算和输出处理的分段指标,结合并发与吞吐变化,判断瓶颈究竟在调度排队还是模型计算。462 收藏
-
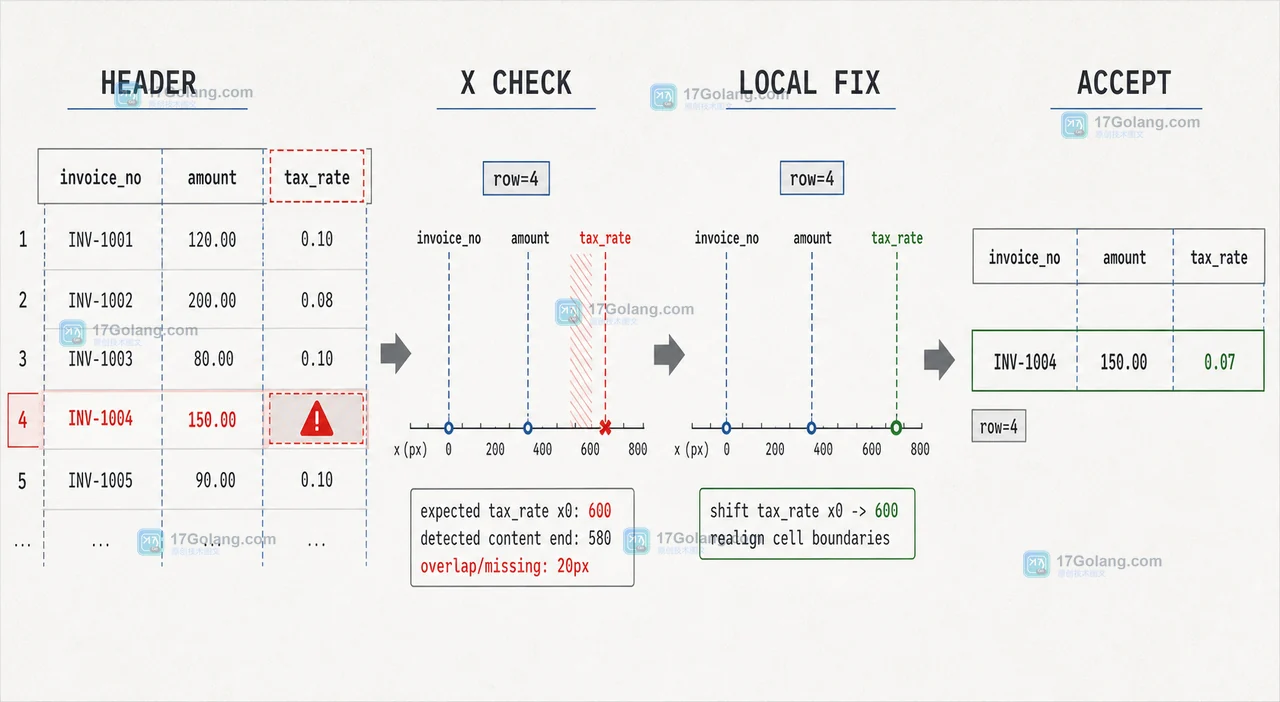 多模态模型识别扫描表格时,漏列通常不是模型单点失误,而是图像缩放、表格线、列坐标和结构化输出共同造成的。本文给出一套从输入预处理到坐标复核、局部纠错和结果验收的实用流程。461 收藏
-
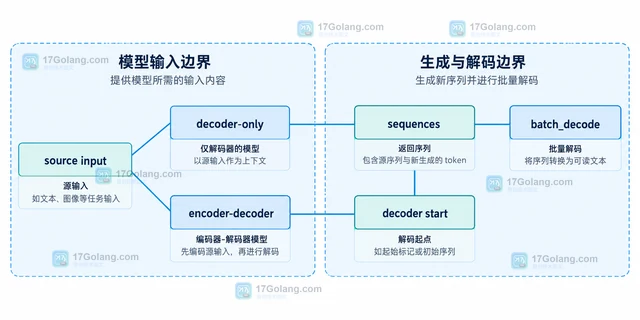 讲清 Transformers generate 返回完整序列的原因,分别处理 decoder-only 与 encoder-decoder 模型,用输入长度切出新生成 token,并给出批量解码、特殊 token 和空结果的处理方式。461 收藏
-
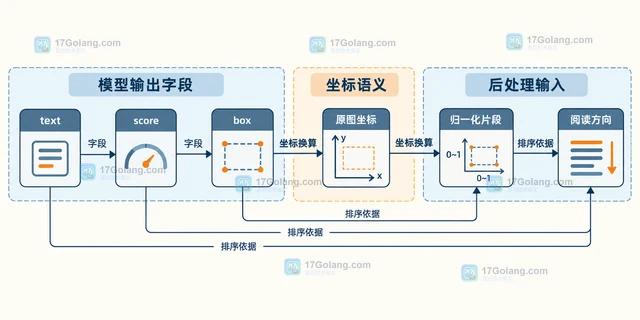 视觉模型返回的 OCR 片段常常不是阅读顺序。本文用统一坐标、垂直中心排序、动态行高阈值和行内 x 排序,把文字框稳定合并成可读文本,并说明多栏、竖排和低置信度结果的边界。461 收藏
-
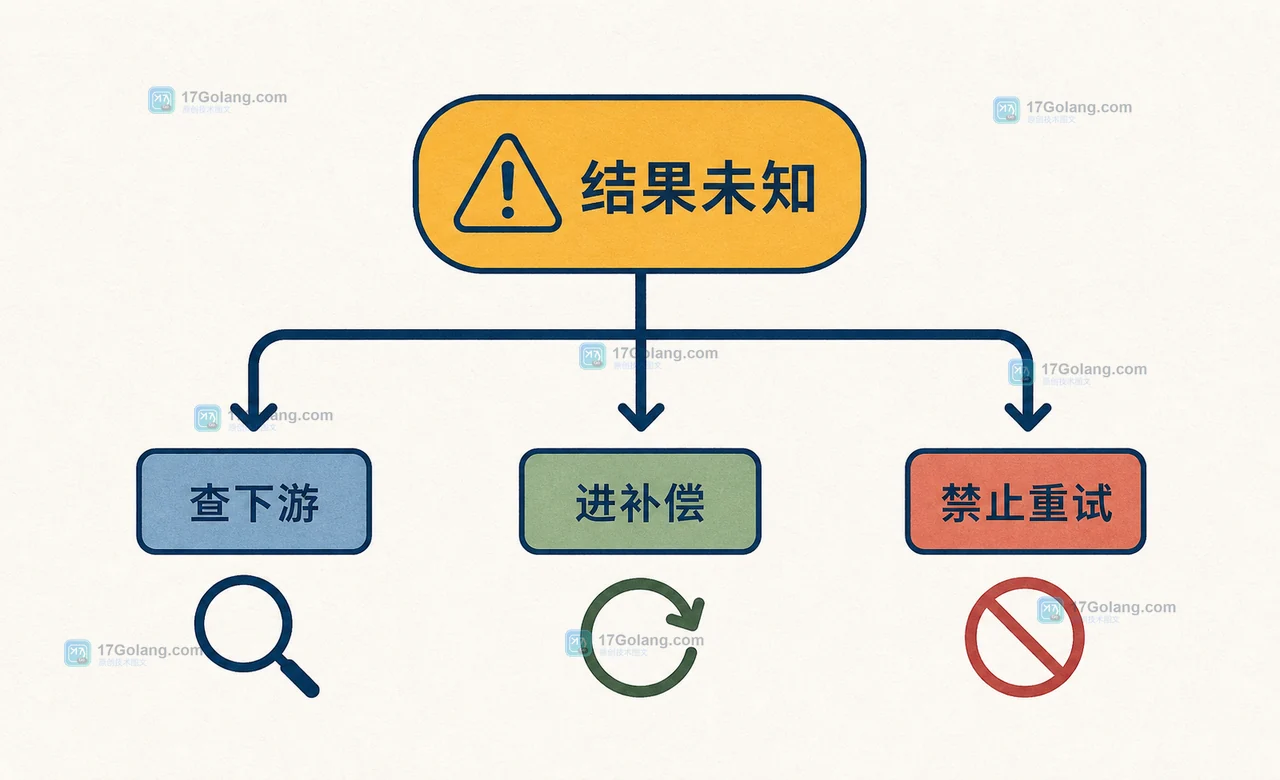 AI Agent 一轮工具调用可能已经改写库存、发送通知,却在最后一步返回超时。本文用订单履约场景拆开部分成功的状态记录、补偿动作和安全重试边界,给出可落地的验收清单。460 收藏
-
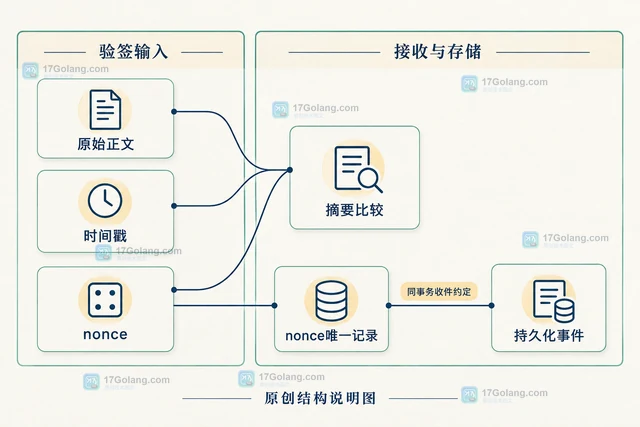 Label Studio 普通 webhook 可配置认证头,动态 HMAC 需另行实现。本文区分标注创建与任务完成,给出自建中继签名约定、原始正文校验及防重放与持久化边界。459 收藏
-
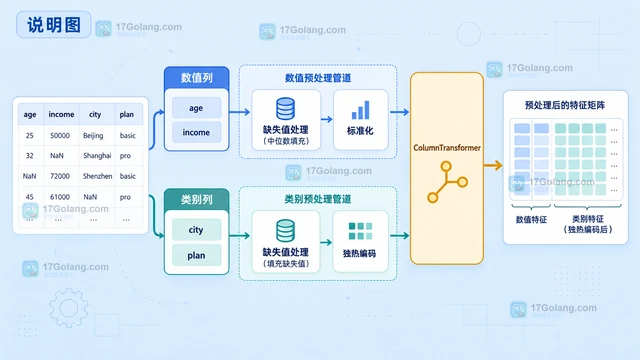 用 scikit-learn ColumnTransformer 把数值列与类别列分开处理:数值列填补并标准化,类别列填补并独热编码,再统一接入 Pipeline,避免列遗漏、未知类别和数据泄漏。459 收藏
-
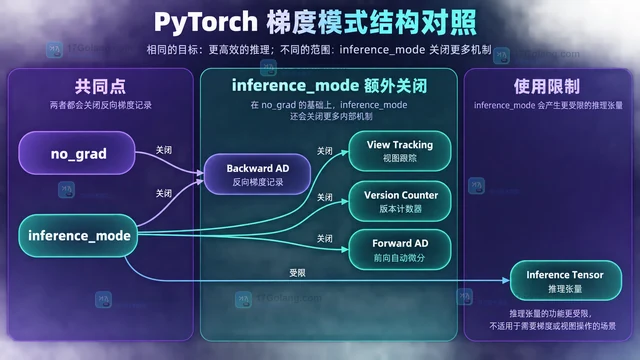 no_grad 关闭反向梯度记录且更宽松;inference_mode 进一步关闭视图追踪、版本计数器更新与 forward-mode AD,但推理张量不能进入后续 autograd 计算。本文给出选择表和安全写法。458 收藏
-
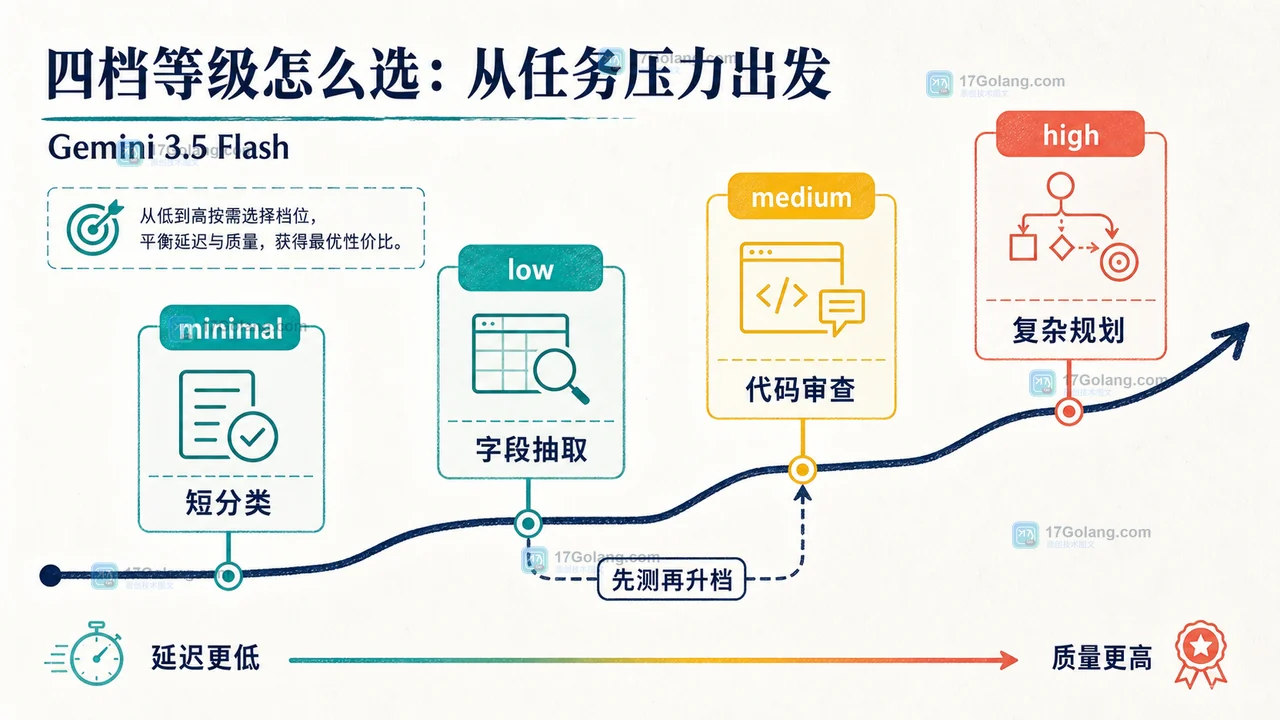 Gemini 3.5 Flash 已建议用 thinking_level 替代 thinking_budget。本文用同一组请求对比 minimal、low、medium、high,说明迁移写法、选档边界与回归检查。457 收藏
-
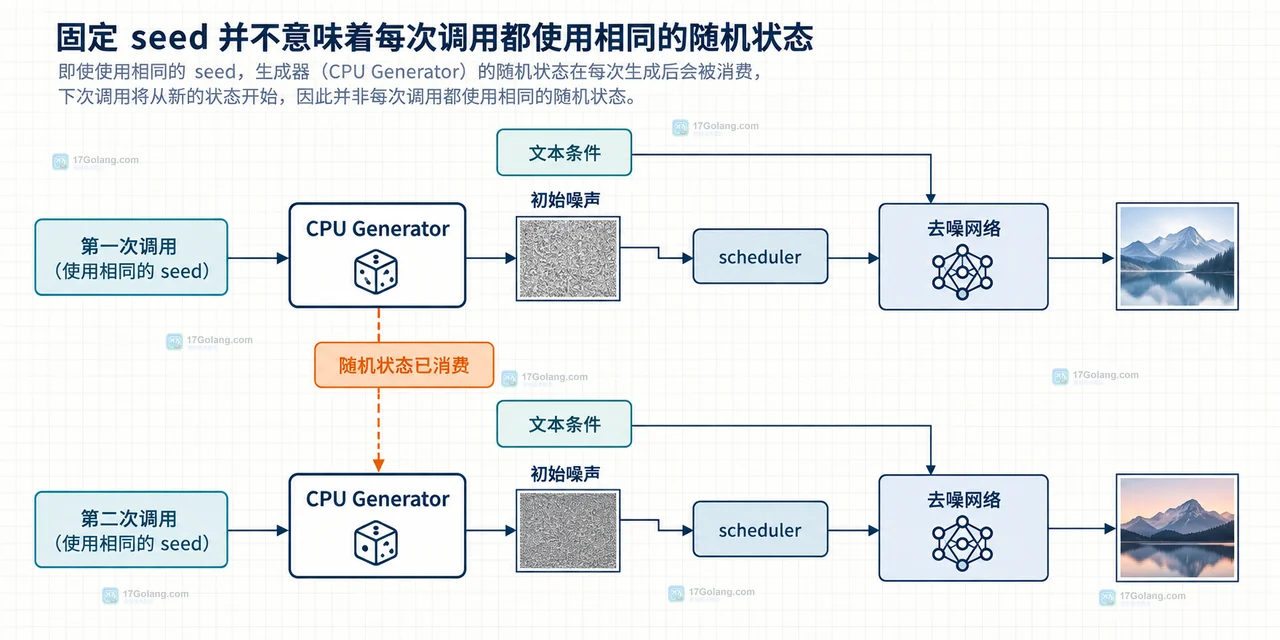 扩散模型固定 seed 仍有细节差异,通常不是 seed 失效,而是 Generator 状态、scheduler、精度、CUDA 后端和硬件不同。本文给出一套可复现排查清单。457 收藏
-
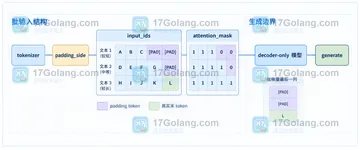 Transformers 批量生成时,padding_side 配错会让 decoder-only 模型把补齐 token 当成生成起点。本文用 input_ids、attention_mask 和 generate 的关系说明 left padding 的配置方法、pad_token 处理与回归检查边界。457 收藏
-
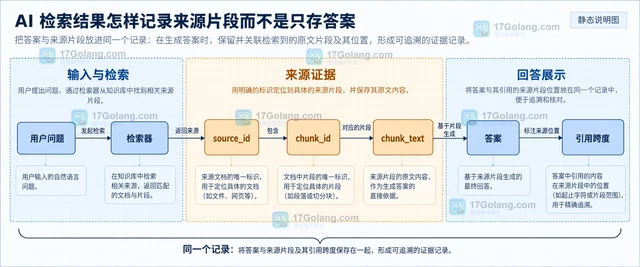 AI 应用不要只保存最终答案。本文用检索增强的常见数据模型说明如何保存 source_id、chunk_id、chunk_text、回答片段和支持关系,并结合 Gemini groundingMetadata 的 groundingChunks 与 groundingSupports 设计可追溯记录。456 收藏
-
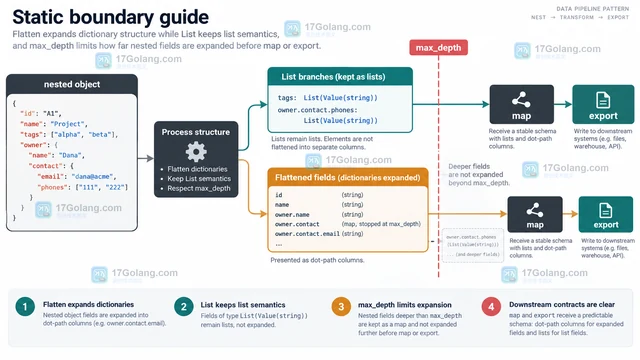 Hugging Face Datasets 的 flatten 会把嵌套字典字段展开为点号路径列,同时保留 Features 对字段类型的描述。本文用嵌套 struct、List 和 max_depth 说明如何安全接入后续 map 处理。455 收藏