
人工智能技术文章
-
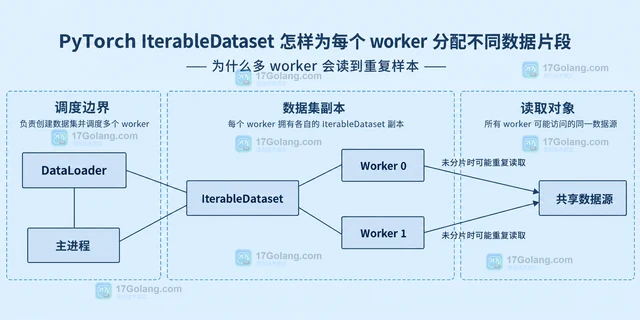 使用 PyTorch IterableDataset 配合 DataLoader 多 worker 时,数据集对象会复制到各个进程,直接迭代容易读到重复样本。本文用 get_worker_info 在 __iter__ 中计算半开区间,说明不整除、尾部数据和 drop_last 的边界。455 收藏
-
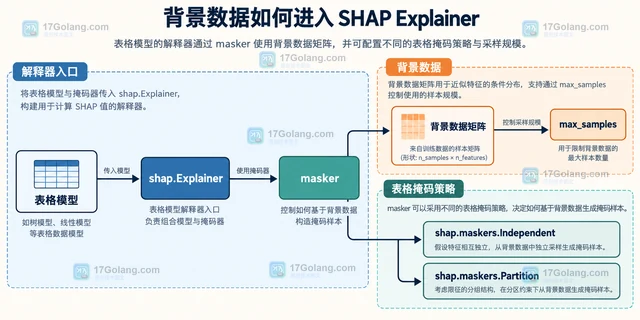 SHAP Explainer 可以用 NumPy 数组或 pandas DataFrame 作为表格背景数据。本文比较 Independent 与 Partition 的遮罩假设,说明 max_samples、特征相关性和字段一致性如何影响解释基线,并给出可直接改造的初始化代码。455 收藏
-
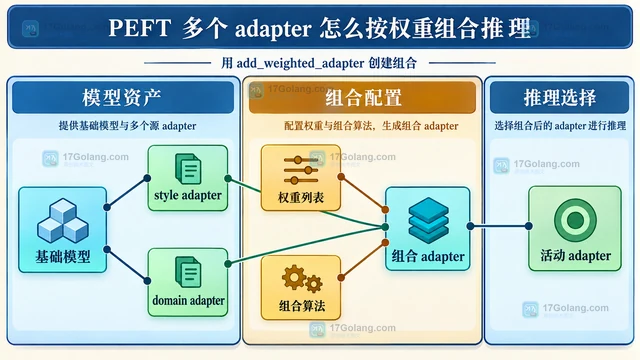 本文演示 PEFT 多个 LoRA adapter 的命名加载、加权组合与推理激活,说明 linear、cat、SVD、TIES 和 DARE 的选择边界及评测方法。454 收藏
-
科技周边 · 人工智能 | 3星期前 | 缓存 · 人工智能 · 提示词工程 · 提示词缓存 cache_control Prompt Caching 静态前缀 cache_read_input_tokens
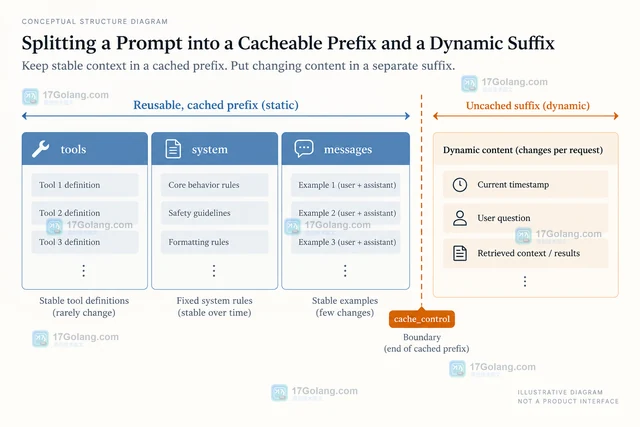 提示词缓存命中率低时,先把工具定义、系统规则和稳定上下文划为前缀,把时间戳、用户问题和检索结果留在后缀,再用 usage 字段判断断点、TTL、长度门槛和并发时序问题。453 收藏
-
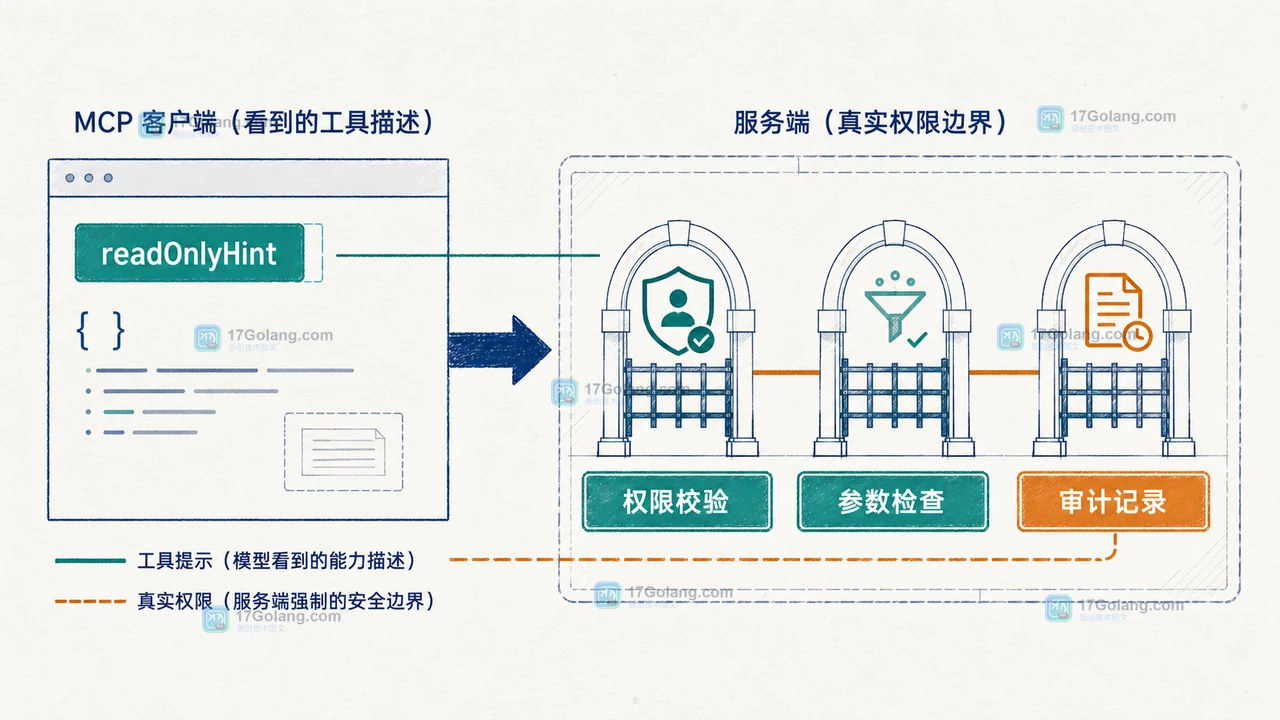 MCP 工具注解能帮助客户端理解工具是否只读、是否可能破坏环境、重复调用是否幂等以及是否访问开放世界,但它们只是提示而非权限系统。本文给出从服务端声明到客户端审批的安全验收清单。452 收藏
-
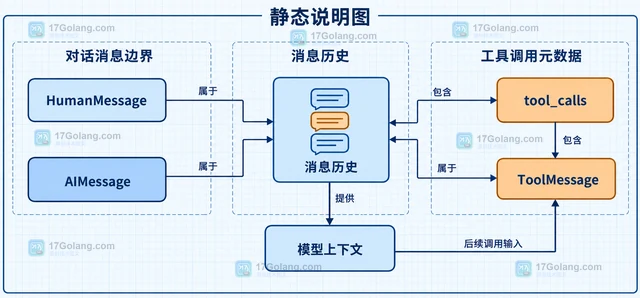 LangChain 工具调用需要保留完整 messages,而不是只取最终文本。本文说明 AIMessage、ToolMessage、tool_call_id、content 与 artifact 的关系,以及如何保存中间消息并继续交给模型。450 收藏
-
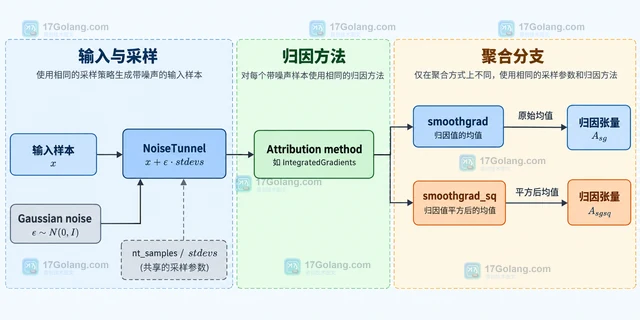 Captum NoiseTunnel 的 SmoothGrad 与 SmoothGradSquared 都会对加噪输入重复计算归因,但前者聚合原始归因均值,后者聚合平方后的归因均值。本文用公式、代码和选型表说明符号、强度与参数边界。450 收藏
-
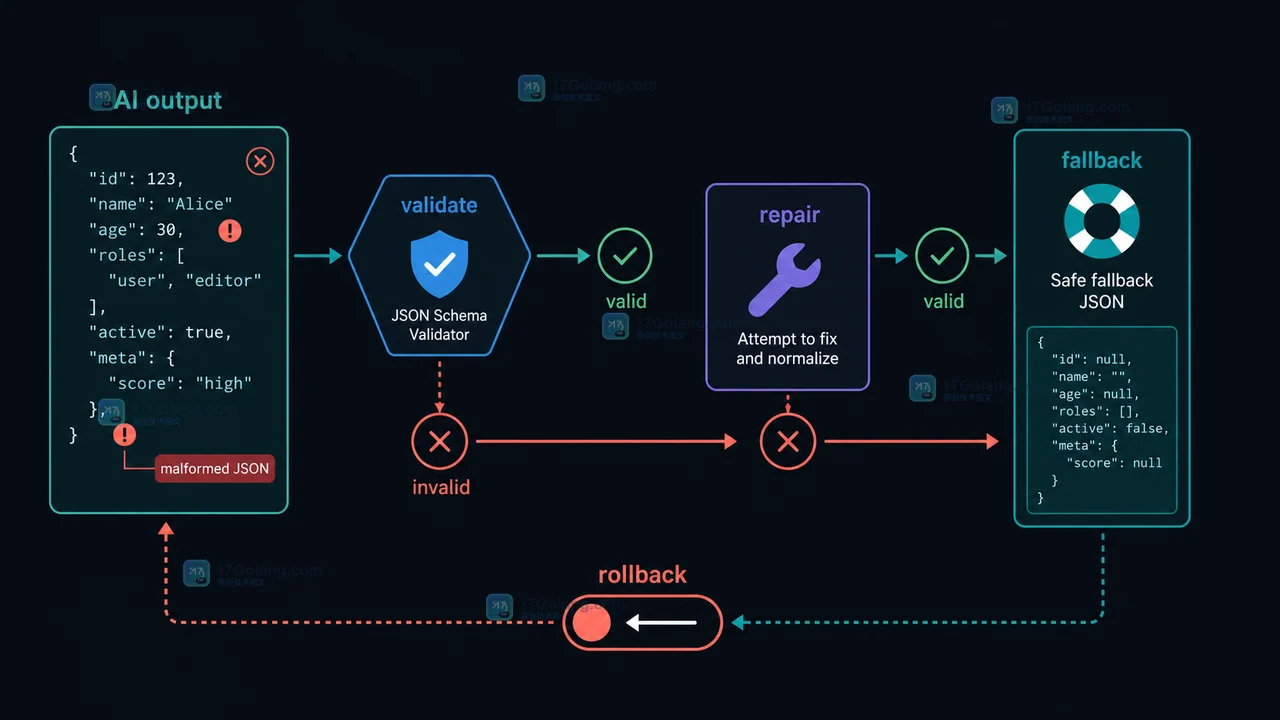 面向需要稳定输出的 AI 应用,梳理 JSON Schema 版本兼容中的新增字段、枚举收缩、校验失败与回滚策略。449 收藏
-
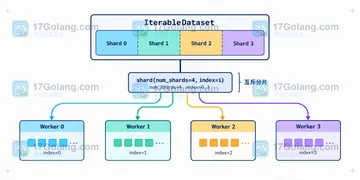 Hugging Face Datasets 开启 streaming 后会返回 IterableDataset。本文用 take、skip 和 shard 解释连续取样、并行分片的差异,以及 shuffle 顺序和性能边界。449 收藏
-
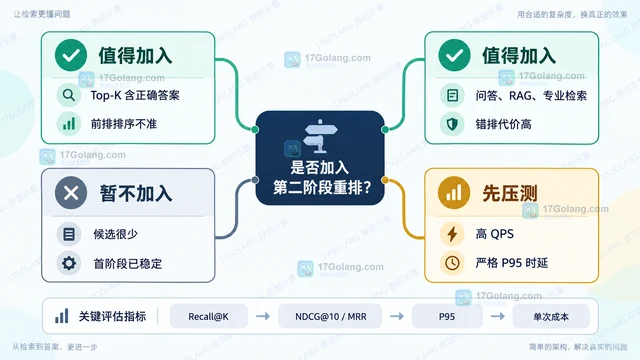 语义检索是否需要第二阶段重排,关键不在模型更强,而在第一阶段已能召回正确文档、前排仍错序且业务能承担额外时延。本文用 Recall@K、NDCG/MRR、P95 和单次成本给出决策与实现方法。449 收藏
-
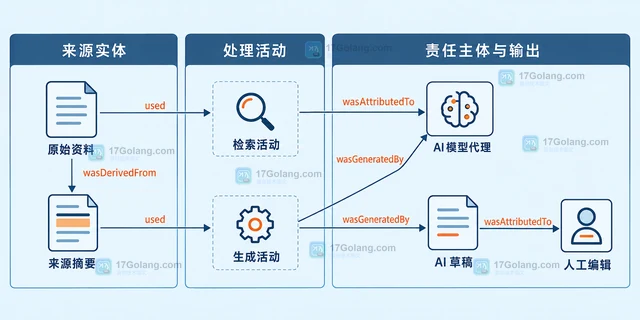 AI 生成内容要可追溯,关键不是只保存最终答案,而是把来源实体、检索与生成活动、模型和人工角色拆开记录,再用稳定 ID 串成可查询的引用链。448 收藏
-
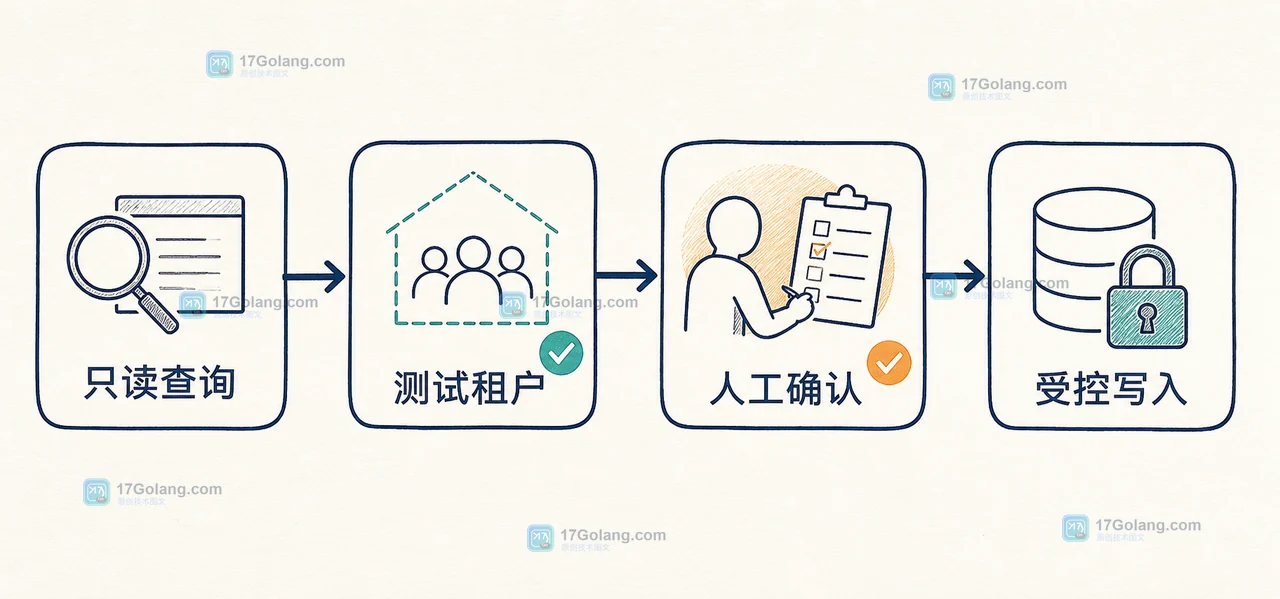 远程 MCP 服务器让 AI 应用可以连接外部数据和工具,但接入前必须核对来源、工具权限、读写范围与撤销路径。本文给出一份不依赖具体厂商的上线前检查清单。447 收藏
-
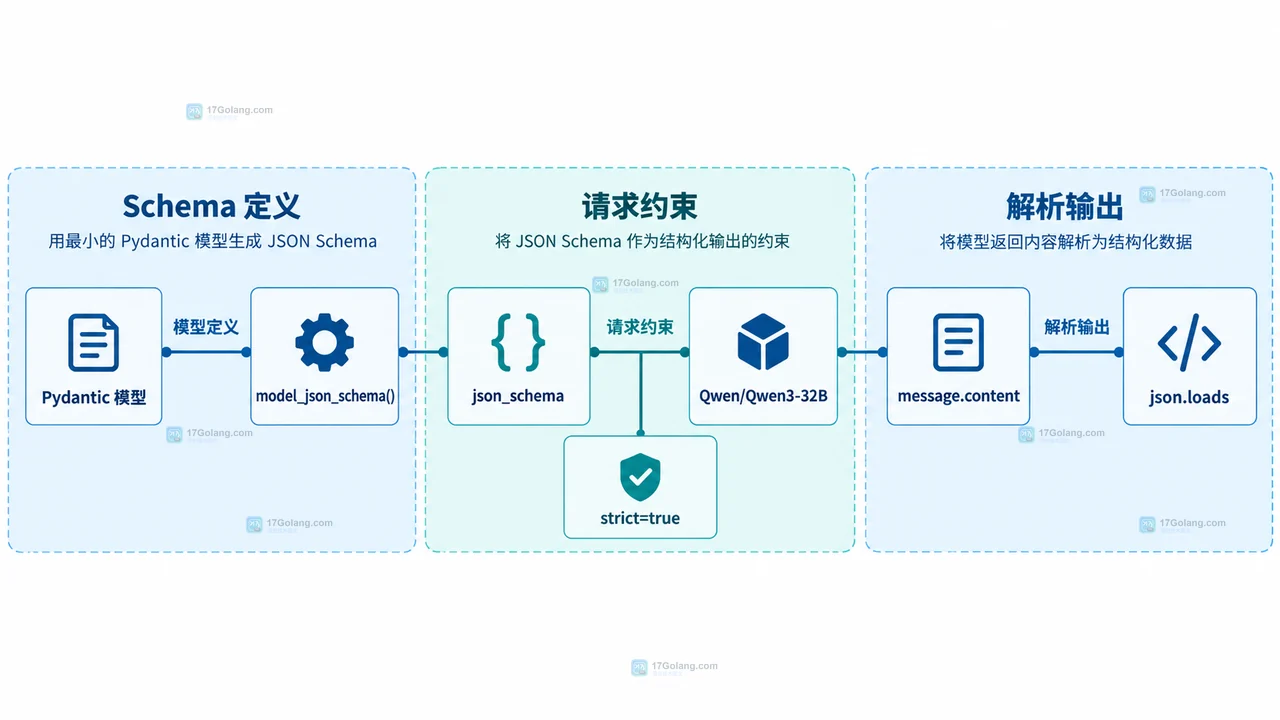 以 Hugging Face InferenceClient 为例,拆解结构化输出失败的三层原因,用最小 JSON Schema 和检查清单快速定位配置、模型兼容性与解析问题。447 收藏
-
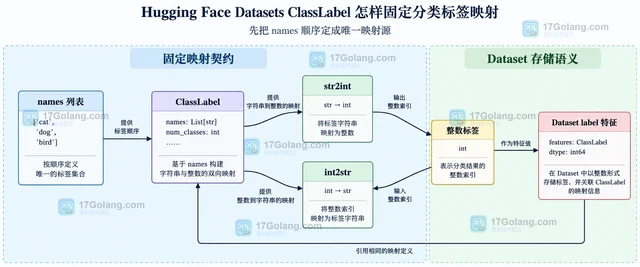 Hugging Face Datasets 的 ClassLabel 不应根据每个数据切片临时推导。本文用固定 names 顺序统一训练、验证和推理标签,并说明 map、cast_column、names_file、int2str 与 str2int 的边界。447 收藏
-
 向量检索召回低时不要盲目更换嵌入模型。本文用固定评测集、Recall@k 和命中排名,分别拆分切片、嵌入模型与召回阈值问题。446 收藏