
人工智能技术文章
-
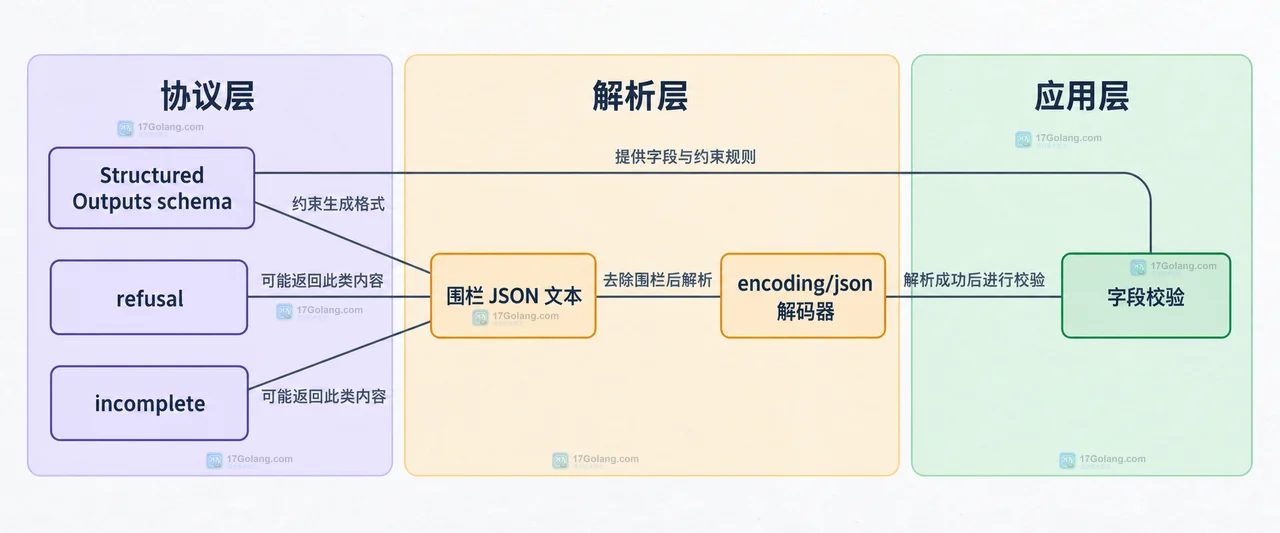 模型输出 JSON 偶尔带有 Markdown 围栏时,先判断拒答和截断状态,再只清理首尾围栏,最后用 encoding/json 解码并执行字段级业务校验。398 收藏
-
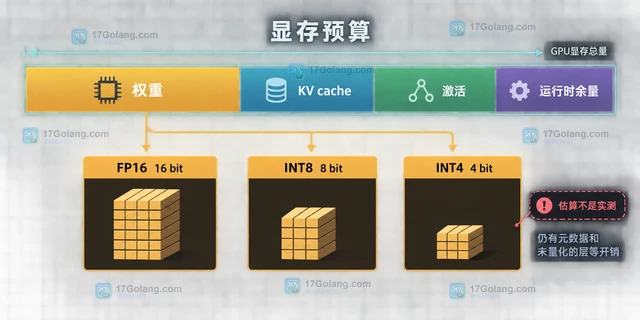 量化推理选精度不能只看模型参数量,还要扣除 KV cache、激活、运行时余量和量化元数据。本文用显存预算、位宽估算和 Transformers BitsAndBytesConfig,说明何时选择 FP16/BF16、INT8 或 INT4,并给出吞吐与质量的验证边界。398 收藏
-
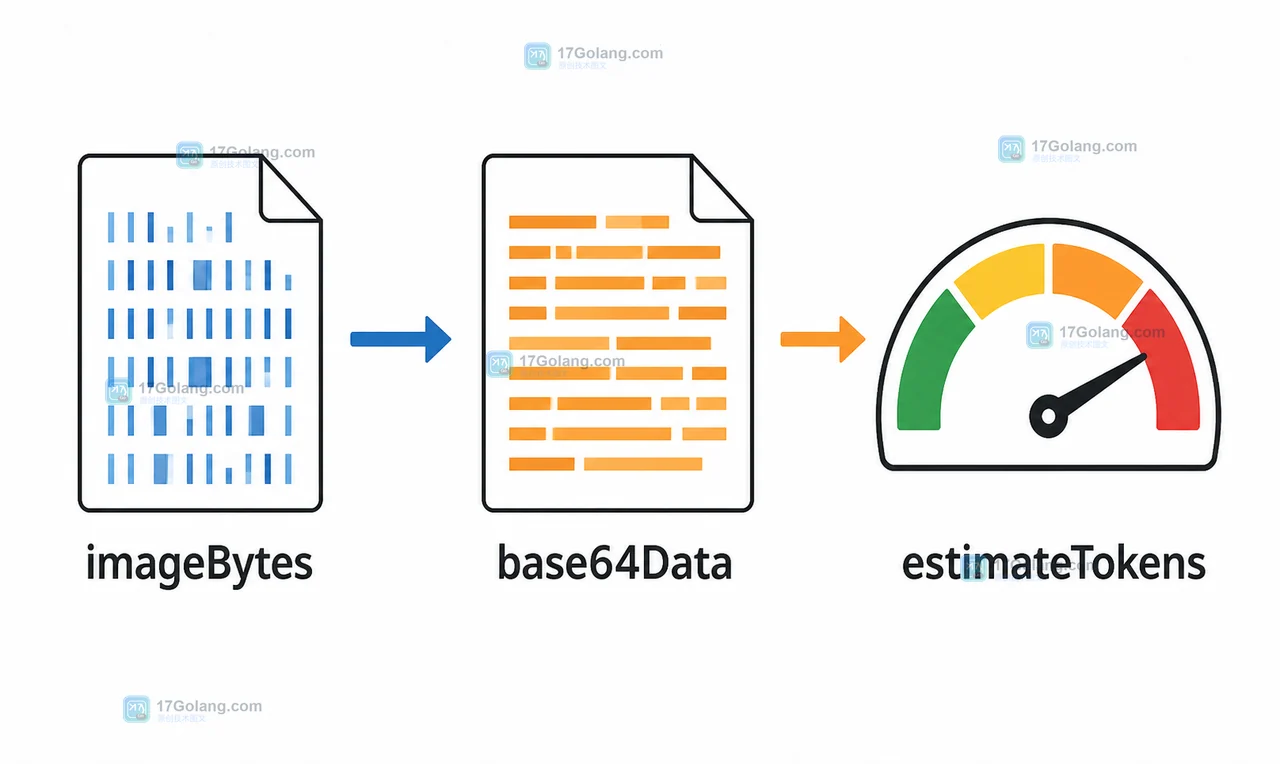 多模态接口接入后,小图片能成功,大图片却报请求过大或上下文超限。本文从原始字节、base64 膨胀和 token 预算三层定位问题,再给出压缩、尺寸校验与请求组装的可复现处理顺序。397 收藏
-
科技周边 · 人工智能 | 3星期前 | 人工智能 · 性能排查 · 提示词工程 · 提示词缓存动态字段 DynamicCache KV缓存 Transformers缓存 past_key_values use_cache StaticCache
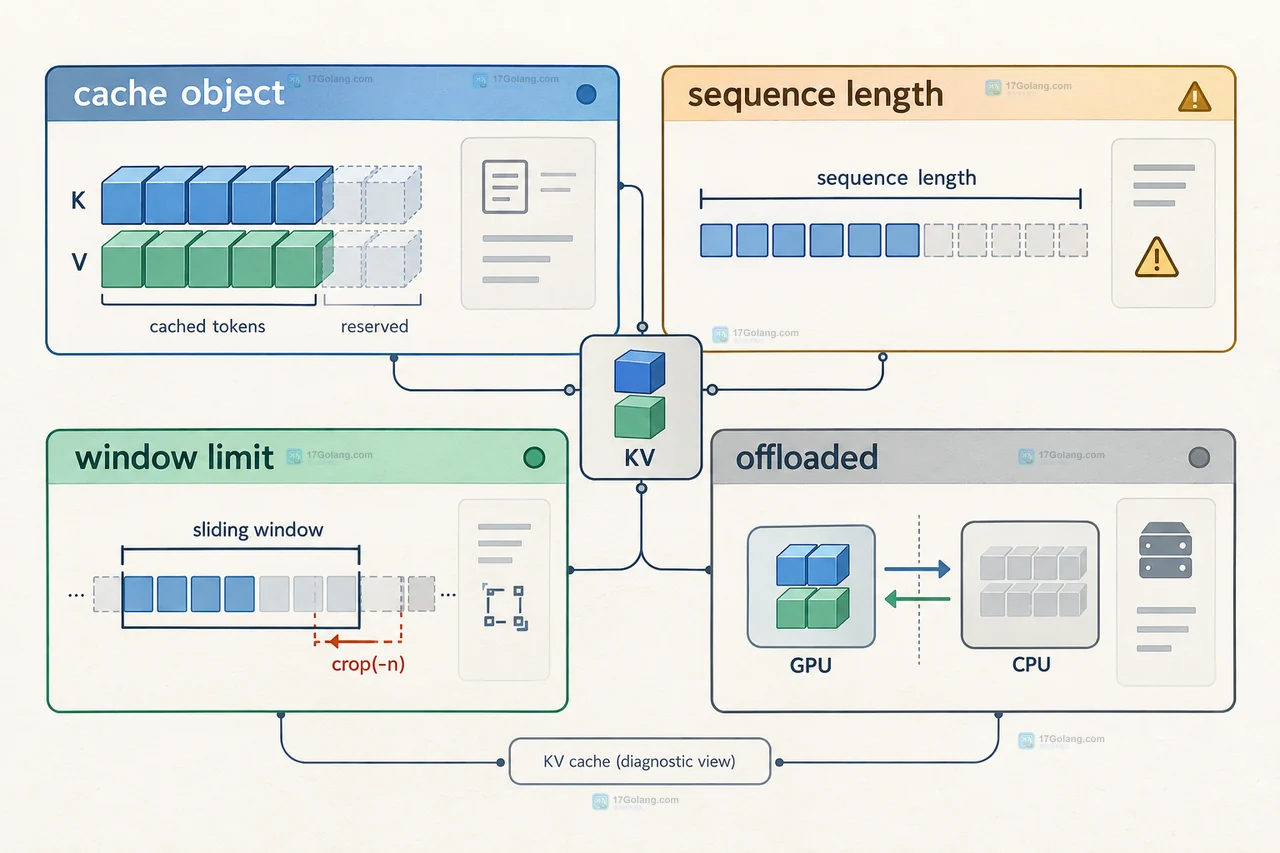 本文以 Hugging Face Transformers 的 DynamicCache 为例,说明提示词缓存动态字段的配置边界,覆盖 use_cache、past_key_values、迭代对话、窗口上限、回滚、显存排查以及切换 StaticCache 的判断方法。397 收藏
-
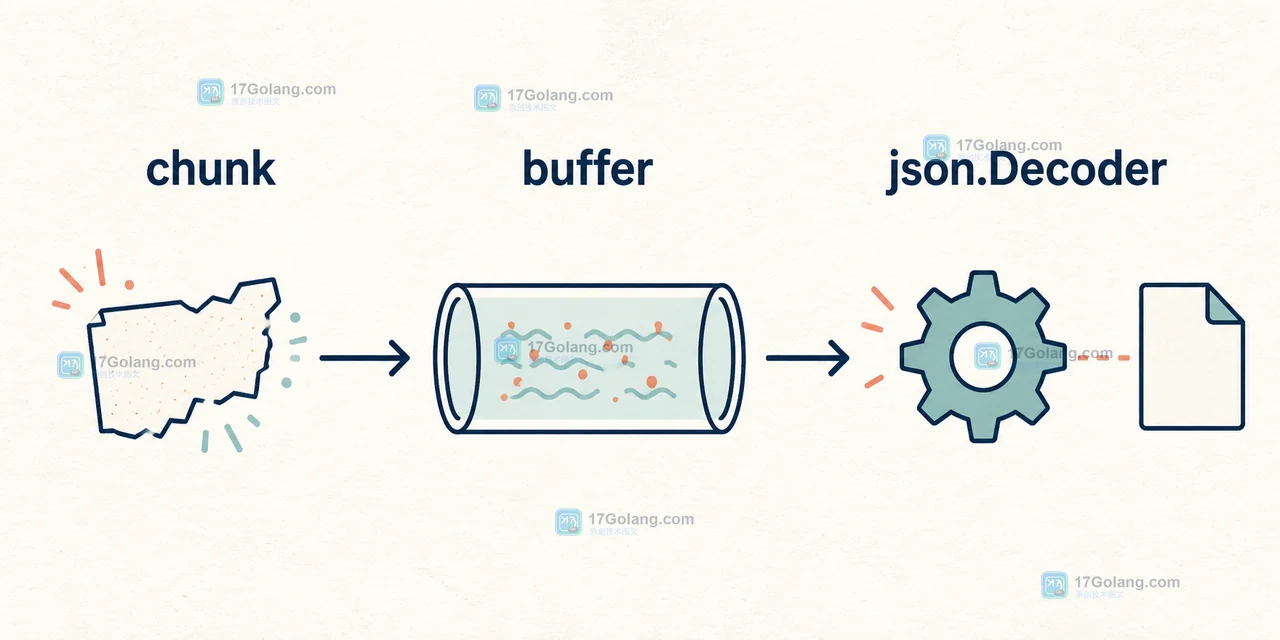 AI 接口采用流式输出后,JSON 可能被拆在多个数据块里,直接逐块反序列化会遇到半截对象和重复消费。本文用 Go 的缓冲区、边界扫描和字段完整性检查,构造一条可复现的流式解析链路。395 收藏
-
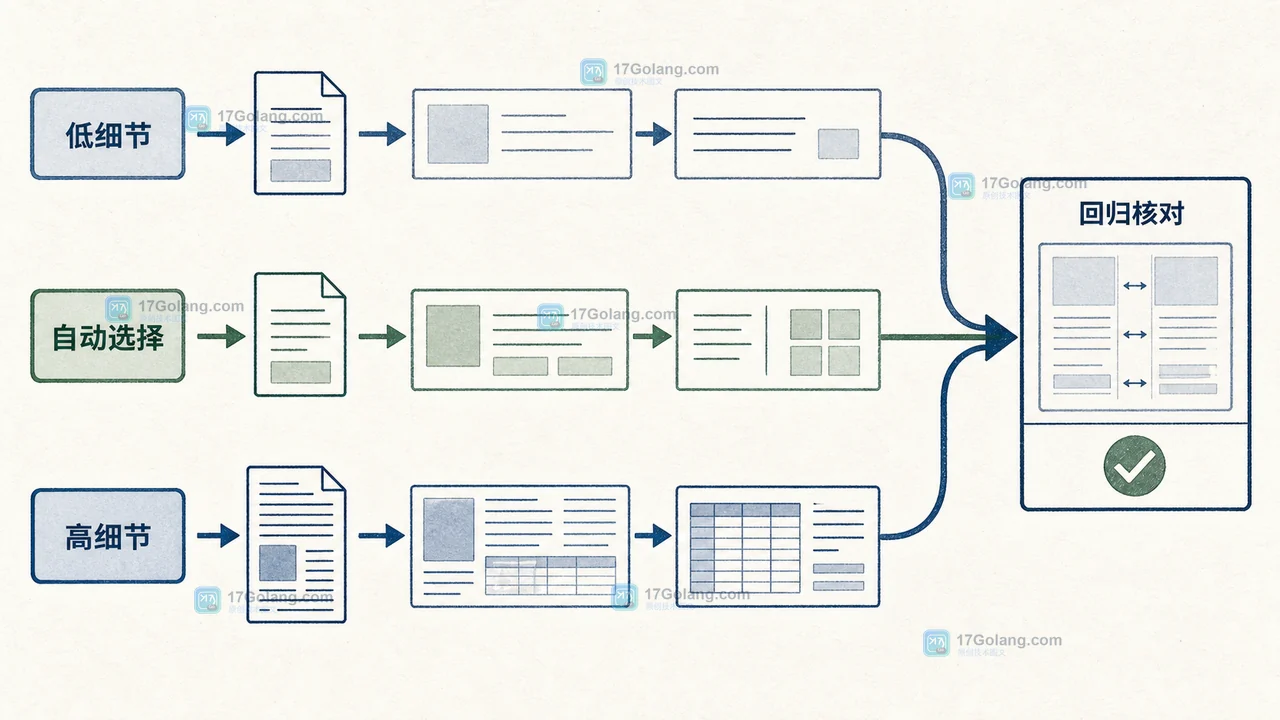 多模态知识库接入图片后,成本和延迟往往不是由文件大小单独决定。本文从图片任务、detail 级别、裁剪策略和上下文预算四个维度,给出可执行的输入分层与验收方法。394 收藏
-
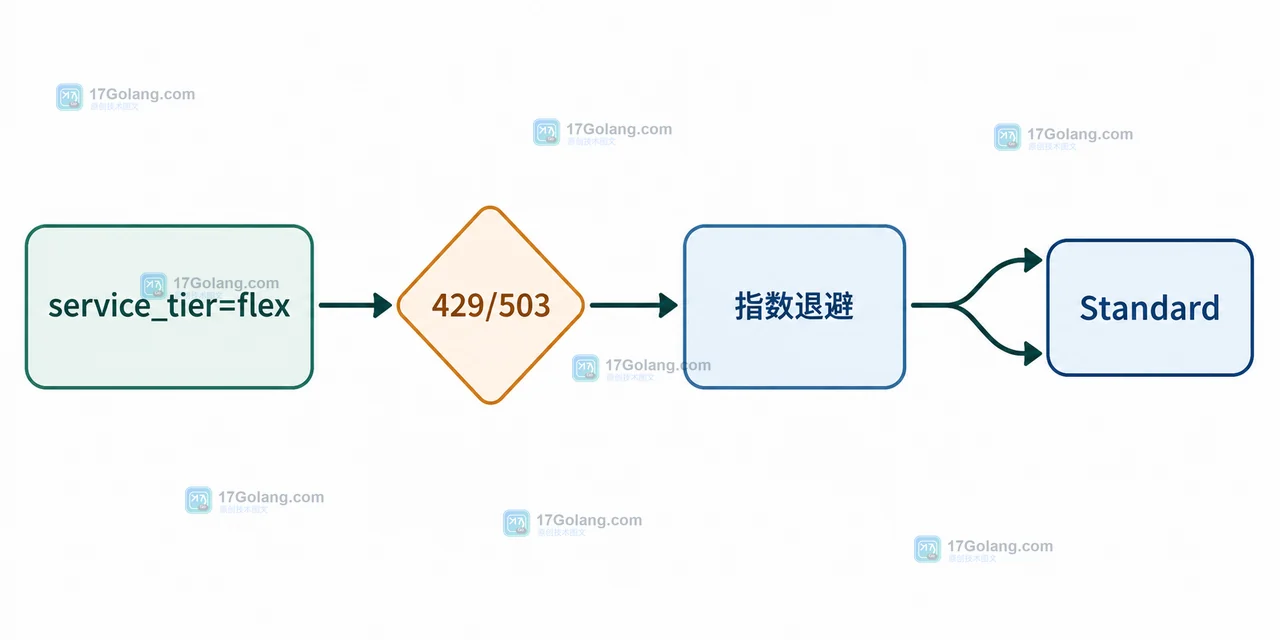 Gemini Flex inference 用标准价格的一半换取可让渡容量,适合不赶实时结果的评测、数据丰富和后台链路。本文用 service_tier=flex 的请求示例拆开 429、503、超时、重试和 Batch 的边界,避免把低价请求误接到用户关键路径。394 收藏
-
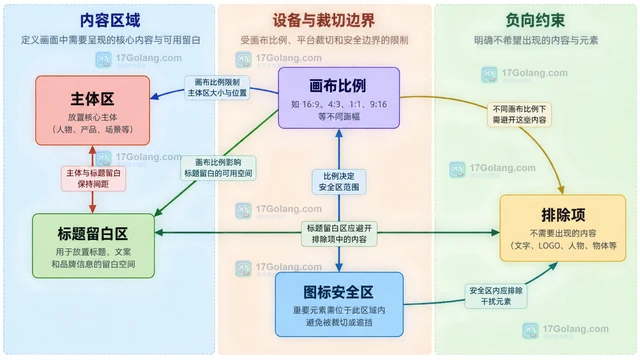 图像生成提示词不要只堆风格词。本文把任务目标、主体、位置、留白、画幅和排除项拆成可复用结构,说明如何让生成结果更贴近文章配图、海报或手机画布的版式要求。394 收藏
-
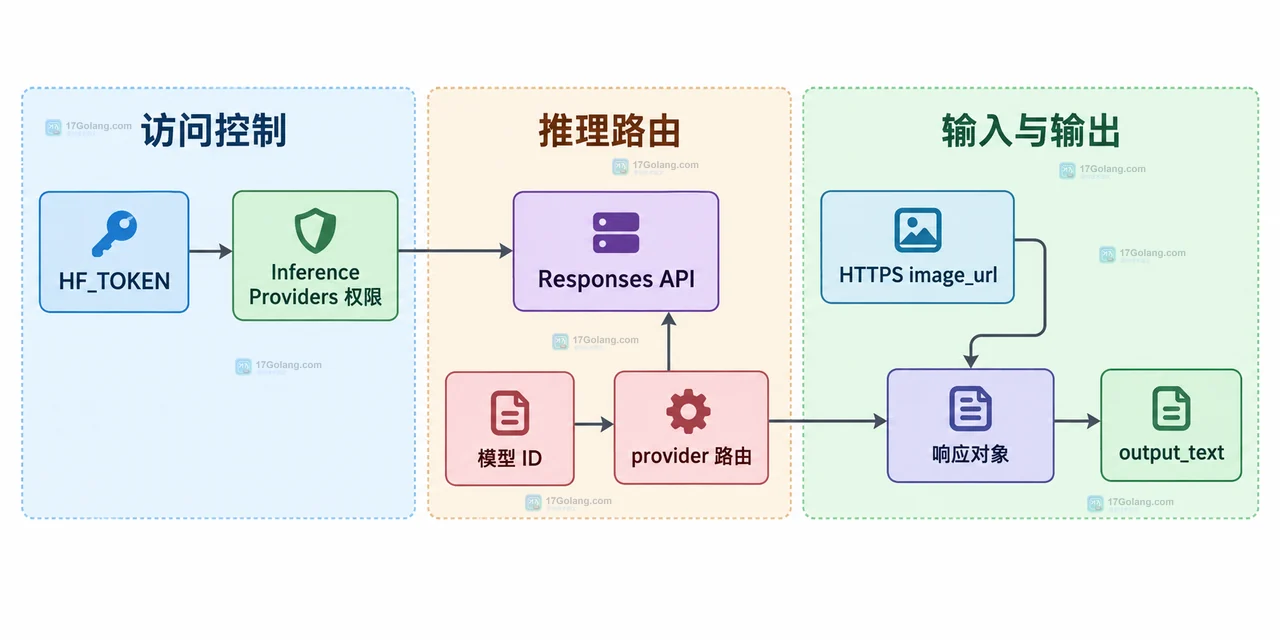 Hugging Face Responses API 可以在同一个 input 数组中组合 input_text 与 input_image。本文用 Python 和 OpenAI SDK 说明请求结构,并按令牌权限、模型路由、图片 URL 和输出字段拆解常见失败原因。392 收藏
-
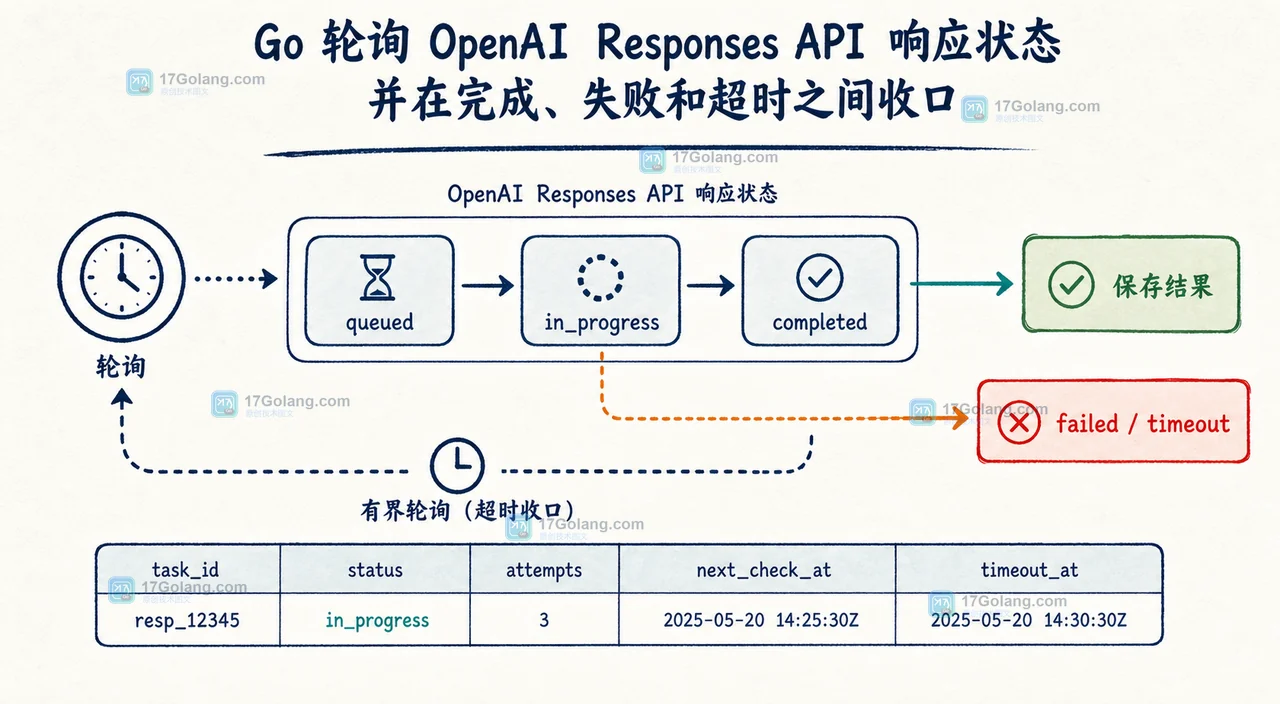 用 Go 接入 OpenAI Responses API 时,长推理或工具调用容易让同步 HTTP 请求撞上超时。本文从同步调用迁移到 background 模式,演示如何提交任务、按响应 ID 轮询、处理失败状态,并说明约 10 分钟保留窗口与 Zero Data Retention 的边界。388 收藏
-
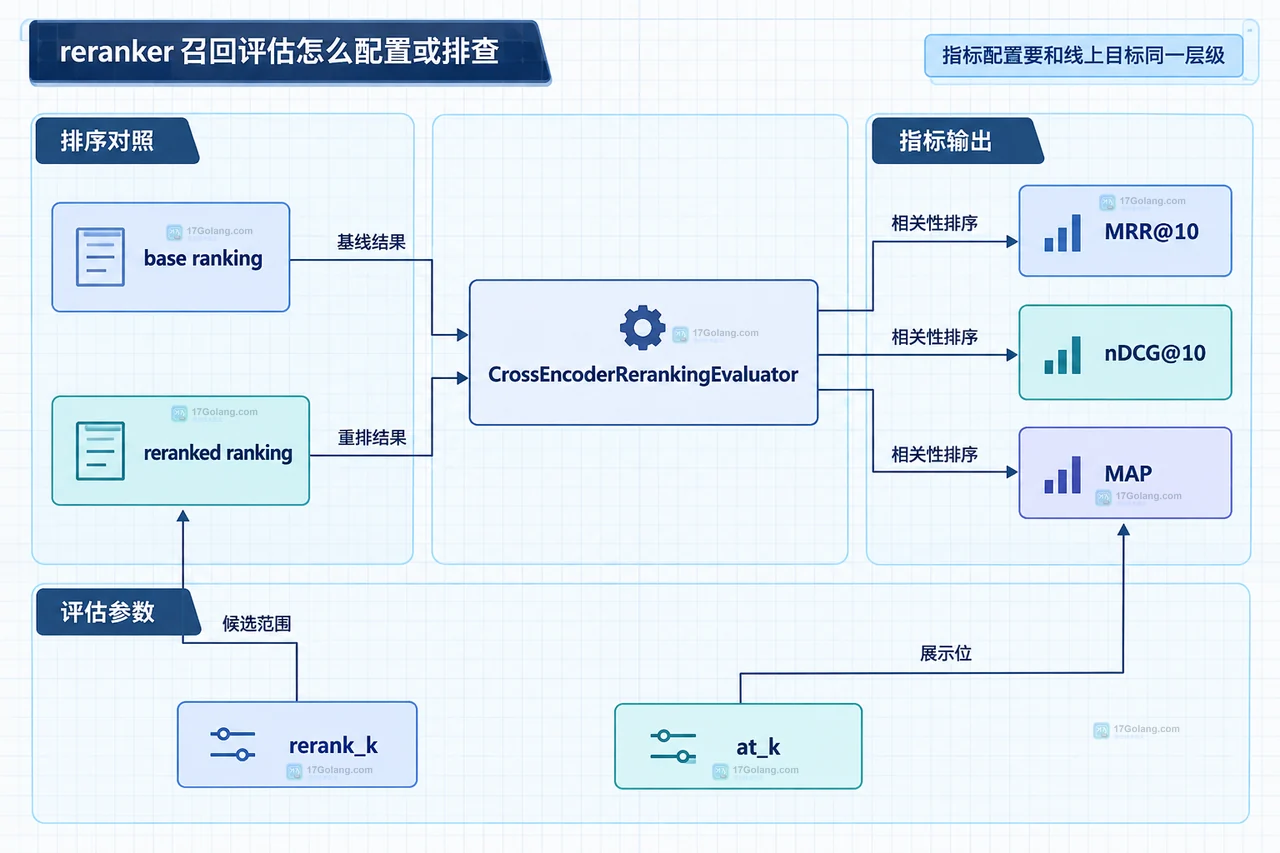 围绕真实初筛候选集配置 reranker 评估,说明 positive、negative、documents、candidate_k、rerank_k 的边界,并用 MRR@10、nDCG@10、MAP 对比基线与重排结果,定位召回、截断和分数解释问题。388 收藏
-
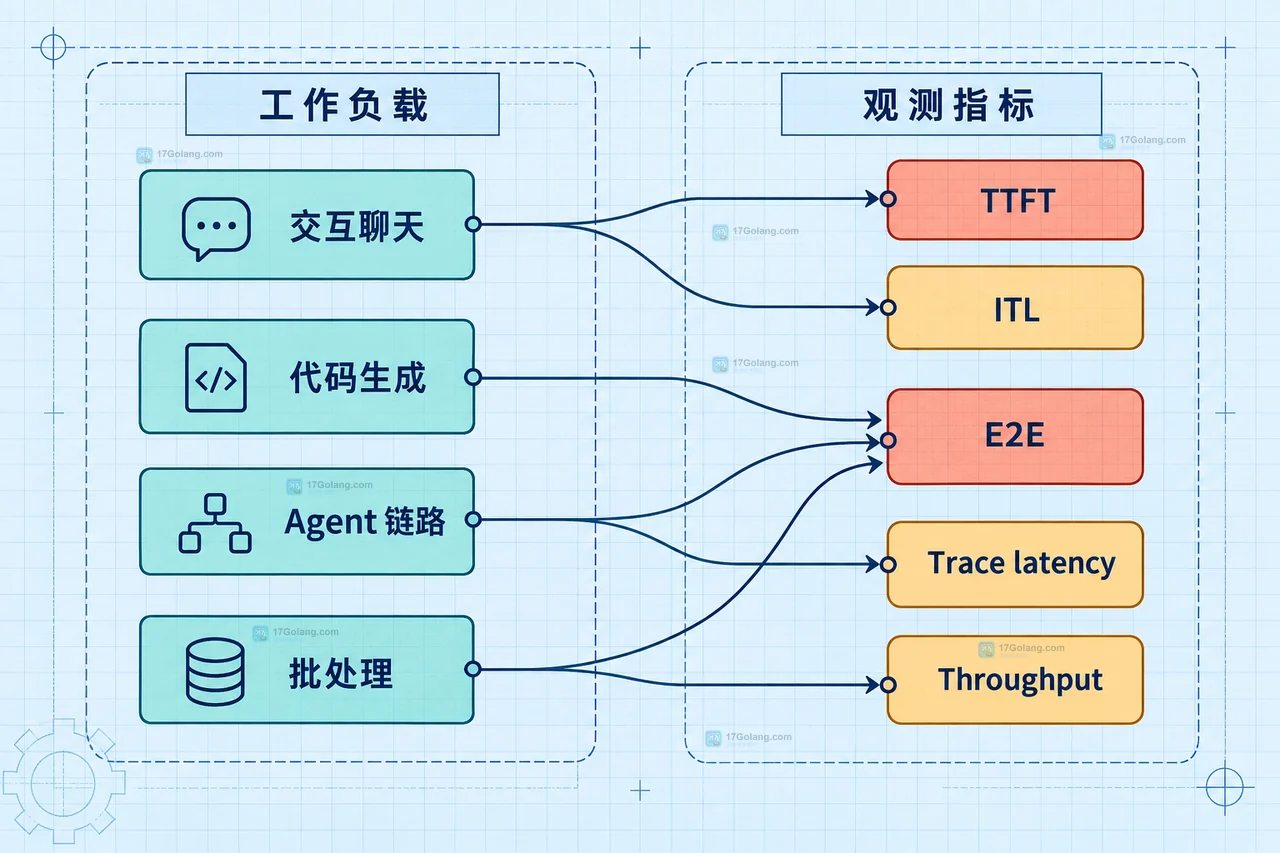 AI 推理延迟不能只看一个平均数:本文用 TTFT、TPOT/ITL 和端到端耗时拆开聊天、Agent、代码生成与批处理的观测口径,并给出排队、检索、prefill、decode 的定位方法。387 收藏
-
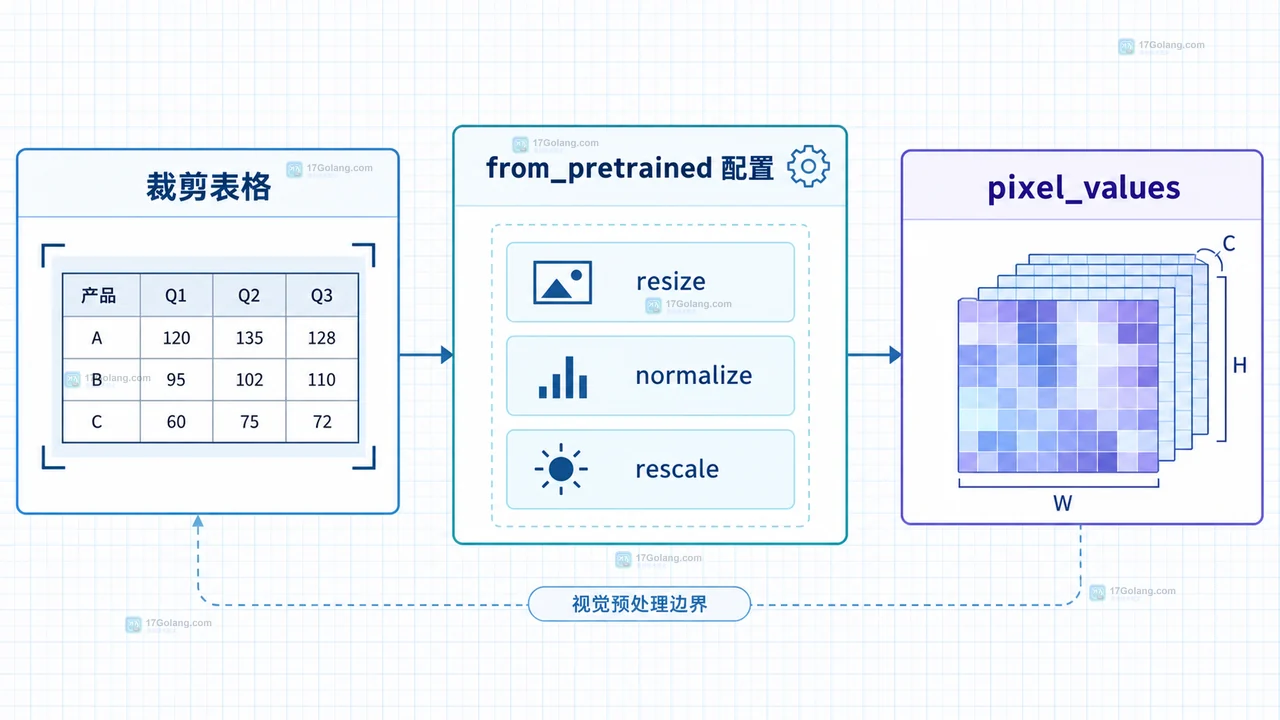 视觉表格识别前,先统一 xyxy 坐标、比例扩边和边界裁剪,再交给 Hugging Face image processor 做 resize、归一化等预处理。本文给出可复用代码和排查清单。387 收藏
-
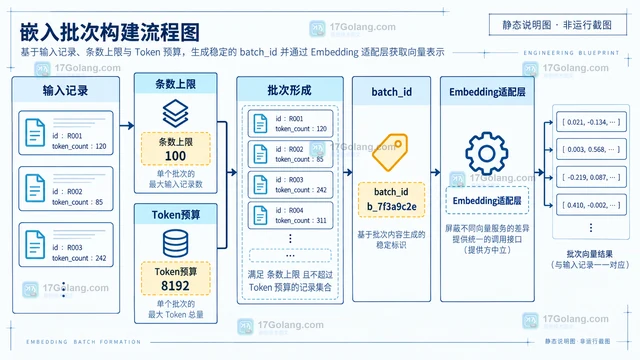 从批次边界、吞吐控制、错误分流和幂等写入四个层面,说明 Embedding 批量生成如何稳定处理长文本、429、超时和进程重启。387 收藏
-
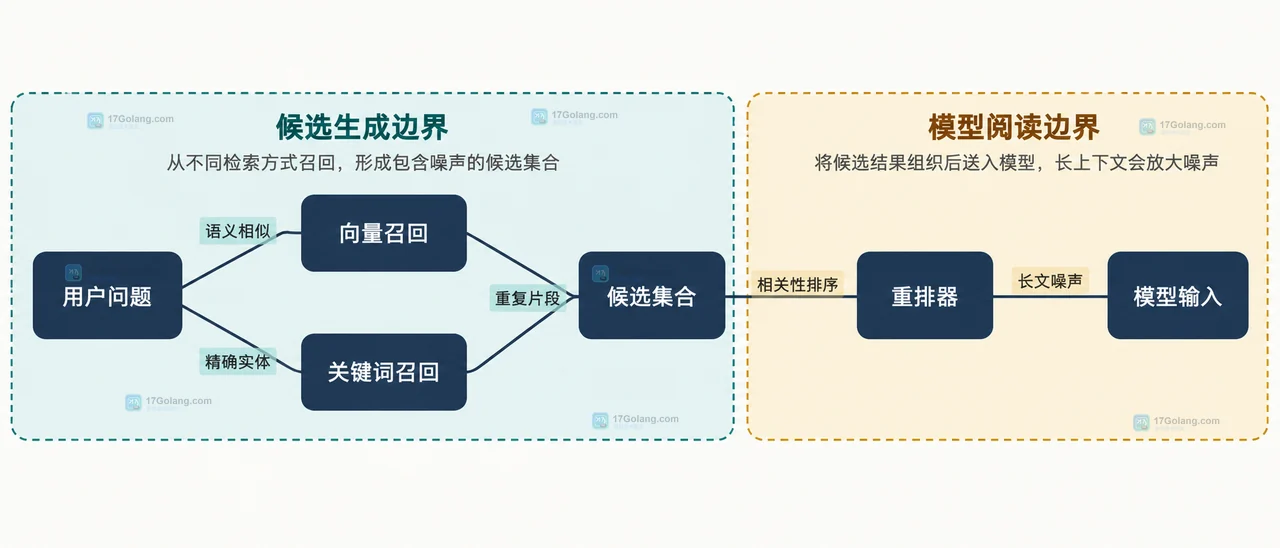 模型能接收更长输入,不代表它会更稳定地使用检索结果。本文从位置效应、候选重复和长文噪声解释原因,并给出混合召回、重排、去重与 token 预算的收敛做法。386 收藏