
Embedding批量生成时控制吞吐与失败重试的工程方法
来源:17golang原创
时间:2026-09-20 10:42:03 387浏览 收藏
Embedding 批量生成最容易踩的坑,不是模型调用本身,而是把“批次大小、请求速率、并发数、重试次数”绑成一个参数。结果通常是:小文本批量很快,遇到长文本就超时;服务返回 429 后所有协程同时重试;进程重启又把已经成功的向量写了一遍。
- 批次同时受条数和估算 Token 数限制,并为每批保存稳定的
batch_id。 - 并发控制、速率限制、批次大小分别调节,不能只靠 sleep。
- 只重试临时错误;用幂等键、数量校验和失败游标保证恢复安全。
Hugging Face 的 Text Embeddings Inference 文档支持一次请求发送多个输入,并提供 max_batch_tokens、max_batch_requests 和客户端批次上限等配置思路。无论后端是自建 TEI、Inference Endpoint 还是其他向量服务,下面的分层方式都适用。
先把批次边界设计成可恢复的任务
批次不要只按“每 32 条”切分。更稳妥的做法是同时设置 max_items 和 max_tokens:短文本可以凑满条数,长文本则提前封批。每批带上输入主键范围、内容哈希和创建时间,失败时才知道该补哪一段。
from dataclasses import dataclass
from hashlib import sha256

@dataclass
class Batch:
    items: list[dict]
    batch_id: str

def make_batches(rows, max_items=32, max_tokens=4096):
    # 这里用调用方已有的 token_count 估算,不把模型真实计费当作切分依据。
    current, tokens = [], 0
    for row in rows:
        cost = int(row["token_count"])
        if current and (len(current) >= max_items or tokens + cost > max_tokens):
            raw = "|".join(item["id"] for item in current)
            yield Batch(current, sha256(raw.encode()).hexdigest()[:16])
            current, tokens = [], 0
        current.append(row)
        tokens += cost
    if current:
        raw = "|".join(item["id"] for item in current)
        yield Batch(current, sha256(raw.encode()).hexdigest()[:16])
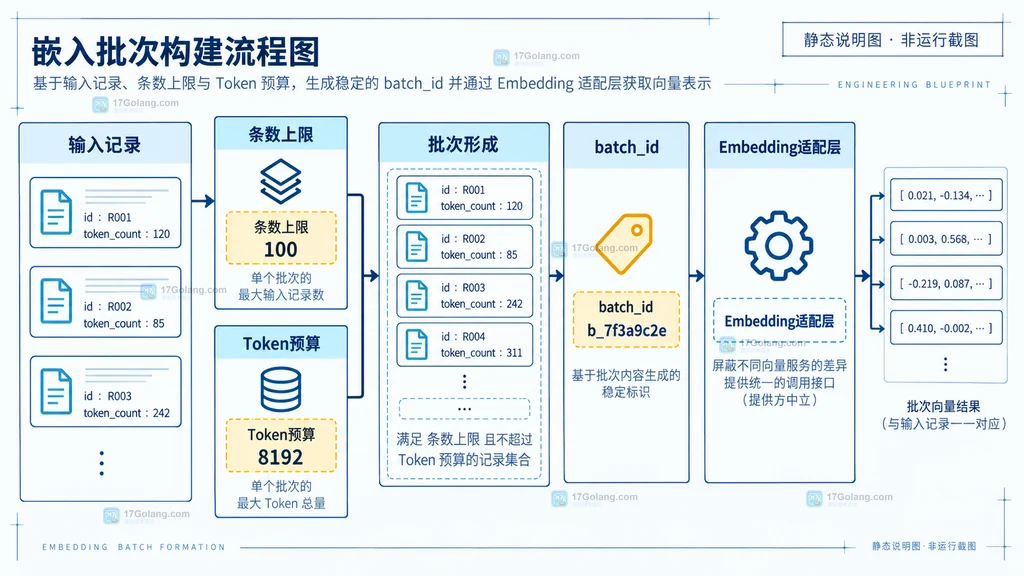
这里的 batch_id 只由输入主键顺序决定,重启后重新切分仍能得到同一个标识。若业务允许内容更新,还应把版本号或内容哈希加入幂等键,避免旧向量覆盖新文本。
吞吐控制要分成三个旋钮
批次大小决定单次请求的工作量;并发数决定同时占用多少连接和模型槽位;令牌桶或漏桶决定单位时间内允许发出多少请求。三者分开后,才能判断瓶颈究竟在客户端排队、网络,还是服务端计算。
| 现象 | 优先调整 | 不要先做的事 |
|---|---|---|
| 单批延迟突然变长 | 降低 max_tokens,观察长文本比例 | 盲目增加重试次数 |
| 连续 429 | 降低速率和并发,按 Retry-After 等待 | 让所有协程立即重试 |
| GPU空闲但队列很长 | 逐步增加并发槽,保持批次上限 | 无限增大单批 |
工程上可以先设置 4 个并发槽、每秒 2 个请求、单批最多 32 条,再根据 p95 延迟、429 比例和队列长度做小步调整。这个数值是起点,不是通用上限;服务端的模型、显存和网关配额才是最终边界。
只让临时错误进入退避重试
429、连接重置、超时和部分 5xx 通常值得重试,但输入过长、字段缺失、模型不支持该任务等错误应该进入死信队列。退避时间要加入随机抖动,避免同一批任务在同一毫秒再次撞向服务。
import random
import time

def run_with_retry(call, batch, max_attempts=4):
    # 幂等键贯穿每次尝试,服务端或结果库可据此去重。
    key = f"embedding:{batch.batch_id}"
    for attempt in range(max_attempts):
        try:
            vectors = call(batch.items, idempotency_key=key)
            if len(vectors) != len(batch.items):
                raise ValueError("向量数量与输入数量不一致")
            return vectors
        except TemporaryEmbeddingError:
            if attempt == max_attempts - 1:
                raise
            # 指数退避加抖动,避免多个批次同步重试。
            delay = min(30.0, 0.5 * (2 ** attempt)) + random.random() * 0.3
            time.sleep(delay)
        except PermanentEmbeddingError:
            # 永久错误不要重试,保留原始批次供人工或规则修复。
            raise
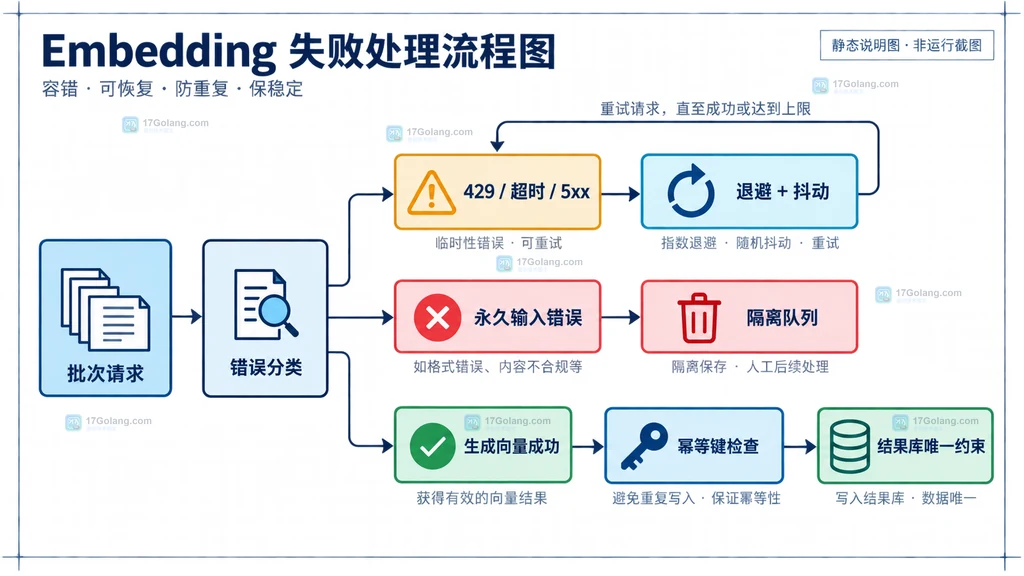
如果供应商没有真正的幂等接口,也要在自己的结果表上建立唯一键,例如 (model_name, content_hash, model_revision)。写入前查询,写入时使用唯一约束,成功后再推进游标,顺序不要反过来。
选型时看“失败后的成本”,而不是只看峰值速度
自建 Text Embeddings Inference 适合需要稳定批处理、能管理 GPU 和监控的团队;托管 Endpoint 适合希望把部署运维外包、但仍要固定模型和容量的场景;多提供商客户端适合快速验证和低频任务,但必须接受路由、配额和延迟可能变化。生产环境可把客户端封装成统一接口,让批处理器只依赖 embed(items, key),迁移时只替换适配层。
恢复清单:重启后只补未完成批次
- 从任务表读取状态为
pending或retryable的batch_id。 - 先检查结果库的幂等键,再调用服务,避免重复写入。
- 核对向量数量、维度和模型版本,成功后原子更新批次状态。
- 永久失败保留错误分类和原始输入,不要用空向量占位。
常见问题
批次越大,Embedding 吞吐一定越高吗?
不一定。超过模型或网关的 Token 上限后,延迟和失败率会先上升;应以 p95 延迟、429 比例和有效向量数共同判断。
超时应该重试几次?
先区分连接超时与服务端已接受请求的情况。最多 3~4 次退避重试通常比无限重试安全,最终仍失败就留下可恢复状态。
为什么不能只给整个任务加一个锁?
整任务锁会让一个坏批次阻塞全部输入。按 batch_id 独立记录状态,才能让健康批次继续推进,也方便精确重跑。
稳定的 Embedding 批处理,本质是把容量约束、错误分类和写入幂等拆开管理。先让每批可定位,再让每次重试可判断,最后才逐步提高并发,这样吞吐提升不会换来重复数据和不可恢复的失败。
-
225 收藏
-
101 收藏
-
202 收藏
-
191 收藏
-
427 收藏
-
170 收藏
-
183 收藏
-
467 收藏
-
487 收藏
-
310 收藏
-
199 收藏
-
173 收藏
-
301 收藏
-
398 收藏
-
科技周边 · 人工智能 | 13小时前 | 错误处理 · mcp · 工具调用 · AI工程 · MCP工具错误 isError structuredContent CallToolResult JSON-RPC错误208 收藏
-
359 收藏
-
171 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习