
DeepSeek Ascend 工具链中的算子与通信分工
来源:17golang原创
时间:2026-10-11 01:38:06 375浏览 收藏
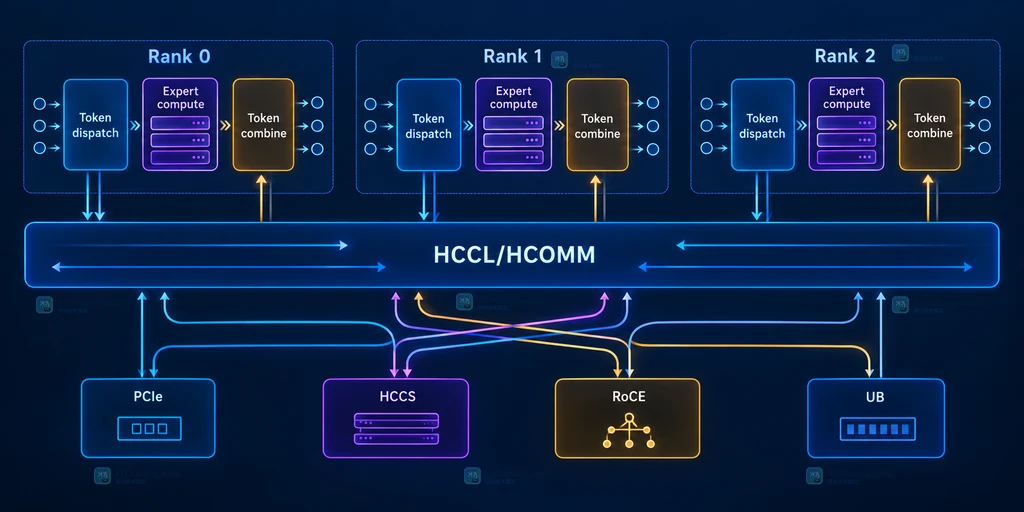
在 DeepSeek 模型迁移到昇腾 NPU 时,最容易混淆的是“算子”和“通信”:前者回答单个设备上如何计算,后者回答多个设备之间如何交换张量。实际工程里,MoE 的 token dispatch、expert 计算和 combine 往往同时出现,若一开始没有分边界,调优就会变成反复改 kernel。
官方资料:https://github.com/deepseek-ai/DeepEP-Ascend
Ascend 文档:https://www.hiascend.com/document/detail/en/CANNCommunityEdition/910/commlib/commopdev/docs/en/comm_op_dev_guide/intro.md
- 本地矩阵、激活、归约等计算优先归入算子边界。
- AllReduce、AllGather、ReduceScatter、AlltoAll 以及 rank 间数据交换归入通信边界。
- 先确认 CANN、驱动、固件和拓扑,再比较 kernel 时间与通信时间。
先把三类职责拆开
| 问题 | 主要职责 | 优先看的组件 |
|---|---|---|
| 一个 NPU 内怎样完成计算 | 输入布局、分块、向量或矩阵计算、尾块处理 | Ascend C、算子库、BiSheng |
| 多个 rank 怎样交换数据 | 拓扑、集合通信、同步、带宽和通信资源 | HCCL、HCOMM、通信算子 API |
| 模型怎样调用它们 | 张量分发、stream、生命周期、框架后端 | PyTorch/torch_npu、DeepSeek 项目封装 |
这个划分不是按目录名猜,而是按数据是否跨设备判断:数据仍在当前设备上流动,通常属于算子实现;数据需要经过 HCCS、RoCE、PCIe 或其他互联路径,通常属于通信实现。两者在一个 kernel 中融合时,也要分别记录计算和搬运耗时。
单卡计算优先走 Ascend C 与现有算子库
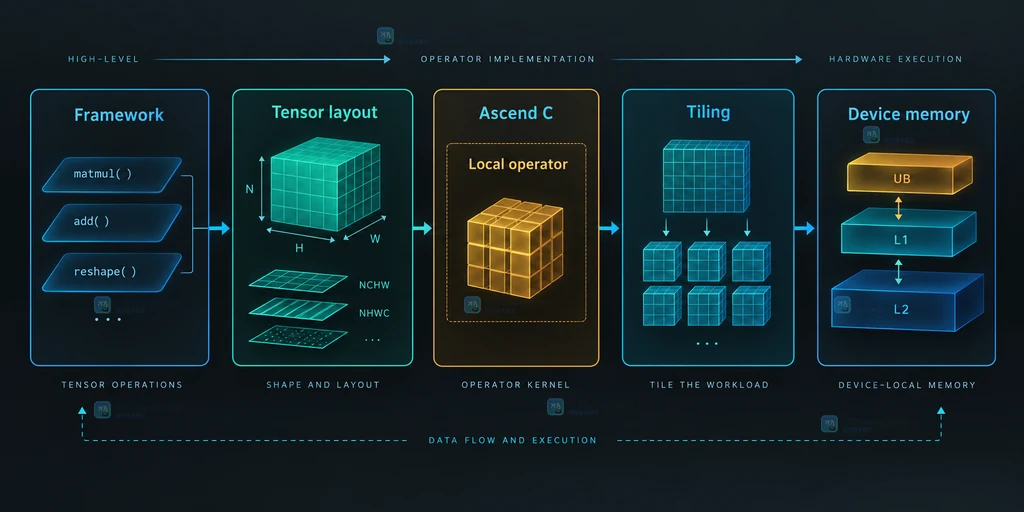
如果需求是激活函数、量化反量化、局部归约、格式转换或矩阵计算,第一选择通常是查 CANN 已有算子和 Ascend C 编程模型。只有现有算子无法满足布局、精度或性能要求时,才进入自定义 operator 的实现、tiling 和编译流程。
本地算子至少要固定三件事:输入输出 shape 和 dtype、内存布局与对齐要求、以及尾块和动态 shape 的处理方式。不要把跨 rank 的等待塞进普通计算算子,否则单卡正确性和多卡时序会同时变得难以定位。
// 这里只展示职责边界:kernel 负责本地计算,不负责跨卡同步。 __aicore__ void ComputeLocal(const LocalTensor& input, LocalTensor & output, int32_t count) { // 生产代码应根据 tile 大小处理尾块,避免越界读取。 for (int32_t i = 0; i
跨卡交换交给 HCCL/HCOMM
当问题变成“每个 rank 的 token 怎样送到目标 expert”“各卡怎样合并部分结果”,就应先看 HCCL 的集合通信能力和通信算子开发接口。官方文档把 AllReduce、AllGather、ReduceScatter、AlltoAll 等列为通信原语;这些 API 描述通信任务,真正的执行时机还要配合对应的 commit 或框架调度语义。
DeepEP-Ascend 的公开说明也体现了这种分工:MoE 的 dispatch/combine 是上层业务语义,底层使用 HCCL/HCOMM、UBMEM 与 URMA 等能力完成数据交换。阅读项目代码时,先找 buffer、rank、group 和 stream 的生命周期,再看 kernel 如何处理本地布局,效率会高很多。
MoE 场景的推荐排查顺序
- 环境层:确认 CANN、驱动、固件、torch_npu 和编译器版本匹配,先排除加载失败与 ABI 问题。
- 拓扑层:确认 rank 数、设备映射、网卡或互联路径,以及所有进程是否使用同一通信初始化参数。
- 正确性层:用小 batch 检查 dispatch 后 token 数、expert id、combine 权重和 padding;先确认数据没有丢失或重复。
- 性能层:分别记录本地 expert kernel、通信等待、数据转换和 epilogue,不能只看端到端耗时。
- 生命周期层:所有异步操作完成后再复用或销毁 buffer;遇到卡死先查 stream、barrier 和未完成通信。
# 这是排查配置的最小记录模板,不会启动真实通信。
config = {
    "backend": "hccl",       # 分布式后端,需与 torch_npu 环境匹配
    "world_size": 8,          # 所有 rank 必须对同一组大小达成一致
    "master_addr": "10.0.0.1",  # 仅示例地址,生产环境使用实际协调节点
    "master_port": 29500,     # 端口需在节点间可达且不被占用
}
# 先记录配置,再把通信耗时与本地算子耗时分开采样。
print(config)
不要把工具链职责混成一层
如果只改 Ascend C kernel,却没有检查 AlltoAll 的消息规模和拓扑,通信瓶颈不会消失;如果只调 HCCL 环境变量,却忽略本地 layout 转换,通信带宽也可能被无效搬运吃掉。更稳妥的落地方式是:先用已有算子和通信原语跑通小规模闭环,再逐个替换热点算子,最后根据 profile 决定是否使用融合通信算子。
版本差异也要单独记录。CANN 社区文档会随产品和版本增加通信算子开发能力,DeepSeek-Ascend README 里的硬件、固件和性能条件同样不是所有 Ascend 设备的通用结论。没有在目标设备上验证的数字,只能作为项目资料中的参考,不能当作部署承诺。
相关问题
算子慢和通信慢应该先查哪个?
先用 profile 分开本地 kernel、通信等待和同步时间。若 kernel 占比高,查布局、tile 和精度;若等待占比高,查消息规模、拓扑和 rank 配置。
所有跨卡操作都要自己写通信算子吗?
不需要。常规集合通信优先复用 HCCL;只有算法需要特殊的 dispatch、融合或调度语义时,才考虑通信算子开发接口。
为什么单卡正确,多卡却卡住?
单卡不会暴露 rank 数、集合顺序、stream 和 barrier 约束。先核对所有进程的 group、设备映射和 collective 调用顺序,再检查异步 buffer 是否提前复用。
-
253 收藏
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
273 收藏
-
209 收藏
-
113 收藏
-
429 收藏
-
239 收藏
-
343 收藏
-
313 收藏
-
161 收藏
-
486 收藏
-
154 收藏
-
373 收藏
-
300 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习