
MCP 工具结果分页与长列表截断的设计
来源:17golang原创
时间:2026-10-10 17:31:17 486浏览 收藏
当 MCP 工具返回几百条文件、工单或搜索记录时,最容易出现的麻烦不是“接口调不通”,而是一次调用把完整列表塞进模型上下文:结果变长,模型更难抓住重点,用户也没有可靠的“继续看下一页”入口。更稳妥的做法是把列表拆成有限页面,并让结果同时携带可读预览和机器可用的续取信息。
这篇文章把两件容易混淆的事分开:MCP 协议对 tools/list、resources/list 等列表操作提供的游标分页,以及业务工具在 tools/call 返回大结果时自己设计的分页契约。后者不是把所有字段随意截成半句话,而是要保留稳定排序、边界状态和下一次调用所需的 opaque cursor。
官方地址:https://modelcontextprotocol.io/
长列表的核心策略是“服务端分页、客户端限量展示、续取信息结构化”。游标只由产生它的服务端解释,最后一页不返回下一游标;如果只想控制模型看到的文本长度,也要把“展示截断”和“数据分页”明确区分。
先分清两种分页边界
MCP 的标准列表方法已经有分页语义。客户端请求 tools/list 时可以带 cursor,服务端在还有数据时返回 nextCursor;游标是 opaque token,客户端不应该把它当作页码、偏移量或 JSON 自己解析。服务端也决定实际页大小,因此客户端不能写死“每页一定有 20 条”。
但业务工具调用通常是另一层问题。例如一个名为 search_tickets 的工具,调用参数里可以自定义 limit 和 cursor,结果里再返回 items、hasMore 和 nextCursor。这组字段是工具的业务契约,不应伪装成 MCP 的通用结果字段。
{
  "jsonrpc": "2.0",
  "id": 7,
  "method": "tools/list",
  "params": {
    "cursor": "opaque-token-from-server"
  }
}
上面的 JSON 只演示协议层列表请求,保持严格 JSON 格式,不在里面插入注释。真正的业务结果可以使用自己的结构化字段,但要在工具的输入输出说明中固定字段含义,并让客户端知道哪些字段是展示内容、哪些字段只用于继续查询。
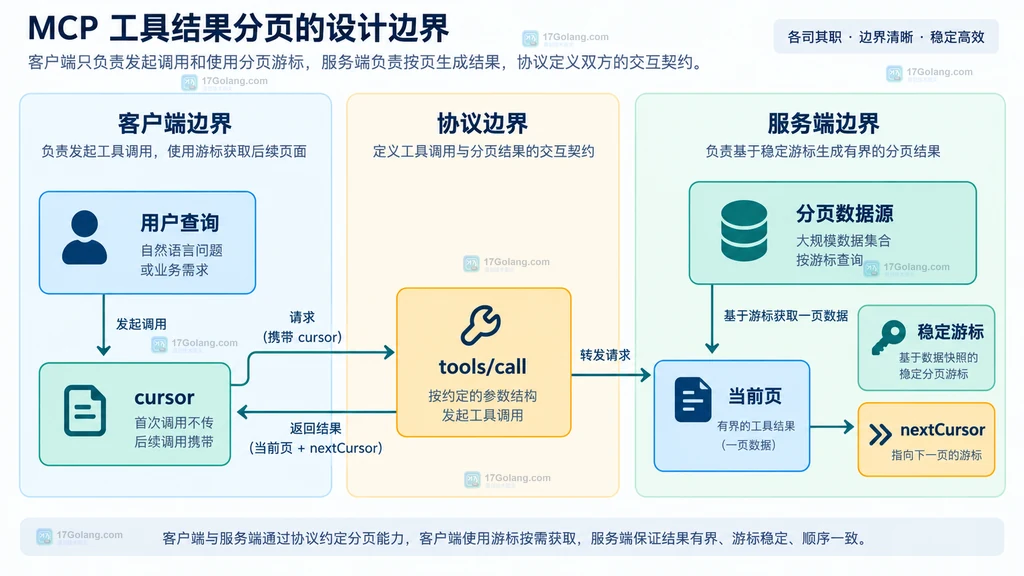
先把服务端的页面契约定下来
分页最怕的是第一页和第二页之间数据顺序发生变化。设计工具时,先固定一个可重复的排序键,例如“更新时间降序 + 唯一 ID 升序”,再让 cursor 记录这个排序视角下的续取位置。不要只用数据库当前 offset 作为长期游标,因为前面插入新记录、删除记录或排序字段相同时,都可能造成重复和漏项。
页大小也应该由服务端设上限。客户端可以请求一个偏好值,但服务端应把它裁剪到允许范围,并在结果中明确当前返回的数量。下面的结构是业务层示例,字段名可以按工具命名,但语义要稳定:
// Page 是工具结果的分页外壳,items 承载当前页,游标只由服务端解释。
type Page[T any] struct {
	Items      []T    `json:"items"`       // 当前页数据,不承诺固定条数
	NextCursor string `json:"nextCursor,omitempty"` // 没有下一页时省略
	HasMore    bool   `json:"hasMore"`     // 让调用方不必猜测是否还有数据
	Returned   int    `json:"returned"`    // 记录本页实际返回数量
}

// normalizeLimit 防止调用方用超大 limit 直接放大一次结果。
func normalizeLimit(requested int) int {
	if requested  100 {
		return 100 // 上限需要与上下文预算和后端查询能力一起确定
	}
	return requested
}
这里的 HasMore 和 NextCursor 不是重复字段:HasMore 适合界面或模型快速判断,NextCursor 才是下一次调用的实际凭据。最后一页应让 HasMore=false,同时不再返回可继续使用的游标。
客户端不要把每一页都无条件拼进上下文
客户端通常有两个消费模式。需要导出完整数据的任务,可以按页处理并写入外部存储;需要模型做判断的任务,则应该先取一页摘要,只有模型明确需要更多内容时再继续。两者都不应该默认把所有页面拼成一条超长文本。
下面的 TypeScript 片段用一个抽象的 callTool 表示工具调用。重点不在某个 SDK 的方法名,而在“本页处理完成后才决定是否取下一页”的控制点:
type SearchPage = {
  items: Array;
  hasMore: boolean;
  nextCursor?: string;
  returned: number;
};

async function collectForModel(query: string, maxItems: number) {
  const items: SearchPage["items"] = [];
  let cursor: string | undefined;

  while (items.length ("search_tickets", {
      query,
      limit: Math.min(20, maxItems - items.length),
      ...(cursor ? { cursor } : {}),
    });

    items.push(...page.items);
    // 服务端没有 nextCursor 时,当前页就是最后一页。
    if (!page.hasMore || !page.nextCursor || page.items.length === 0) {
      break;
    }
    cursor = page.nextCursor;
  }

  return items;
}
循环里有三个保护点:总量上限限制模型输入,nextCursor 原样传回避免客户端依赖内部格式,空页直接停止避免服务端异常时形成死循环。如果业务确实需要完整结果,可以把 items 写入文件或数据库,再向模型返回摘要和存储引用。
把可读预览和续取信息放在同一个结果里
长列表截断不是简单地对一段字符串执行 slice。字符串截断可能切开 JSON、路径、代码或多字节文本,模型看到的内容也无法判断“后面是否还有数据”。更安全的结果契约至少包含四块:
| 字段 | 用途 | 设计要点 |
|---|---|---|
content | 给模型和用户看的简短摘要 | 按记录边界裁剪,不在半条记录中间截断 |
structuredContent.items | 当前页机器可读数据 | 与输出 schema 对齐,字段保持稳定 |
hasMore | 是否仍有后续数据 | 最后一页必须为 false |
nextCursor | 继续调用的凭据 | 不展示内部格式,不跨查询复用 |
MCP 工具结果可以同时有非结构化的 content 和结构化的 structuredContent。当工具声明了输出 schema,服务端返回的结构化结果必须符合该 schema;因此,摘要可以面向阅读,分页字段仍要保持机器可解析。
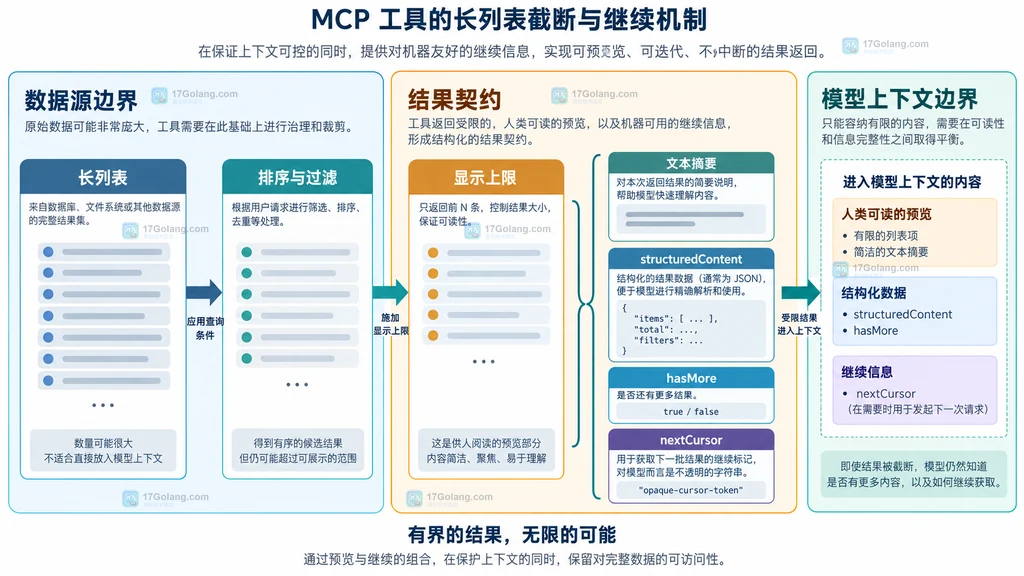
function makeResult(page: SearchPage) {
  // 摘要按完整记录生成,避免把一条记录截成半截。
  const preview = page.items
    .map((item) => item.id + " " + item.title)
    .join("\n");

  return {
    content: [{
      type: "text",
      text: page.hasMore ? preview + "\n还有更多结果,请使用 nextCursor。" : preview,
    }],
    structuredContent: {
      items: page.items,
      returned: page.returned,
      hasMore: page.hasMore,
      ...(page.nextCursor ? { nextCursor: page.nextCursor } : {}),
    },
  };
}
如果结果中还需要图片、资源链接或大段原文,可以考虑让工具返回资源引用,而不是把所有内容内嵌进文本。这样模型先看到索引和摘要,真正需要时再读取具体资源,分页和上下文控制也更容易分层。
游标、排序和失效要一起设计
游标可靠与否,取决于它背后的数据视图,而不只是 token 是否随机。实际设计时可以按下面的约束检查:
- 排序必须确定:主排序字段相同时再追加唯一键,避免同一条记录在两页之间漂移。
- 游标必须不透明:客户端只保存并回传,不从中推断页码、时间戳或内部主键。
- 查询条件必须绑定:cursor 只对原查询的过滤条件、排序和权限范围有效,条件变化就从第一页开始。
- 失效要可解释:数据快照过期、权限改变或 cursor 格式不再支持时,返回明确的无效参数错误,并提示重新开始。
- 最后一页要收口:没有更多数据时省略
nextCursor,不要返回空字符串让客户端误判。
尤其不要把 cursor 永久写入缓存后跨用户、跨权限或跨查询复用。游标里即使编码了位置,也不应该成为绕过权限检查的凭据;每次续取仍需重新应用身份、租户和过滤范围。
用四组样例覆盖截断边界
这类功能的测试重点不是“返回了几条”这么简单,而是下一次调用能否无重复、无遗漏地继续。至少准备四组样例:
- 数据量小于页长:一次返回全部记录,
hasMore=false,不带下一游标。 - 数据量刚好等于页长:第一页仍然要根据服务端是否确认还有数据决定是否返回游标,不能用“本页满了”代替真实判断。
- 数据量跨越多页:连续取页后检查 ID 集合,确认没有重复和遗漏。
- 游标失效或条件改变:服务端返回可识别错误,客户端清空旧游标并从新查询开始。
另外补一条异常样例:服务端返回 hasMore=true 但没有 nextCursor。客户端应把它视为不可继续的坏结果并停止,而不是反复请求同一页。相反,服务端收到未知 cursor 时也不应悄悄当作第一页,否则重复数据会被误认为正常。
一张表记住落地取舍
| 场景 | 服务端做法 | 客户端做法 |
|---|---|---|
| 工具列表发现 | 使用 MCP 标准 list 分页与 nextCursor | 按协议原样回传 cursor,直到没有下一页 |
| 工具业务大列表 | 自定义 limit/cursor 与结果 schema | 按需续取,不把全部页面自动拼给模型 |
| 模型只需概览 | 返回有限记录、摘要、hasMore | 优先使用当前页,必要时再发起下一次调用 |
| 完整导出 | 保证排序、快照或一致性边界 | 逐页写外部存储,向模型返回汇总信息 |
| 游标异常 | 返回明确的无效参数或过期错误 | 丢弃旧 cursor,重新发起首查 |
可以把这套规则浓缩成一句工程判断:MCP 原生分页解决“列表如何发现”,工具自己的分页契约解决“业务结果如何继续取”,客户端截断策略解决“模型当前应该看到多少”。三层各自负责,长列表就不会同时变成协议歧义和上下文负担。
常见问题
工具结果分页能直接复用 tools/list 的 nextCursor 吗?
不建议。tools/list 的游标属于工具发现列表;业务工具结果通常有自己的过滤条件、排序和数据源,应建立独立的输入输出字段。
只限制 content 文本长度够不够?
不够。文本长度限制只能控制可读预览,不能替代结构化的当前页、是否还有数据和续取凭据。否则模型看到“结果已截断”后没有可靠办法继续。
cursor 可以按页码设计吗?
服务端内部可以用偏移量实现,但对客户端应保持 opaque。这样以后改成时间游标、数据库快照或签名 token 时,客户端无需跟着改变。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
161 收藏
-
154 收藏
-
373 收藏
-
300 收藏
-
356 收藏
-
449 收藏
-
科技周边 · 人工智能 | 1天前 | 缓存 · 人工智能 · 提示词工程 · 提示词缓存 cache_control Prompt Caching 静态前缀 cache_read_input_tokens453 收藏
-
232 收藏
-
215 收藏
-
236 收藏
-
196 收藏
-
404 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习