
人工智能技术文章
-
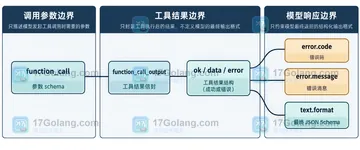 Responses API 的结构化输出不会自动校验工具返回值。本文用统一错误信封、function_call_output 和严格 JSON Schema 保留错误码、消息与可重试标记,并说明为什么还要保存原始工具结果。111 收藏
-
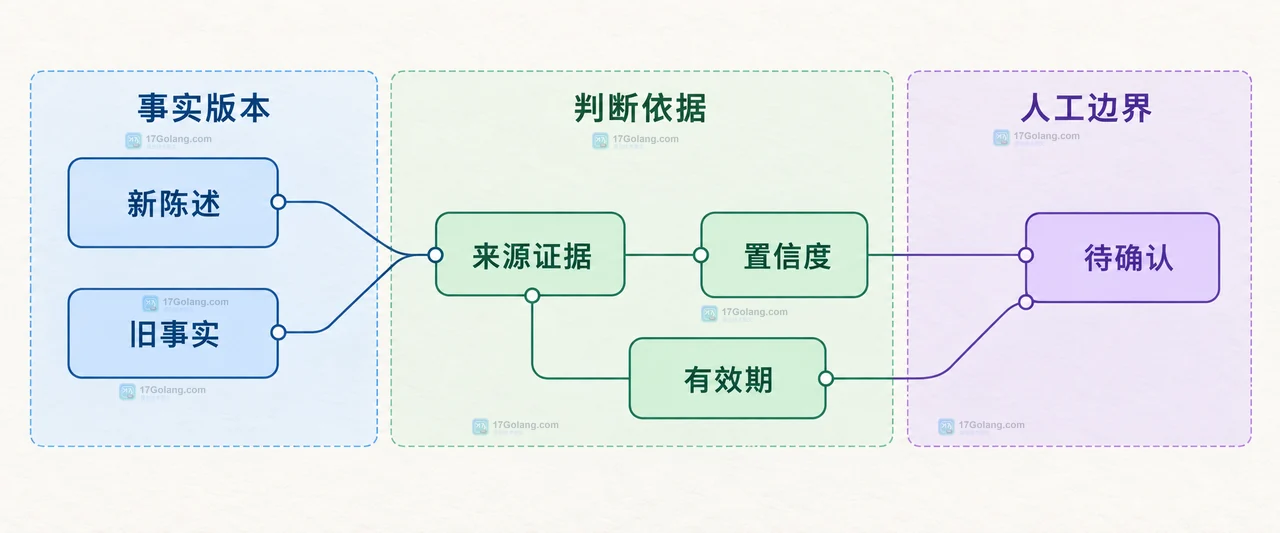 AI Agent 记忆不应把所有对话永久保存。本文用会话、任务和用户事实三层模型,说明字段设计、写入门槛、分层检索与冲突处理方法。110 收藏
-
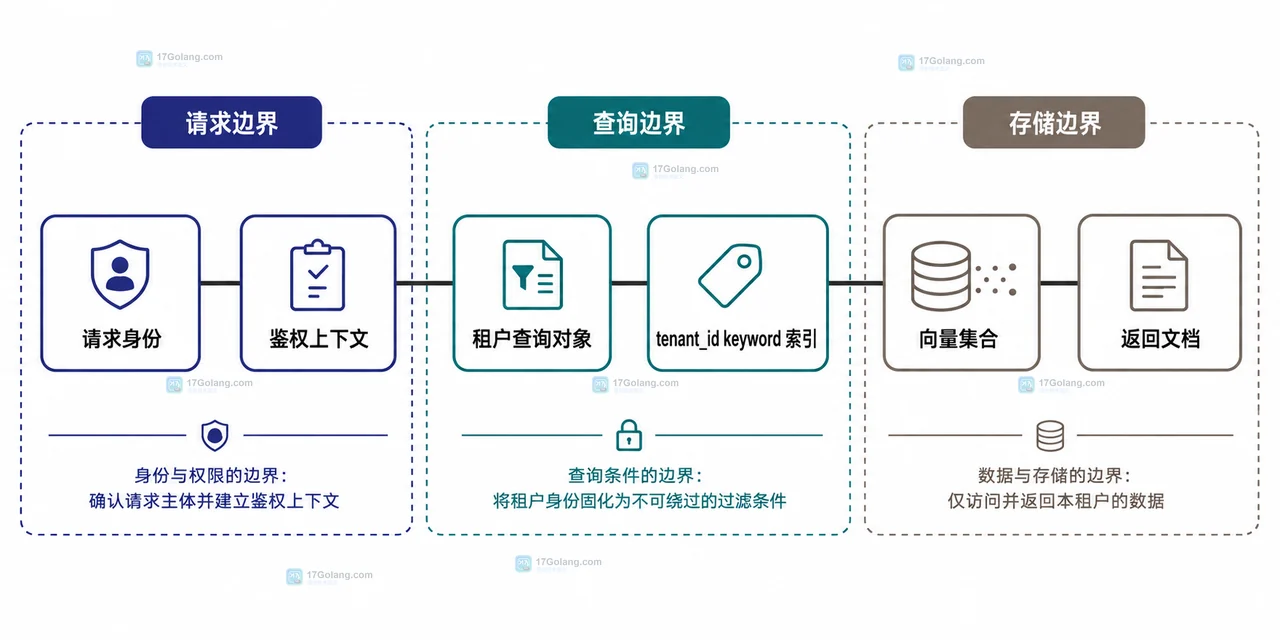 多租户向量检索不能只依赖相似度。本文说明如何从服务端鉴权上下文得到 tenant_id,为记录建立精确过滤字段,并比较共享集合、分区键和独立集合的隔离边界。108 收藏
-
 模型流式输出中断时,不要直接把请求重发并拼接全文。先保存 request_id、事件序号和幂等键,重连时重放已确认事件,再按供应商能力决定是否续生成,才能避免重复展示和状态错乱。108 收藏
-
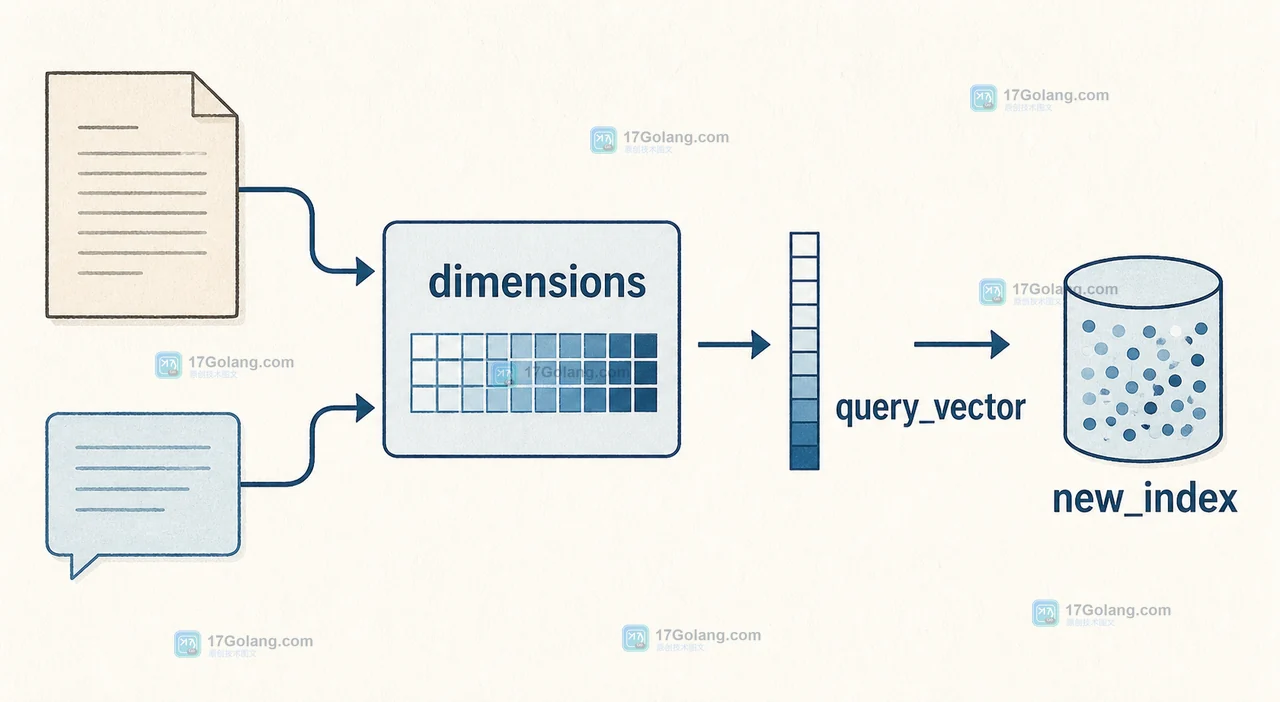 向量检索系统里,模型、dimensions 参数和索引维度必须形成一份可检查的契约。本文用 OpenAI Embeddings 的请求参数、双索引回填和查询路由,说明如何迁移维度而不让新旧向量混在一起。105 收藏
-
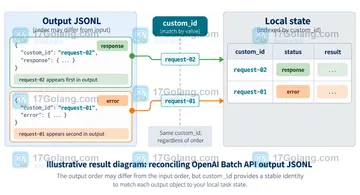 OpenAI Batch API 的输出顺序不保证与输入一致,custom_id 才是回配原始请求的稳定关联键。本文用 JSONL、成功结果、错误结果和重试设计说明如何可靠映射批量任务。105 收藏
-
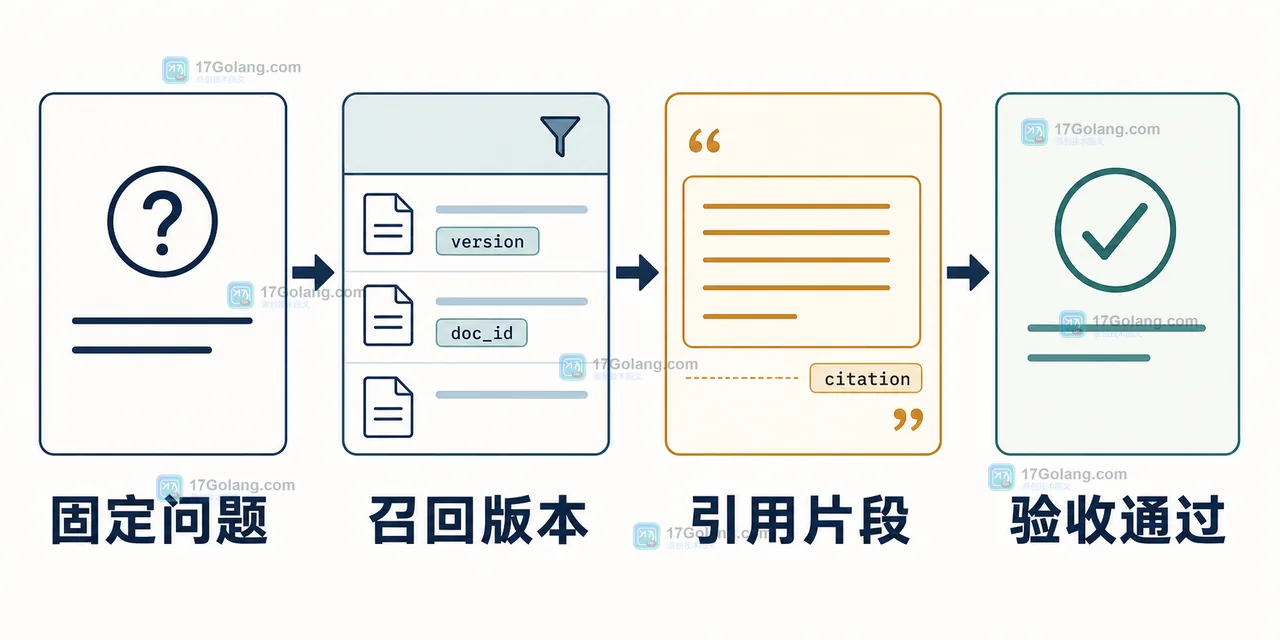 RAG 知识库更新后仍返回旧答案,通常不是模型突然失忆,而是旧分片仍能被召回。本文用文档版本、元数据过滤和固定问题集建立一条可验收的更新流程,覆盖发布、回滚和灰度边界。104 收藏
-
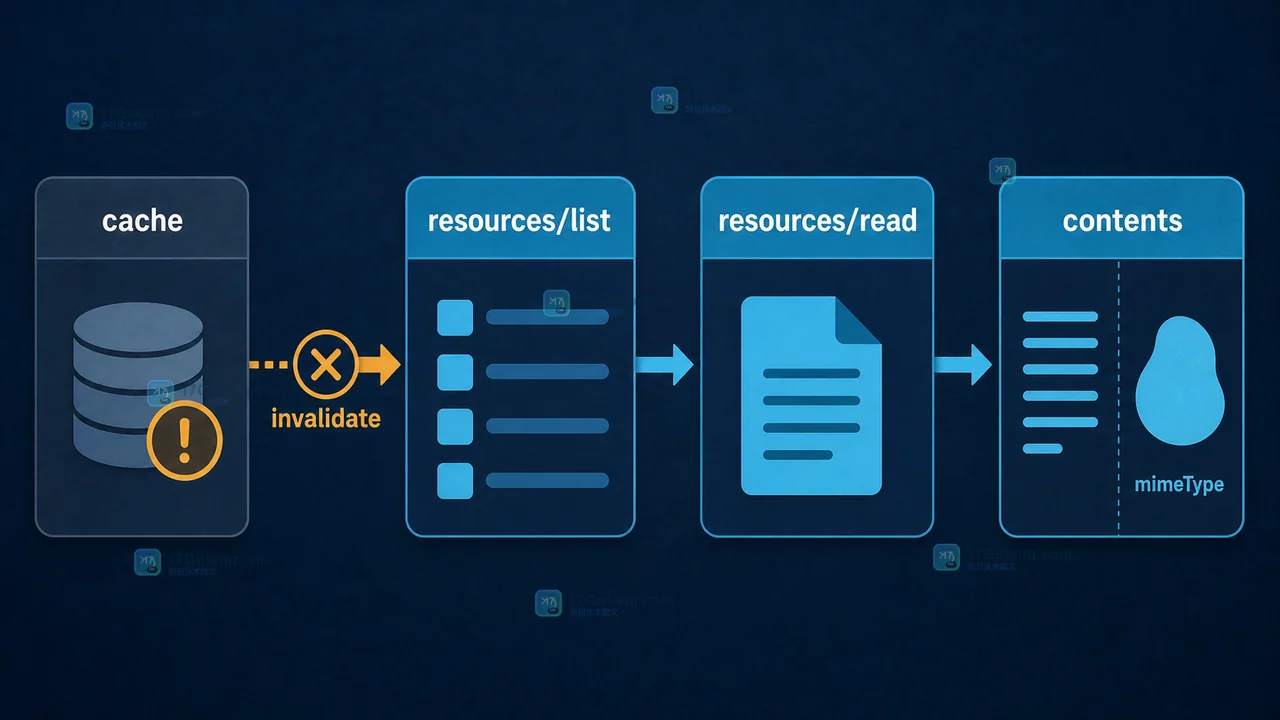 MCP 客户端拿到 resources/read 的空结果时,问题通常不在模型,而在 URI 没有按原值传递、内容类型判断错误或把资源列表缓存成了永久数据。本文按一次可复现的排查顺序,拆开 URI、contents、文本与二进制资源,以及缓存失效边界。104 收藏
-
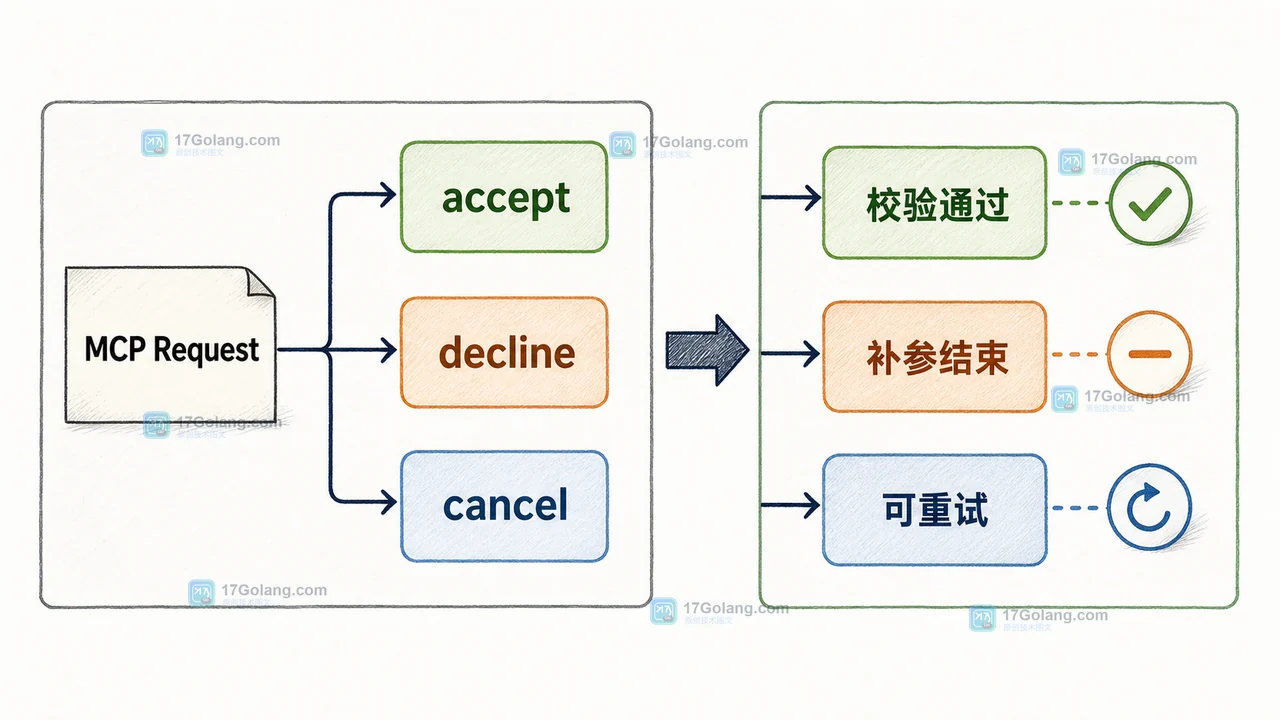 MCP Elicitation 让服务器可以在工具调用过程中向用户请求缺失信息,但客户端必须处理接受、拒绝和取消三种结果。本文用一个日期范围查询示例,说明如何设计请求、校验结构化数据并安全收口。103 收藏
-
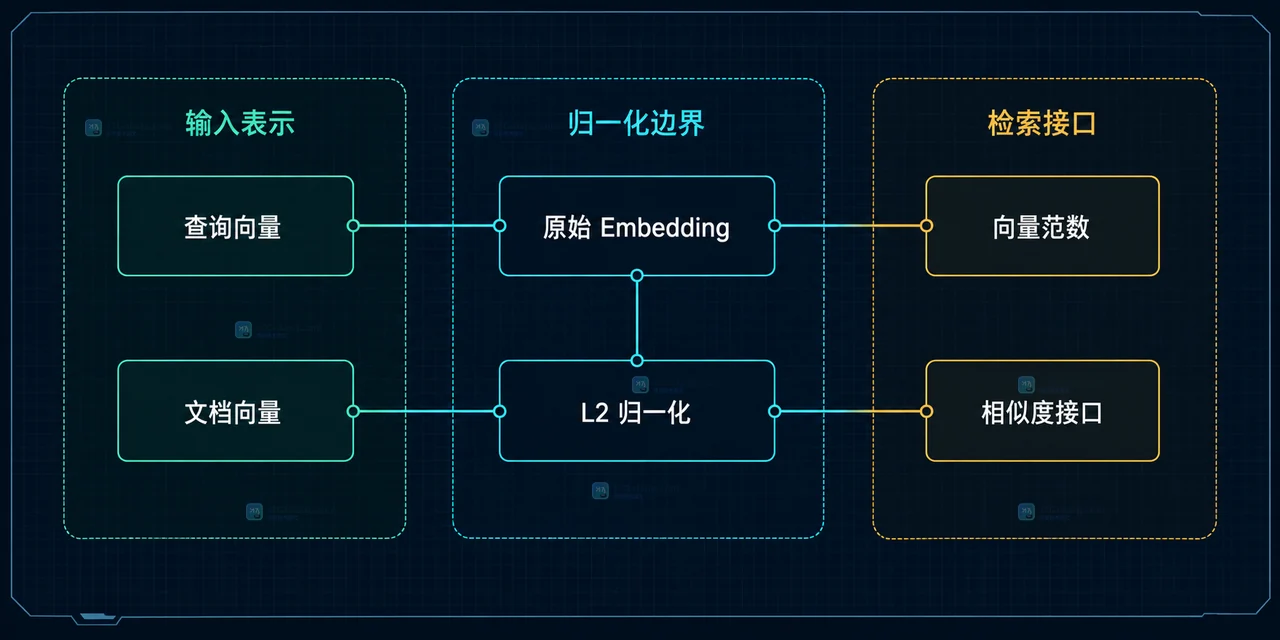 Embedding 已做 L2 归一化时,点积与余弦相似度在数学上等价,工程上通常优先点积以避免重复归一化;若输入状态不确定或链路混用,则应显式使用余弦并先统一预处理。103 收藏
-
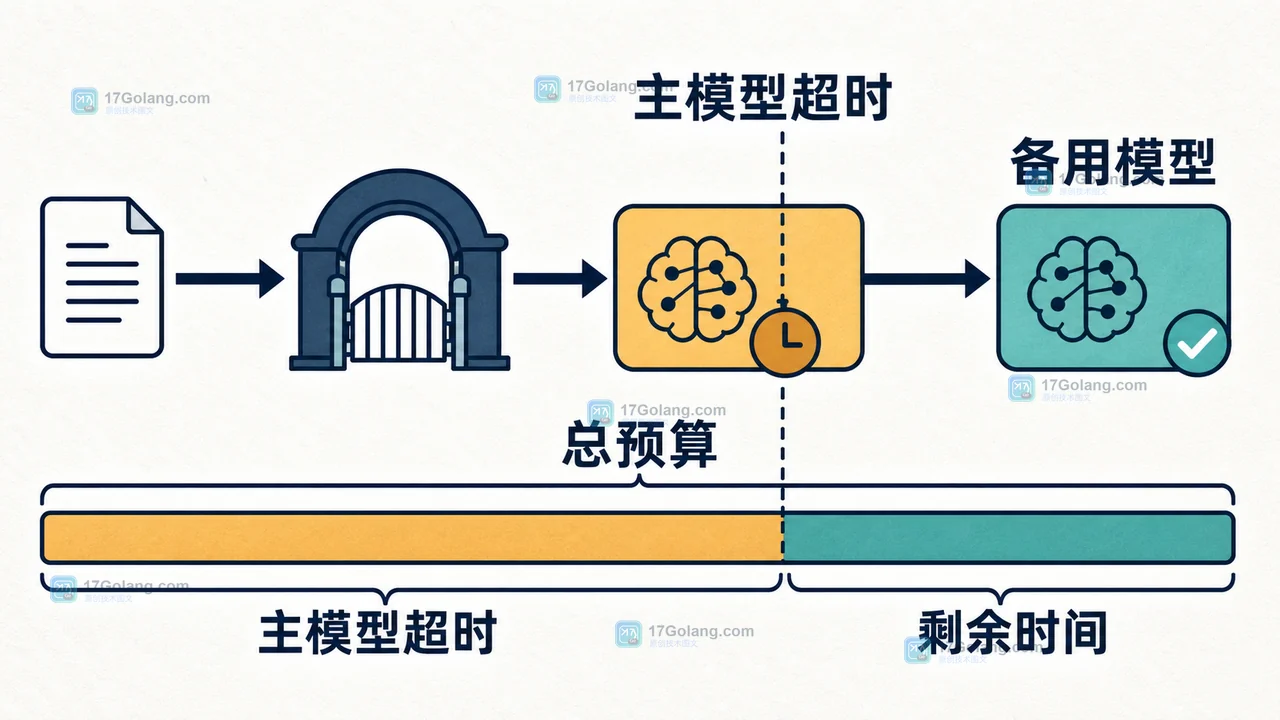 接入多个大模型后,真正难处理的不是把请求转发出去,而是主模型超时、限流或返回异常时如何在有限时间内切换备用模型。本文用一个可落地的网关流程说明超时预算、降级条件和结果标记应该怎样设计。102 收藏
-
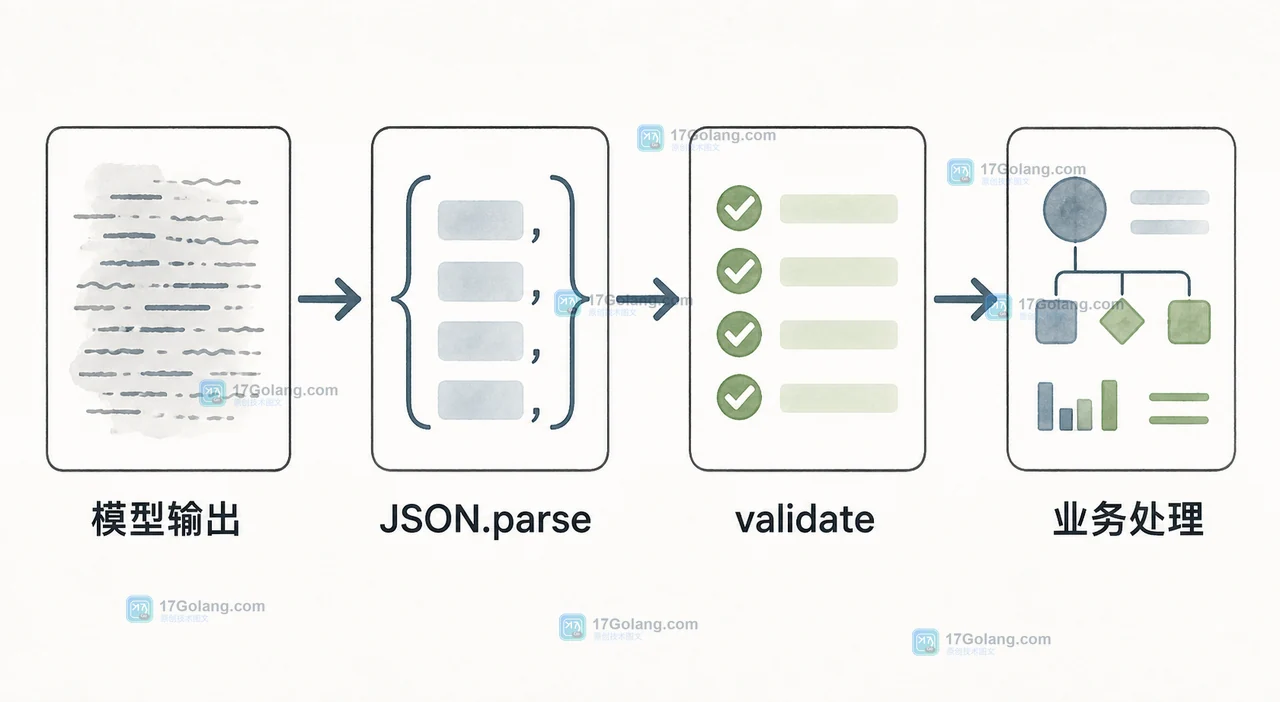 多模态模型返回的 JSON 即使能解析,也可能缺字段、类型漂移或混入不该出现的值。本文用一条可复现的处理链说明如何先解析、再校验、按错误类型决定修复或重试,并划清模型约束与业务校验的边界。102 收藏
-
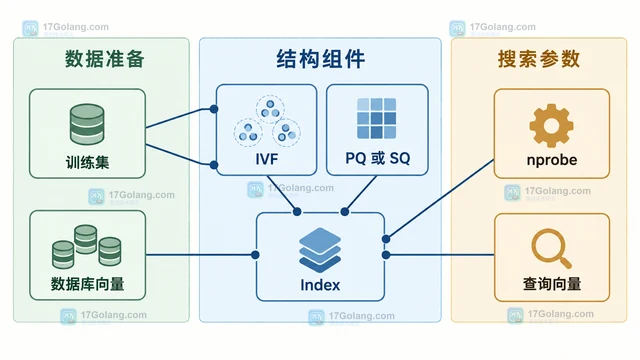 拆解 FAISS Index Factory 字符串的组合规则,用 Flat、IVF、PQ、SQ、PCA 和 OPQ 示例说明粗排、压缩、训练与 nprobe 参数应如何分工。100 收藏