
FAISS Index Factory 字符串怎么组合索引结构
来源:17golang原创
时间:2026-09-28 01:17:19 100浏览 收藏
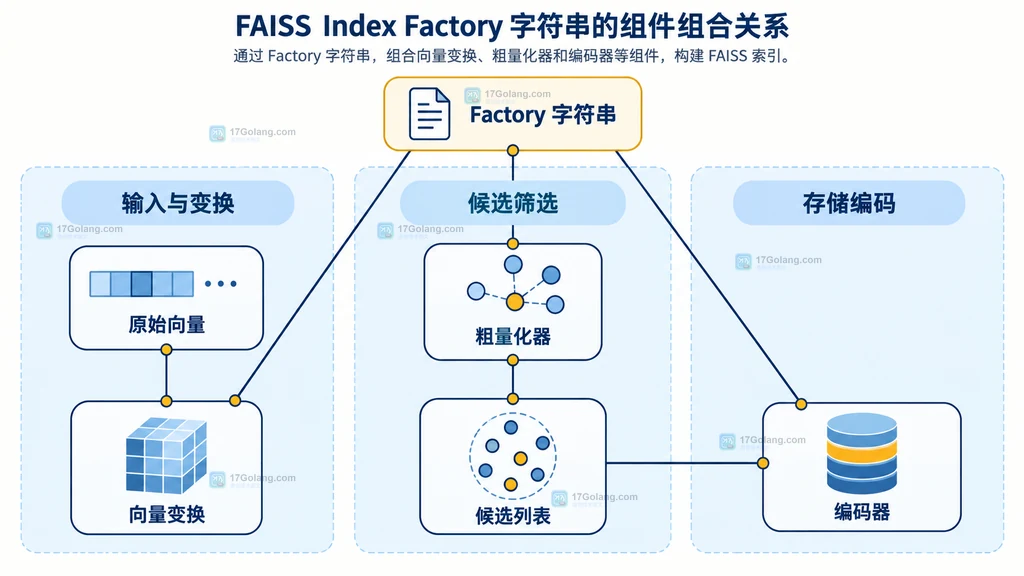
FAISS 的 index_factory 可以用一条逗号分隔的字符串构造复合索引。最实用的理解不是死记所有缩写,而是把字符串从左到右拆成三层:可选的向量变换、候选筛选结构、最终存储编码。例如 OPQ16_64,IVF4096,PQ16 表示先把输入向量做 OPQ 变换并输出 64 维,再由 4096 个倒排中心缩小候选范围,最后用 16 个子量化器组成的 PQ 编码保存向量。
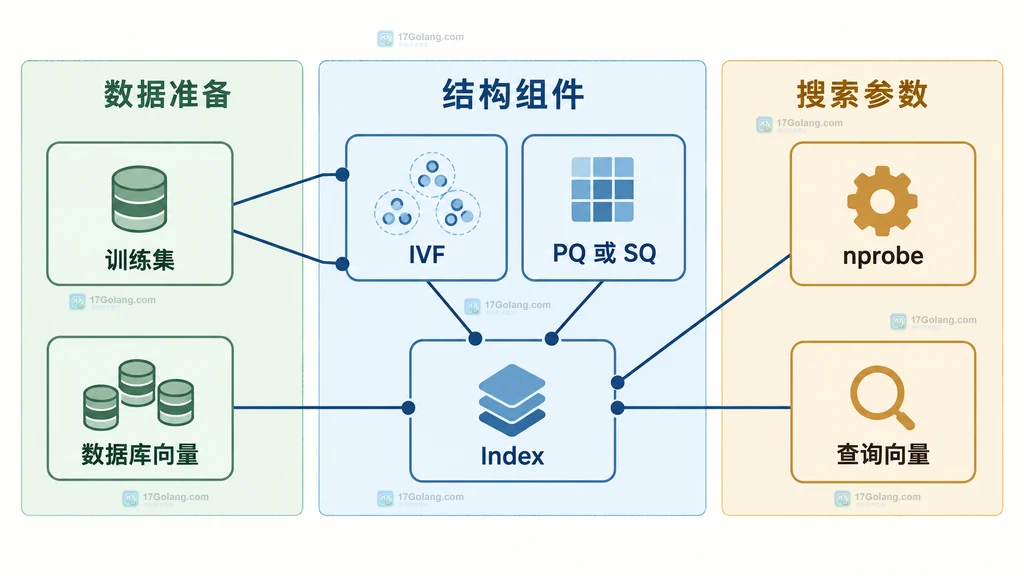
组合时先决定是否接受近似检索,再决定内存预算,最后才考虑 PCA、OPQ 这类预处理。Flat 是精确基线;IVF 负责粗排;PQ 和 SQ 负责压缩。需要训练的结构要先调用 train,运行时的 nprobe 则不写进 Factory 字符串,而是在搜索前单独设置。
前置条件:先把 Factory 字符串看成三层结构
官方说明把 Factory 字符串定义为组件列表。常见组合可以用下面这张表快速判断:
| 字符串 | 得到的结构 | 适合先验证什么 |
|---|---|---|
Flat | 精确穷举,原始浮点向量 | 召回上限和距离度量 |
IVF1024,Flat | 1024 个倒排列表,列表内保留原向量 | 粗排带来的速度与召回变化 |
IVF1024,PQ16 | 倒排粗排加 16 字节 PQ 编码 | 内存压缩后的精度 |
IVF1024,SQ8 | 倒排粗排加每维 8 位标量量化 | 较温和的压缩方案 |
PCA64,Flat | 先降到 64 维,再做精确搜索 | 降维本身造成的损失 |
OPQ16_64,IVF4096,PQ16 | OPQ 变换、IVF 粗排、PQ 压缩 | 完整的粗排与压缩组合 |
逗号不是“先后执行脚本”的含义,而是在声明一个嵌套索引。左侧组件包裹右侧组件:变换作用于输入,IVF 决定去哪些列表找候选,编码组件决定每条向量以什么形式保存在索引里。
初始化:从 Flat 基线确认维度和度量
我习惯先用 Flat 建一个基线索引。它不需要训练,保存的是原始浮点向量,搜索结果可以当作后续近似索引的对照。Factory 的第一个参数是输入向量维度,不能把降维后的维度误传进去;如果输入是 128 维,即使字符串写了 PCA64,第一个参数仍然是 128。
import faiss

d = 128

# 精确 L2 检索基线,不需要训练
flat_index = faiss.index_factory(d, "Flat", faiss.METRIC_L2)
flat_index.add(database_vectors)

# 返回前 10 个近邻,用于和近似索引比较
flat_distances, flat_ids = flat_index.search(query_vectors, 10)
若业务按余弦相似度检索,通常先对数据库向量和查询向量做 L2 归一化,再使用内积度量。Factory 字符串也支持 L2norm 变换,但无论采用哪种方式,都要让建库与查询保持一致。
编写代码:加入 IVF 粗排层
IVF1024,Flat 中的 1024 是聚类中心数量,也就是倒排列表数量。它属于建库结构参数,索引创建后不能像 nprobe 那样随查询自由调整。搜索时只访问部分列表,因此速度更快,但可能漏掉真实近邻。
import faiss

d = 128
factory = "IVF1024,Flat"
index = faiss.index_factory(d, factory, faiss.METRIC_L2)

# IVF 需要先用有代表性的样本训练聚类中心
if not index.is_trained:
    index.train(train_vectors)

# 训练完成后再添加数据库向量
index.add(database_vectors)

# nprobe 是运行时参数,不属于 Factory 字符串
index.nprobe = 16
distances, ids = index.search(query_vectors, 10)
nprobe 越大,搜索覆盖的倒排列表越多,通常召回更高、耗时也更长。不要只看字符串就宣布“IVF1024 一定更快”,因为最终表现还取决于向量数量、列表是否均衡、查询批量、线程与硬件。
编写代码:用 PQ 或 SQ 控制存储
如果 IVF1024,Flat 的内存仍然太高,可以把末尾的 Flat 换成压缩编码。PQ16 默认每个子量化器使用 8 位码,因此每条向量的 PQ 码主体是 16 字节;SQ8 则按维度做 8 位标量量化。两者都是用精度换空间,但取舍方式不同。
import faiss

d = 128
factory = "IVF1024,PQ16"
index = faiss.index_factory(d, factory, faiss.METRIC_L2)

# IVF 和 PQ 都包含需要从训练集学习的参数
index.train(train_vectors)
assert index.is_trained

index.add(database_vectors)
index.nprobe = 16
distances, ids = index.search(query_vectors, 10)
选择 PQ16 时,要检查变换后的维度是否能被子量化器数量合理切分。128 维可以均分为 16 段;如果前面写了 PCA60,再接 PQ16 就不是一个自然的均分组合。遇到维度不整除时,先调整输出维度或 PQ 的子向量数量,不要靠试错绕过约束。
扩展实验:在最前面加入 PCA 或 OPQ 变换
预处理组件总是放在最前面。PCA64,Flat 把 128 维输入压到 64 维后做穷举;OPQ16_64,IVF4096,PQ16 则先旋转并输出 64 维,让后续 PQ 更容易分配量化误差。PCA 和 OPQ 都需要训练,所以不能创建后直接 add。
import faiss

d = 128
factory = "OPQ16_64,IVF4096,PQ16"
index = faiss.index_factory(d, factory, faiss.METRIC_L2)

# 训练数据应覆盖真实数据库向量的分布
index.train(train_vectors)
index.add(database_vectors)

# 在固定结构上调节查询阶段的速度与召回
params = faiss.ParameterSpace()
params.set_index_parameters(index, "nprobe=32")
distances, ids = index.search(query_vectors, 10)
这里用 ParameterSpace 设置参数,比逐层查找嵌套对象更稳妥。官方把参数明确分成建库参数与运行时参数:Factory 字符串描述前者,nprobe、HNSW 的 efSearch 等属于后者。
运行检查:训练、添加和搜索参数要分开
Factory 字符串写对并不代表索引已经可用。实践中我会按下面四个检查点排查:
- 维度:输入数组第二维必须等于
index_factory的d,而不是 PCA 或 OPQ 的输出维度。 - 训练:只要组合中包含 IVF、PQ、SQ、PCA、OPQ 等需要学习参数的组件,就先看
index.is_trained,训练完成后再入库。 - 数据类型:Python 侧通常准备连续的
float32数组,避免因 dtype 或内存布局造成额外复制和调用错误。 - 对照:用同一批查询把近似索引和 Flat 基线比较,至少记录召回、查询耗时和索引大小。
扩展实验:常见组合怎么选
可以按目标从简单到复杂逐步加组件,而不是一次写出很长的 Factory 字符串:
- 先用
Flat得到精确结果和内存基线。 - 数据量增大且允许近似时,试
IVF1024,Flat或更合适的列表数,并扫描不同nprobe。 - 内存成为瓶颈时,再比较
IVF...,SQ8与IVF...,PQ...。 - PQ 的精度不理想时,才考虑在最前面加入
OPQ;原始维度过高时再评估PCA。 - 每增加一个组件,都保留上一版索引的召回、耗时和大小数据,避免把损失归因错位。
如果只记一个判断顺序,可以记成:Flat 定上限,IVF 定候选,PQ/SQ 定空间,PCA/OPQ 定输入表达,nprobe 定运行时取舍。这样看到复杂字符串时,先按职责拆开,再检查训练和维度约束,通常就不会把粗排、压缩与查询参数混在一起。
参考资料
-
468 收藏
-
268 收藏
-
206 收藏
-
458 收藏
-
478 收藏
-
477 收藏
-
113 收藏
-
438 收藏
-
412 收藏
-
233 收藏
-
354 收藏
-
394 收藏
-
- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-
- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-
- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-
- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-
- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习