
人工智能技术文章
-
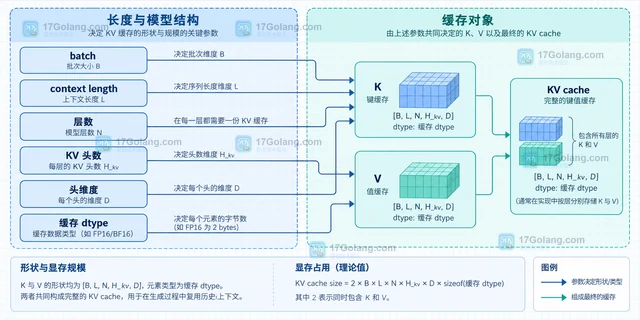 本地部署量化模型时,显存不只由模型参数量决定。本文用权重位宽、上下文长度、KV cache 和运行时余量拆出一套可复用的估算方法,帮助判断量化档位与单卡显存是否匹配。501 收藏
-
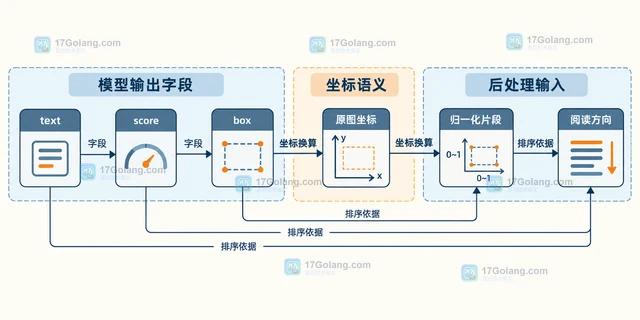 视觉模型返回的 OCR 片段常常不是阅读顺序。本文用统一坐标、垂直中心排序、动态行高阈值和行内 x 排序,把文字框稳定合并成可读文本,并说明多栏、竖排和低置信度结果的边界。461 收藏
-
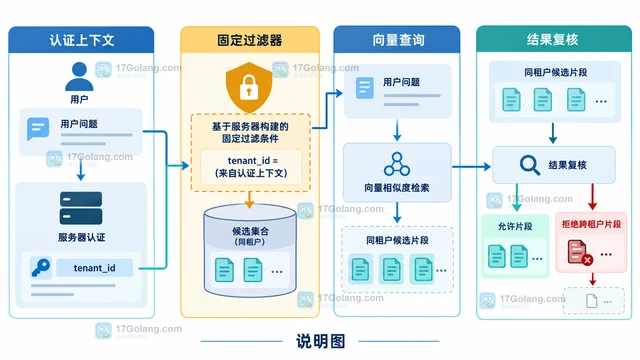 多租户 RAG 不能只在召回后过滤。本文从元数据设计、租户过滤器构造、向量检索和结果复核四个环节,给出一套可迁移的隔离实现方法。433 收藏
-
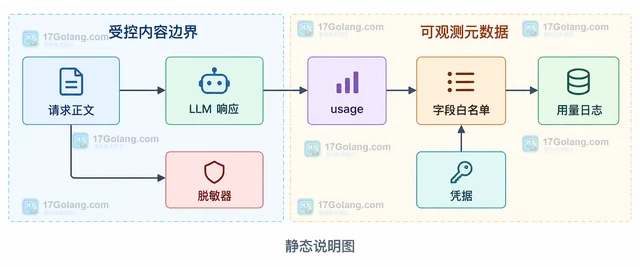 LLM 可观测性不等于把 prompt 和回答原文写进日志。本文以 OpenAI 兼容的 Chat Completion 响应为例,说明怎样记录 prompt_tokens、completion_tokens、total_tokens 等用量元数据,并在应用边界完成字段白名单、敏感信息脱敏和流式 usage 处理。413 收藏
-
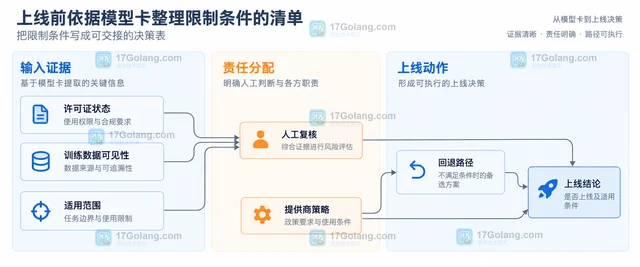 上线 AI 模型前不要只看评测分数。本文围绕模型卡中的许可证、训练数据说明和适用范围,整理一份可交接的限制条件清单,并说明如何把缺失信息、人工兜底和提供商选择写进发布决策。408 收藏
-
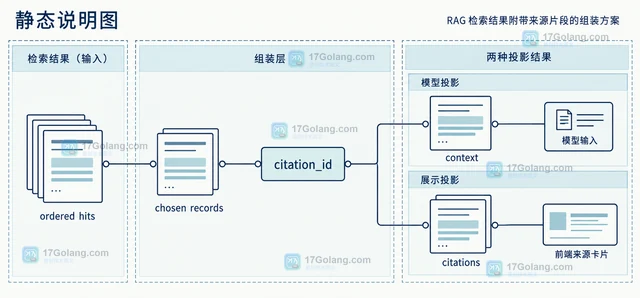 RAG 不要只把命中的文本拼成一段 prompt。本文用统一的切片记录保存来源标识、定位信息和分数,再分别投影为模型上下文与前端引用,处理去重、排序、截断和元数据缺失。407 收藏
-
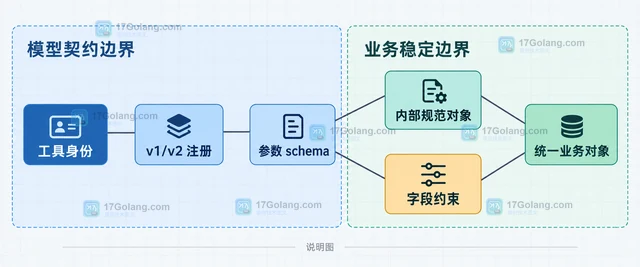 AI 工具的函数参数 schema 不应靠改描述文本维持兼容。本文用 strict schema 的可空字段、v1/v2 工具身份和服务端适配器,说明如何处理新增参数、字段改名、类型变化与调用方迁移,并给出可观察的下线指标。391 收藏
-
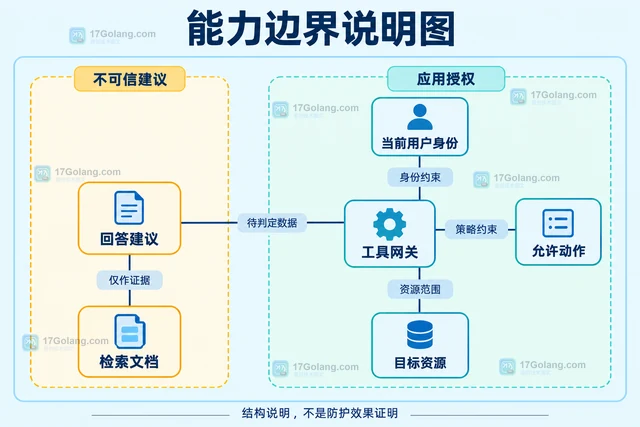 RAG检索片段应保持为不可信证据,而不是新的控制指令。本文讨论上下文分区、只读抽取和应用侧权限判定的取舍,说明提示词与摘要的局限,以及正常引用、过度拒绝和越权风险应分开观察。390 收藏
-
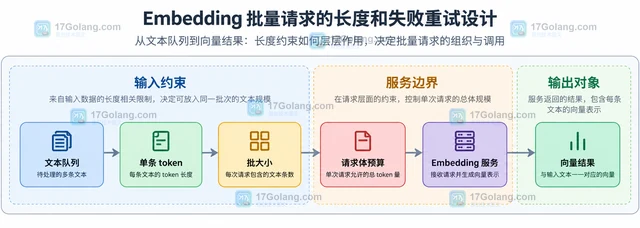 从批大小、单条长度和整批预算三个维度拆分 Embedding 请求,并用有限指数退避处理超时、限流等可恢复失败,避免部分成功后的结果错位。383 收藏
-
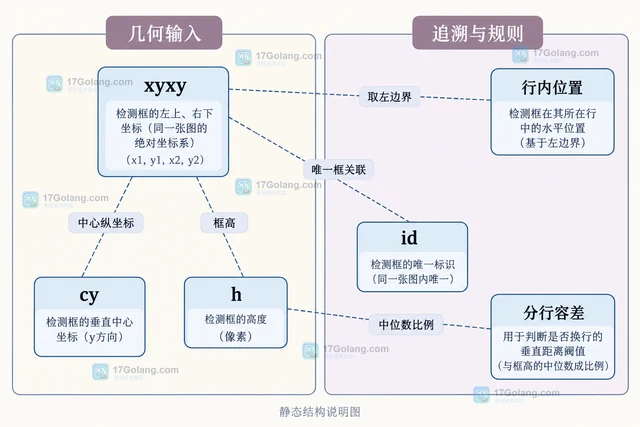 面向单栏横排文本,统一检测框坐标,以固定行锚点分行并在行内按横坐标排序。提供 Python 示例,说明坐标抖动、稳定 ID、多栏与复杂版面的适用边界。375 收藏
-
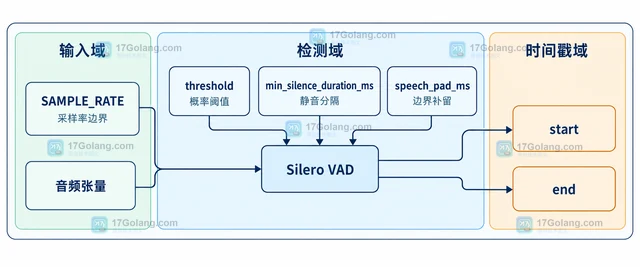 介绍语音转写前用 VAD 检测语音区间的方法,说明采样率、阈值、静音时长、边界 padding 和原始时间偏移如何配合,避免切掉词头词尾或让字幕时间轴失真。371 收藏
-
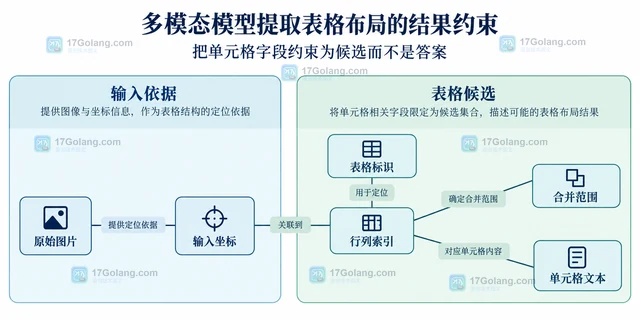 多模态模型提取表格布局需固定行列索引、合并范围与坐标含义,通过字段约束暴露结构冲突,并保留不确定内容与人工复核记录,避免把格式正确当成识别正确。359 收藏
-
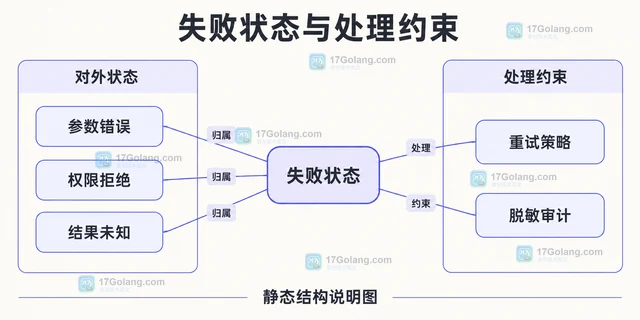 AI Agent工具调用不能把schema通过当作授权通过。本文以工单查询的假设故障区分输入契约、业务约束、可信身份与失败返回,说明权限拒绝、重试和结果未知的处理边界。349 收藏
-
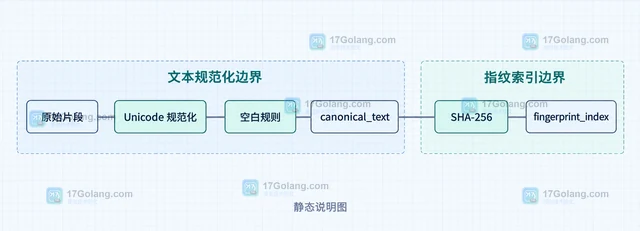 RAG 入库前先做内容指纹,可以在向量化之前拦截完全重复片段,减少重复检索和上下文浪费。本文用 Python 演示文本规范化、SHA-256 指纹、元数据合并,以及近重复候选的处理边界。349 收藏
-
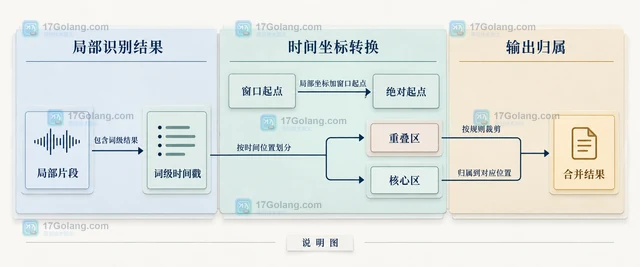 围绕固定窗口、重叠区和绝对时间线,说明长音频语音转文字如何保留边界语音、裁剪重复文本并合并时间戳。324 收藏