
人工智能技术文章
-
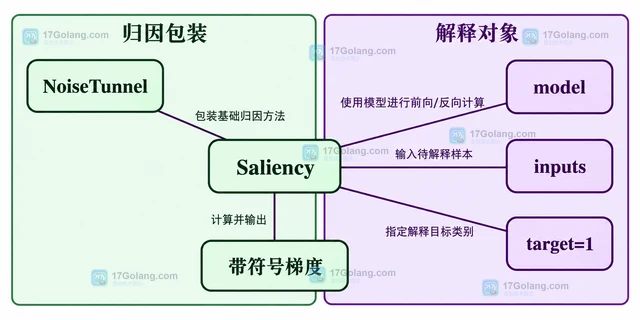 通过固定权重示例说明Captum NoiseTunnel如何包装Saliency完成多次加噪归因,介绍采样数、噪声幅度、分批处理,以及解释服务的资源限制与配置记录。500 收藏
-
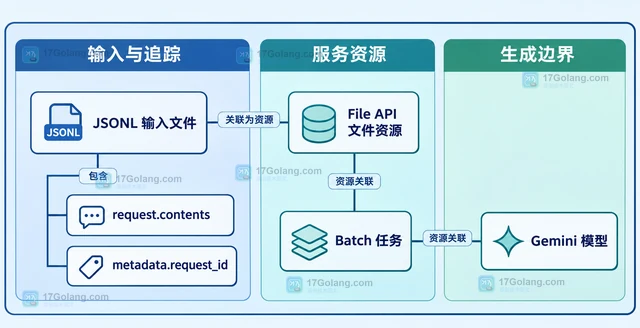 Gemini API Batch 适合输入已准备好、结果不要求实时返回的大量生成任务。本文用 Python 和 JSONL 说明文件上传、批任务创建、状态轮询、逐行结果处理、幂等边界与批次拆分策略。486 收藏
-
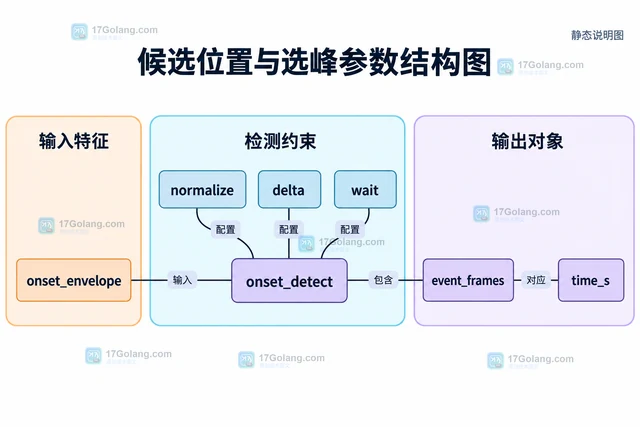 librosa可通过起音强度包络与选峰提取起音位置。本文给出短音频检测函数,说明采样参数、阈值、回溯和空结果处理,帮助区分起音候选、节拍与实际切割边界。484 收藏
-
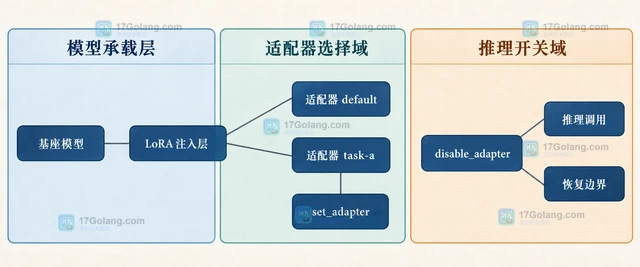 PEFT 中启用和停用 LoRA,关键是区分临时禁用全部适配器、按名称切换活动适配器,以及永久卸载模块。本文用 PeftModel 和 Transformers 两种接口说明调用边界,并给出状态检查清单。483 收藏
-
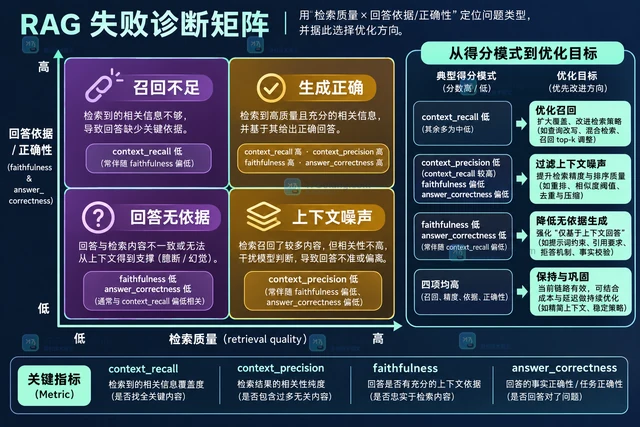 RAG 应用排障不能只盯着最终答案。本文用 context_recall、context_precision、faithfulness 和 answer_correctness 拆分检索与生成问题,并给出一套可接入回归集的评估方法。476 收藏
-
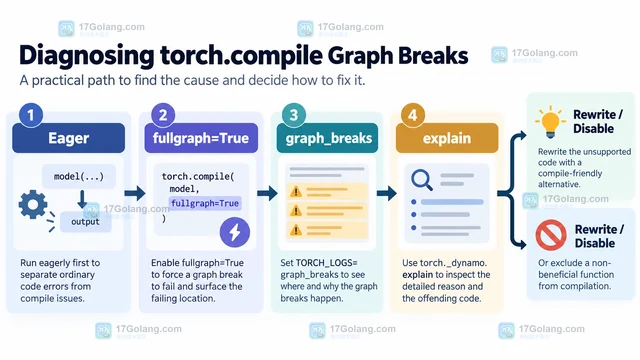 torch.compile 变慢或日志出现多个 FX 图时,先用 eager 基线排除代码错误,再用 fullgraph=True、TORCH_LOGS=graph_breaks 和 torch._dynamo.explain 定位断点。本文按值班手册给出改写、隔离和回退路径。475 收藏
-
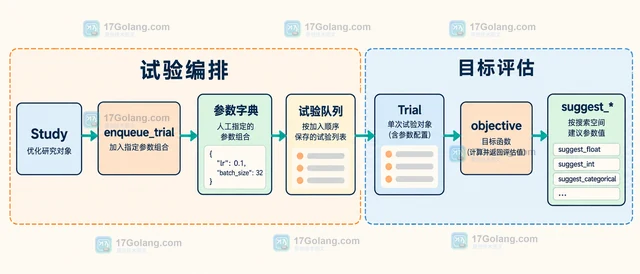 Optuna 的 enqueue_trial 可以把人工指定的参数组合放入试验队列,让 objective 先评估这些候选,再继续交给 sampler 搜索。本文演示调用顺序、skip_if_exists、参数范围和并发边界。472 收藏
-
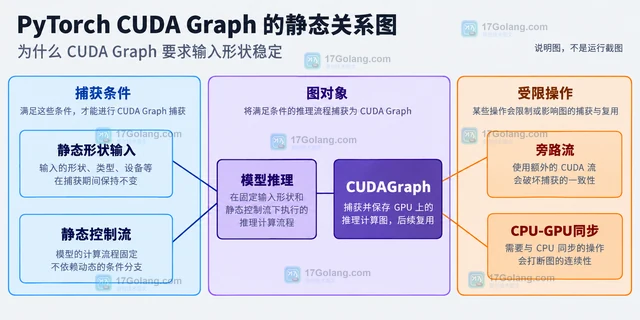 PyTorch CUDA Graph 适合重复执行、输入形状稳定且 CPU 调度开销明显的推理路径。本文用静态输入、旁路流预热、捕获和 replay 说明怎样固定形状复用流程,以及变长请求应该怎样分桶或回退。471 收藏
-
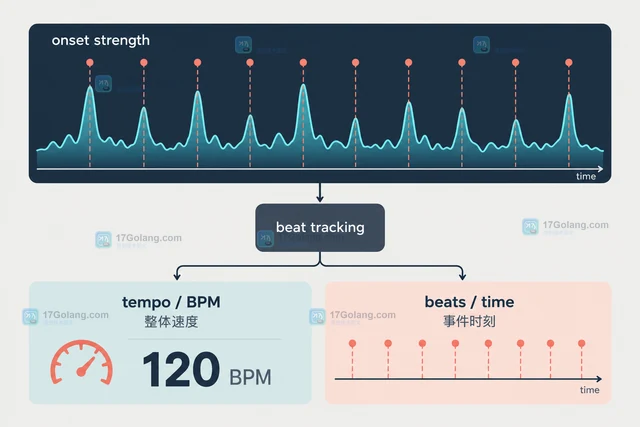 librosa beat_track 返回的 tempo 是速度估计,beats 是节拍事件位置。本文用实际调用拆解两者的单位、稀疏表示、时变 BPM 和常见误判,帮助你把节拍正确对齐到秒或帧。467 收藏
-
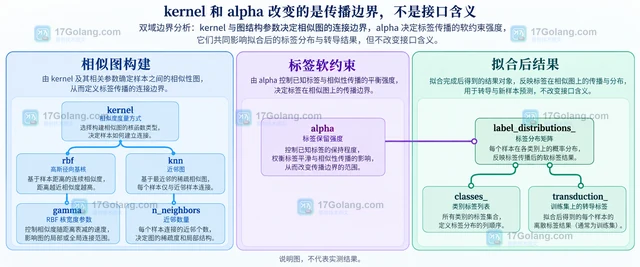 LabelSpreading 的 transduction_ 是 fit 阶段整张训练图上的传导标签,predict 与 predict_proba 则用于拟合后新样本的归纳式推断。本文按样本范围、接口、参数和上线检查清楚区分三者。467 收藏
-
科技周边 · 人工智能 | 2天前 | 异步任务 · 人工智能 · openai · 批处理文件 OpenAI Batch API output_file_id error_file_id output_expires_after
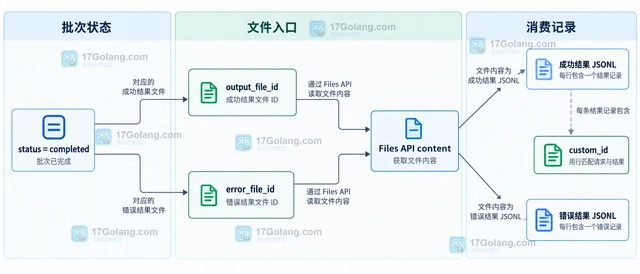 OpenAI Batch API 的 output_expires_after 怎样设置?本文说明 created_at 锚点、seconds 的合法范围,以及如何区分批次完成窗口、输出文件和错误文件的读取时机。460 收藏
-
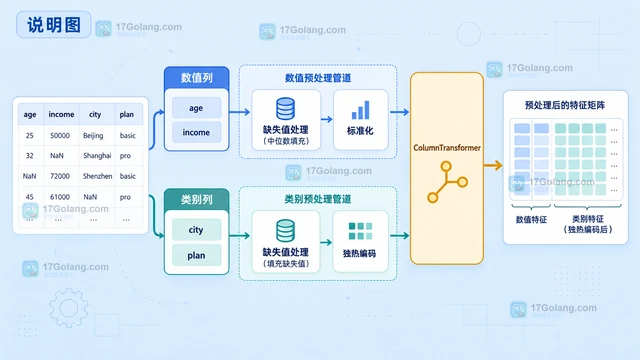 用 scikit-learn ColumnTransformer 把数值列与类别列分开处理:数值列填补并标准化,类别列填补并独热编码,再统一接入 Pipeline,避免列遗漏、未知类别和数据泄漏。459 收藏
-
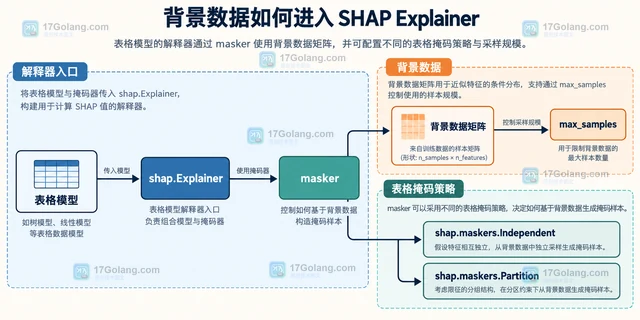 SHAP Explainer 可以用 NumPy 数组或 pandas DataFrame 作为表格背景数据。本文比较 Independent 与 Partition 的遮罩假设,说明 max_samples、特征相关性和字段一致性如何影响解释基线,并给出可直接改造的初始化代码。455 收藏
-
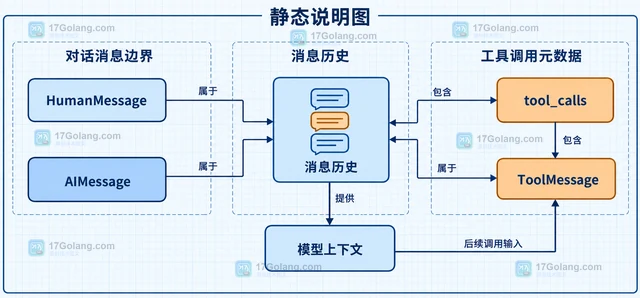 LangChain 工具调用需要保留完整 messages,而不是只取最终文本。本文说明 AIMessage、ToolMessage、tool_call_id、content 与 artifact 的关系,以及如何保存中间消息并继续交给模型。450 收藏
-
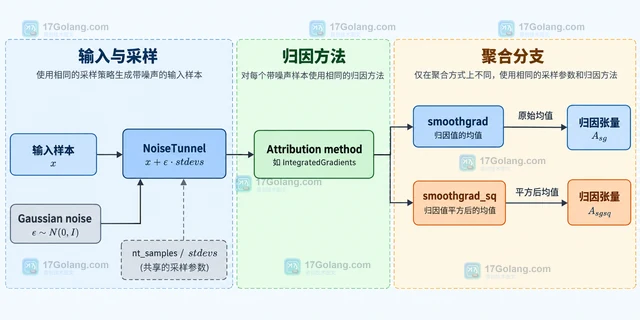 Captum NoiseTunnel 的 SmoothGrad 与 SmoothGradSquared 都会对加噪输入重复计算归因,但前者聚合原始归因均值,后者聚合平方后的归因均值。本文用公式、代码和选型表说明符号、强度与参数边界。450 收藏