-
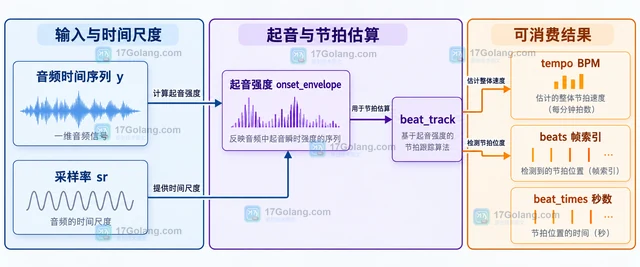
用 librosa.beat.beat_track 从音频的起音强度中估算 BPM 和节拍位置,并把帧索引稳定转换为秒;同时说明空结果、BPM 为 0 和 hop_length 不一致时怎样排查。
-
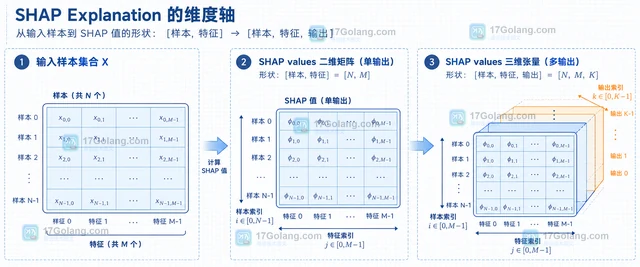
SHAP Explanation 的 values 形状需要结合样本、特征和模型输出一起读取。本文用单输出与多输出示例说明 shape、feature_names、output_names 的对应关系,以及如何按样本和输出安全切片。
-
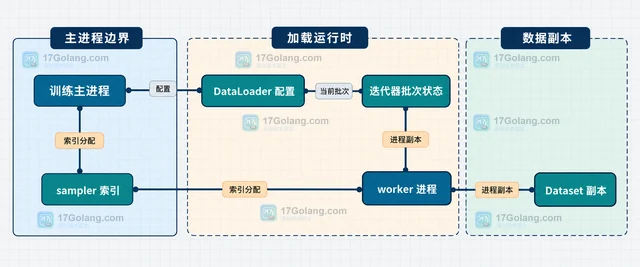
本文说明 PyTorch DataLoader 的 persistent_workers 如何影响 worker 进程、迭代器和 Dataset 副本的生命周期,给出跨 epoch 复用的最小配置,并说明内存、状态管理、IterableDataset 分片和调试边界。
-
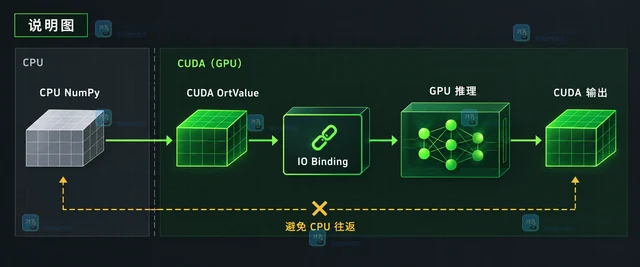
说明 ONNX Runtime Python 推理中 IO Binding 的设备驻留方式:用 CUDA OrtValue 绑定输入、在 GPU 上绑定或分配输出,并判断何时应该回传 CPU。
-
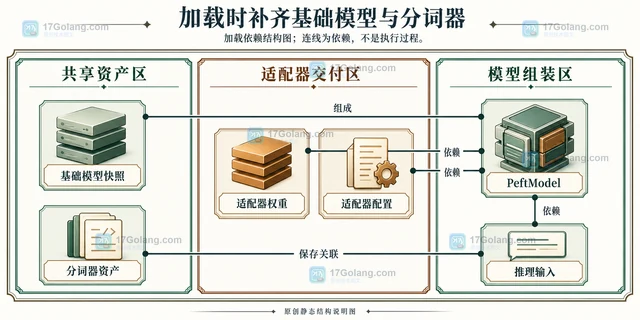
通过 PeftModel.save_pretrained 导出 LoRA 适配器,说明额外训练模块、嵌入层、基础模型依赖与训练断点的区别,并提供参数体积推算和文件统计写法。
-
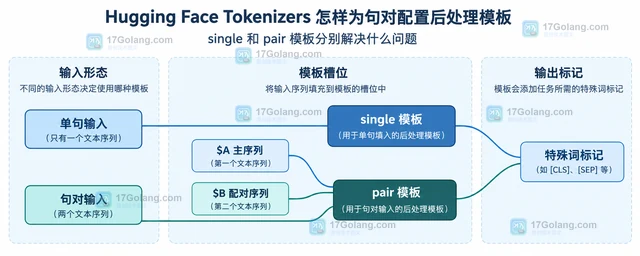
用 TemplateProcessing 为 Hugging Face Tokenizers 配置 single 与 pair 模板,说明 $A、$B、special_tokens 和 type_id 的对应关系,并整理句对长度与常见配置错误。
-
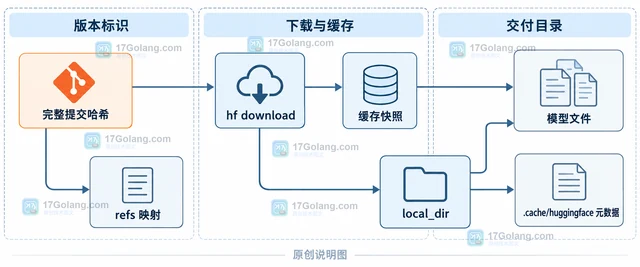
用 Hugging Face Hub 的 revision 参数固定分支、标签或完整提交哈希,分别演示 hf_hub_download、snapshot_download 和 hf download 的单文件、整仓库与 local_dir 交付边界。
-

用 tokenizers.normalizers.Sequence 按顺序组合 NFD、Lowercase、StripAccents 等正规化器,说明如何挂到 Tokenizer、观察结果并保留对齐信息。
-

JiWER 计算语音识别误差时,参考文本与识别文本必须经过相同的正规化规则。本文用 Compose 组合清理与替换步骤,并将同一个变换对象同时传给两侧,说明 WER、CER 和自定义词替换的写法。
-

Captum IntegratedGradients 返回的 convergence delta 是完整性差值的逐样本近似误差信号。本文说明它比较什么、如何读取,以及怎样结合 n_steps 和 method 做有边界的判断。
-
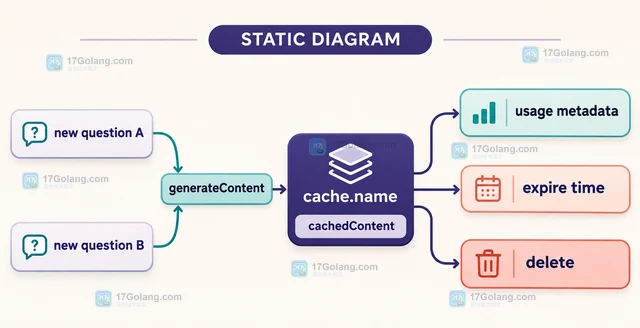
Gemini API 复用长文档的关键是创建显式 context cache,后续请求只发送新问题并引用 cachedContent。本文用 Python 示例说明 Files API、TTL、模型绑定、usage metadata 与文档版本切换。
-
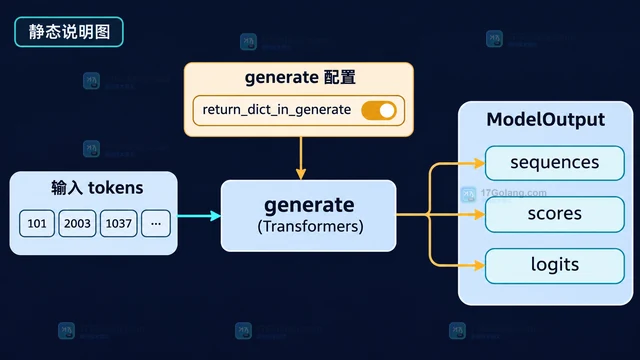
Transformers generate 的 output_scores 与 output_logits 都保存生成步分数,但前者是经过生成处理的 scores,后者更接近未处理的模型 logits。本文说明返回开关、数据结构和实际选择方法。
-

JiWER 不只返回 WER 数字,还能通过 process_words 得到逐句的 AlignmentChunk 对齐对象。本文说明 WordOutput.alignments 的结构、四类词位操作、四个索引字段,以及如何用 visualize_alignment 输出可读的对齐文本。
-
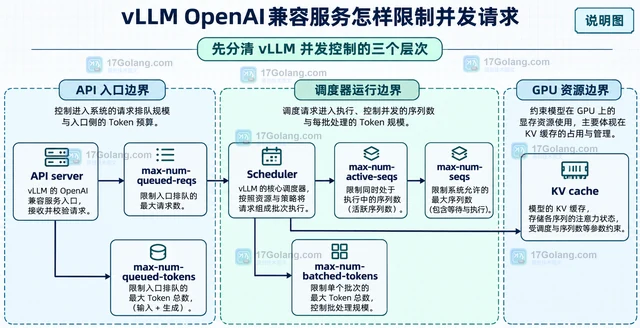
vLLM OpenAI 兼容服务的并发限制要分三层:入口请求队列、运行态序列数和 token 预算。本文给出启动参数组合、503 边界与客户端退避思路。
-
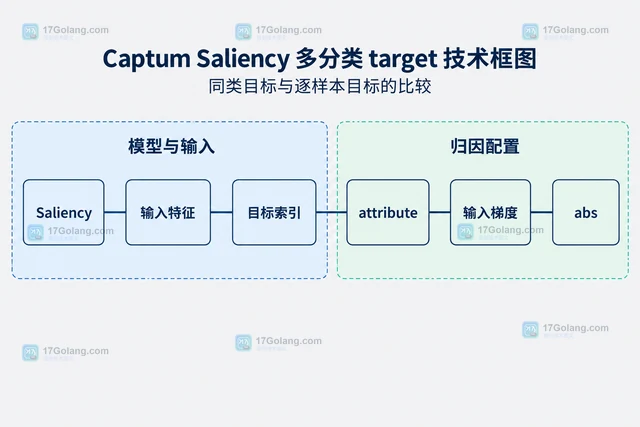
Captum Saliency 对多分类输出需指定归因目标。本文用线性三分类模型演示统一类别与逐样本 target,说明梯度形状、abs 参数及真实模型接入条件。
