
人工智能技术文章
-
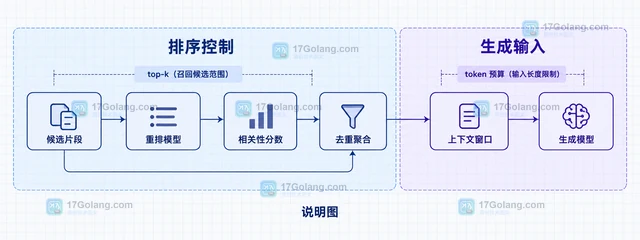 RAG 检索结果很多却答不准时,先区分召回缺失、候选过杂和上下文丢失,再从语义切块、混合召回、元数据过滤、重排和固定评测集逐层改进。208 收藏
-
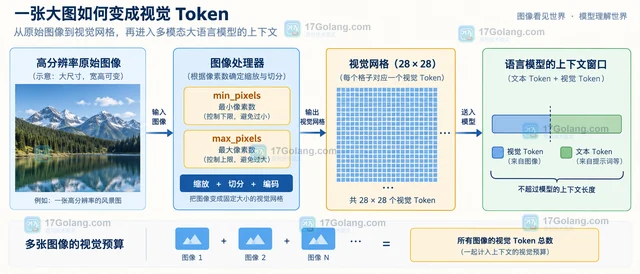 多模态模型的视觉令牌主要受图片预处理分辨率和图片数量影响。本文以 Transformers 与 Qwen2.5-VL 为例,说明如何用 min_pixels、max_pixels 和任务分级配置控制显存、延迟与识别细节。196 收藏
-
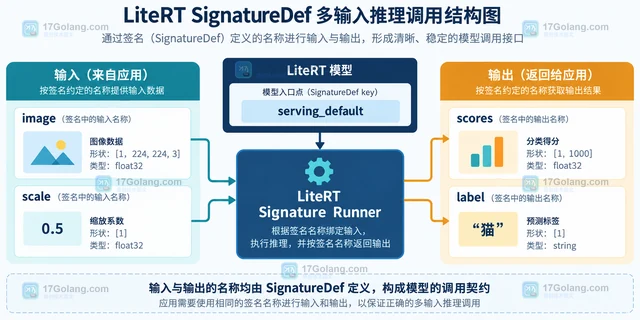 LiteRT 多输入模型接入时,不要把 tensor index 当成调用契约。本文从 signature key、输入输出名称和张量形状入手,演示如何读取签名、准备多个输入、执行 signature runner,并排查名称与并发边界。191 收藏
-
科技周边 · 人工智能 | 18小时前 | 人工智能 · Transformers DataCollatorForSeq2Seq label_pad_token_id loss mask seq2seq
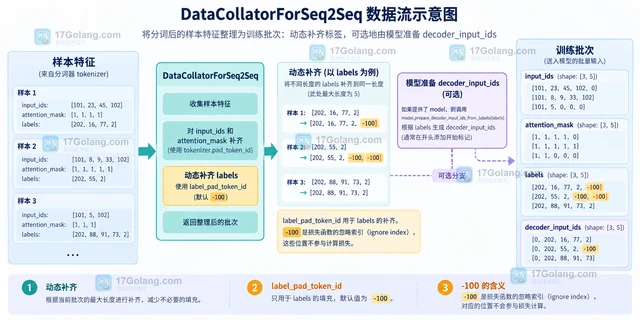 训练翻译或摘要模型时,DataCollatorForSeq2Seq 的 label_pad_token_id 会决定补齐标签是否进入 loss。本文从 -100 的忽略语义、动态补齐和 decoder_input_ids 准备三条链路拆开排查。176 收藏
-
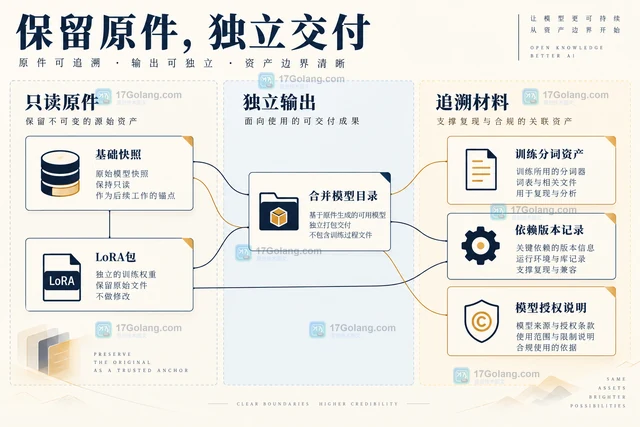 从文件职责、配置来源和参数命名区分LoRA适配器与基础模型,说明单适配器合并的适用范围、独立输出目录及回滚材料,避免把适配器误当完整模型交付。174 收藏
-
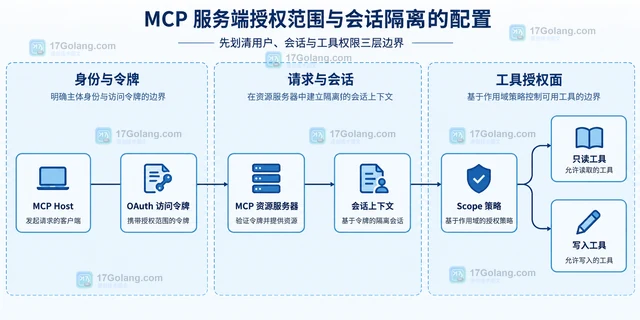 从 HTTP 令牌校验、scope 工具映射、请求级授权上下文和审计字段四个层面,说明如何配置 MCP 服务端的授权范围与会话隔离,避免主体、租户和写入权限混用。161 收藏
-
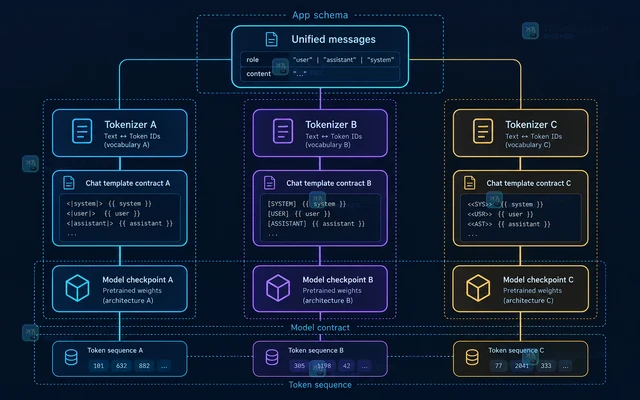 多模型服务应统一 role/content 消息结构,而不是硬编码一套控制 token。本文用 tokenizer.apply_chat_template 建立模型契约层,区分普通回复、预填续写与训练格式,并说明特殊 token 和能力边界。154 收藏
-
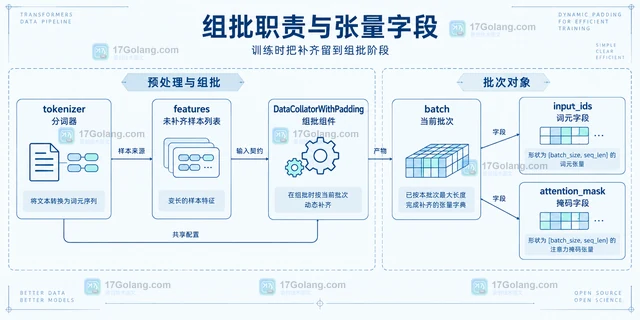 比较Transformers批次分词的动态补齐与固定长度补齐,说明截断上限、collator组批职责和部署形状约束,并给出可复制代码与实际观测指标。153 收藏
-
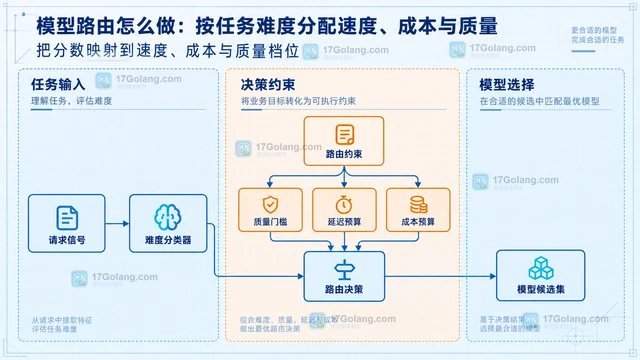 模型路由不只是按名称转发请求,而是根据任务难度、质量门槛、延迟预算和相对成本选择模型。本文用一个 Python 小项目实现可解释分类、分档选择、失败回退、质量升级和离线评测。147 收藏
-
科技周边 · 人工智能 | 6小时前 | 人工智能 · Hugging Face Datasets streaming IterableDataset Dataset.shuffle shuffle buffer
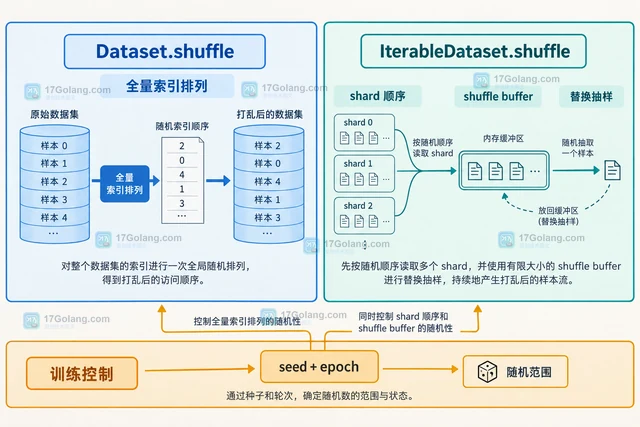 Hugging Face Datasets 的 Dataset.shuffle 会为内存数据集建立全量索引映射,IterableDataset.shuffle 则通过 shard 顺序和有限 shuffle buffer 做近似随机。本文解释两者的访问模型、随机范围、性能代价与训练参数选择。130 收藏
-
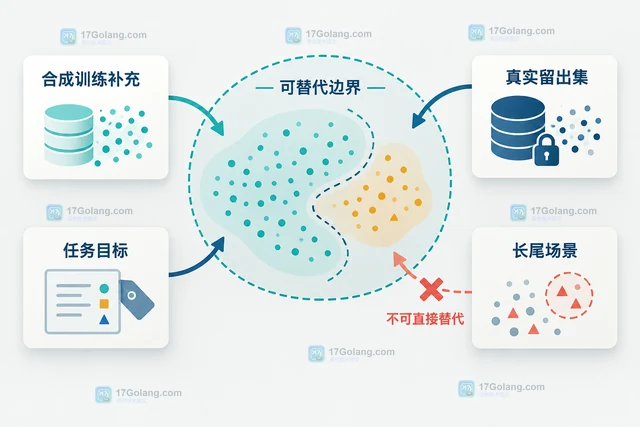 合成数据不能仅凭外观接近真实样本就直接替代。本文从覆盖率、分布与相关关系、真实留出集任务效果、偏差和隐私四层检查,说明如何决定它适合补充、加权使用还是禁止替代。128 收藏
-
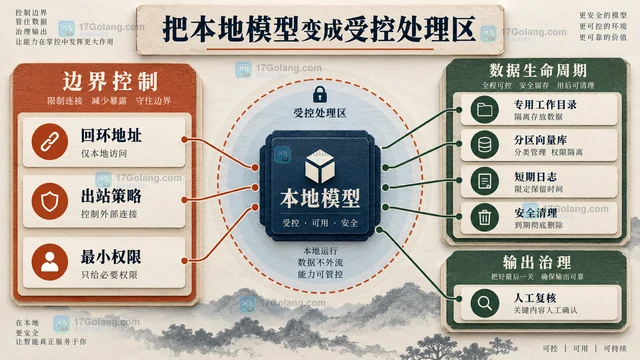 本地模型只缩短了资料到推理引擎的链路,并不会自动封闭插件、日志、向量库、监听端口、同步备份和输出协作等路径。本文用“本地受控处理区”模式梳理常见泄露面、典型实现、反例和上线检查清单。127 收藏
-
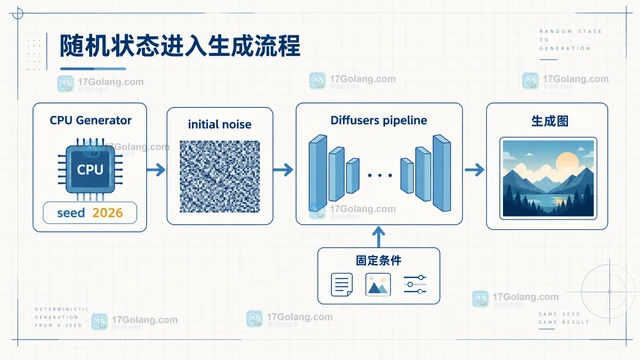 Diffusers 生成结果每次不同,通常与随机状态和采样条件有关。本文用 CPU torch.Generator 说明怎样固定初始噪声、每次重新播种,并整理模型、提示词、步数和调度器的复现清单。118 收藏
-
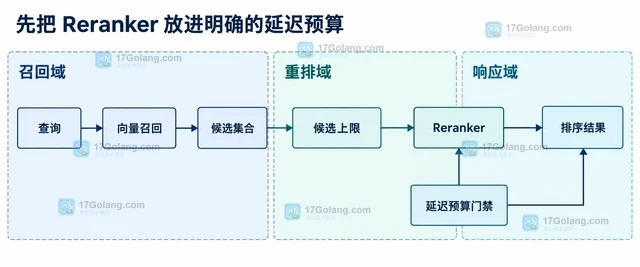 Reranker 通常只应处理召回后的有限候选。本文从延迟预算、候选规模、输入长度、批量和超时降级几个方面,给出一套可落地的检索重排控制方案。113 收藏
-
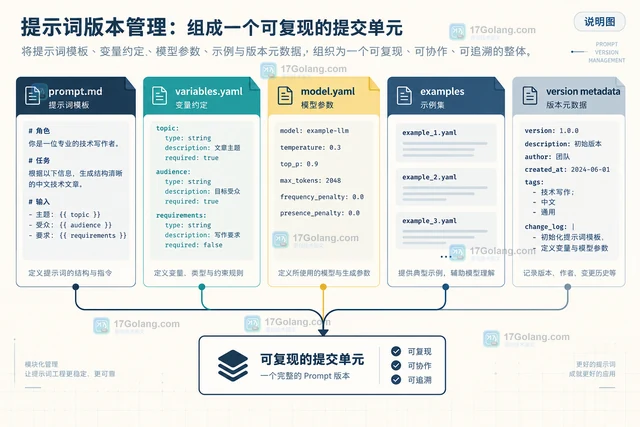 把提示词模板、变量契约和固定回归样例放进同一次 Git 提交,配合输入哈希、模型参数与可回退版本,解决改完提示词却无法复现和比较的问题。111 收藏