
PEFT LoraConfig 怎样只训练指定模块
来源:17golang原创
时间:2026-11-19 13:33:25 289浏览 收藏
如果你只想微调 Transformer 的注意力投影层,关键不是把 target_modules 写得越多越好,而是让它准确匹配模型里的真实模块名。PEFT 的 LoRA 会把适配器放到匹配到的模块上,其他基础权重继续保持冻结;因此“只训练指定模块”的核心就是选择规则,而不是额外手动冻结一遍模型。
官方文档:https://huggingface.co/docs/peft/package_reference/lora
这篇只讨论 LoraConfig 的目标模块匹配、排除模块和额外保存模块,不展开数据集、训练器或量化参数。
先把接口目标说清楚:训练的是适配器
调用方通常有两个要求:一是只在指定层注入 LoRA,二是保存结果时不要把整个基础模型都变成可训练参数。最小配置可以这样写:
from peft import LoraConfig, get_peft_model

# 只把注意力中的 query、value 投影作为 LoRA 目标
config = LoraConfig(
    r=8,                         # rank 越大,适配器参数越多
    lora_alpha=16,               # 控制 LoRA 缩放系数
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,           # 训练时对适配分支做轻微 dropout
    bias="none",                # 不额外训练基础层 bias
    task_type="CAUSAL_LM",
)
peft_model = get_peft_model(base_model, config)
peft_model.print_trainable_parameters()  # 用摘要确认可训练参数规模
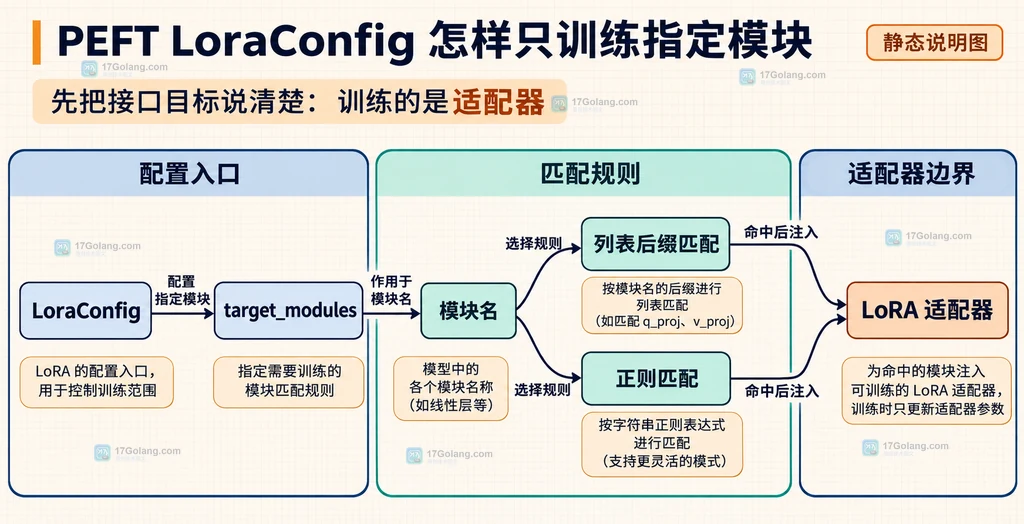
这里的 q_proj 和 v_proj 不是要求完整路径,而是列表项的模块名后缀。只要模型中的模块名称以这些字符串结尾,就可能被选中。不同架构可能叫 query、value 或其他名字,所以不能直接照抄另一种模型的配置。
参数设计:列表后缀和字符串正则是两套语义
target_modules 传列表时,PEFT 会按完整名称或名称后缀匹配;传单个字符串时,则按正则表达式匹配。窄范围选择建议使用列表,规则化选择才使用正则:
# 列表:只匹配名称等于 q_proj 或以 q_proj 结尾的模块
config_by_suffix = LoraConfig(
    target_modules=["q_proj"],  # 中文含义:只选 query 投影这一类模块
)

# 字符串:用正则表达式表达更细的命名规则
config_by_regex = LoraConfig(
    target_modules=r".*\.self_attn\.(q_proj|v_proj)$",  # 中文含义:只选注意力里的 q/v 投影
)

# 只有确实想覆盖模型全部线性层时,才使用这个保留字
config_all_linear = LoraConfig(
    target_modules="all-linear",  # 中文含义:按模型线性层规则选择,而不是手写名称
)
“只训练指定模块”通常不应从 all-linear 开始,因为它会扩大范围。需要覆盖 QLoRA 常见的全部线性层时才使用它;如果模型架构无法自动识别目标模块,才回到手动列表。
排除误匹配,区分模块训练和模块保存
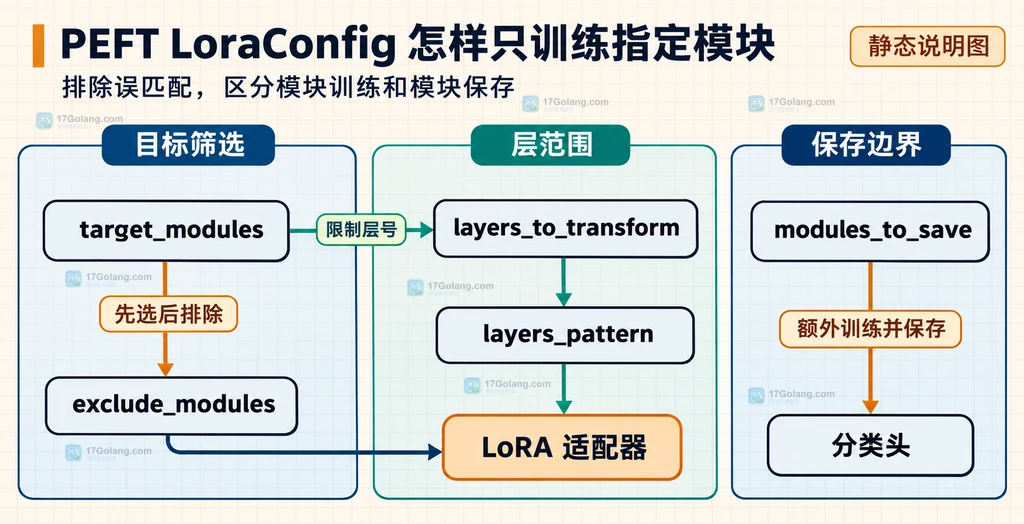
当后缀匹配覆盖面过大,可以用 exclude_modules 再收窄。它与 target_modules 使用相同的列表后缀或字符串正则思路。另一个容易混淆的参数是 modules_to_save:它表示适配器之外还要设置为可训练并保存的模块,不是 LoRA 的目标模块替代品。
config = LoraConfig(
    target_modules=["q_proj", "v_proj"],
    exclude_modules=["cross_attn.q_proj"],  # 中文含义:排除一个不想注入 LoRA 的分支
    modules_to_save=["classifier"],          # 中文含义:分类头全量训练并写入检查点
    bias="none",                             # 中文含义:保持基础层 bias 不参与训练
)

# 先打印名称,再根据真实命名决定是否需要排除或保存额外模块
for name, module in base_model.named_modules():
    if name.endswith(("q_proj", "v_proj", "classifier")):
        print(name, type(module).__name__)  # 中文含义:只观察候选模块,不执行训练
可以把三者记成一句话:target_modules 决定“哪里加 LoRA”,exclude_modules 决定“哪些匹配结果不要加”,modules_to_save 决定“哪些额外模块按自身参数训练并保存”。
错误处理与兼容:先看名字,再决定匹配范围
最常见的“没有按预期训练”不是 LoRA 失效,而是模块命名不一致。先从 named_modules() 中找出真实路径,再选择后缀或正则;不要因为没有报错就认为目标命中了。对层数很多的模型,还可以配合 layers_to_transform 和 layers_pattern 限制某个模块列表中的层号。
如果同一后缀同时出现在 self-attention、cross-attention 或其他分支,优先改用带父路径的正则;如果只想训练少数层,则同时写明层模式和层索引。这样做比在训练完成后猜测“到底哪些参数更新了”更容易维护。
最后检查三件事:目标模块名称是否真实存在;排除规则是否误伤目标;modules_to_save 是否确实是需要全量训练的模块。确认这三点后,再扩大 target_modules 范围或切换到 all-linear,否则适配器大小和显存都会无谓增加。
常见问题
target_modules 写列表时必须写完整路径吗?
不必须。列表项可以是完整模块名,也可以是模块名后缀;但如果同一后缀在多个分支出现,就应改用更精确的正则或配合排除规则。
想训练分类头,应该把它放进 target_modules 吗?
如果分类头需要按自身参数全量训练,通常放进 modules_to_save 更直观;target_modules 仍只表达 LoRA 注入位置。
小结:先用真实模块名确定范围,再用列表后缀完成窄匹配,用正则表达分支边界,用 exclude_modules 排除误命中,用 modules_to_save 管理额外全量训练模块。
-
234 收藏
-
173 收藏
-
369 收藏
-
284 收藏
-
387 收藏
-
240 收藏
-
382 收藏
-
258 收藏
-
132 收藏
-
202 收藏
-
309 收藏
-
258 收藏
-
389 收藏
-
346 收藏
-
316 收藏
-
429 收藏
-
283 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习