-
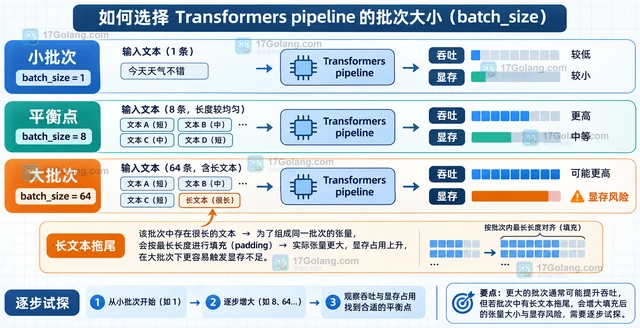
Transformers pipeline 支持列表、Dataset 和生成器输入。本文用文本分类场景说明如何设置 batch_size,解释 padding 与长文本造成的显存风险,并给出从小批次开始、同时记录吞吐和峰值显存的可回退配置方法。
-
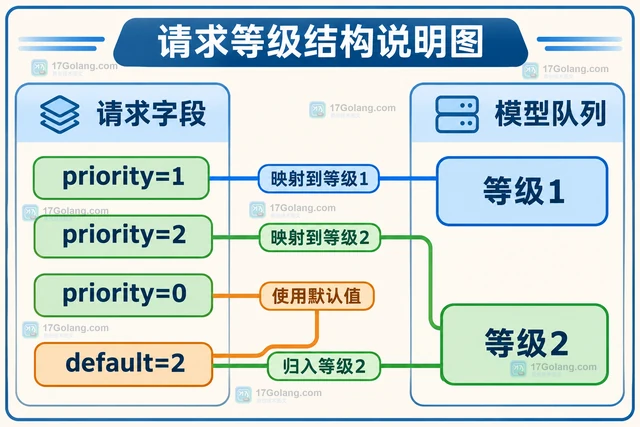
说明 Triton dynamic batcher 的优先级等级、客户端 priority 参数和各级 queue policy,并给出分组延迟、拒绝率与吞吐的对照测量方法。
-
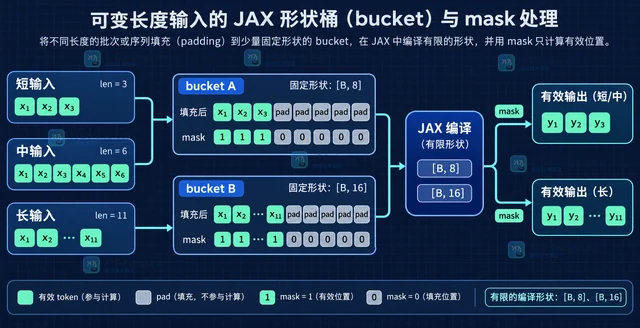
JAX jit 的缓存键包含输入的 shape 和 dtype,动态批次、可变序列长度或静态参数变化都可能触发重新编译。本文从日志定位入手,用 padding、分桶和稳定函数定义减少重复编译,并说明持久化编译缓存的适用边界。
-
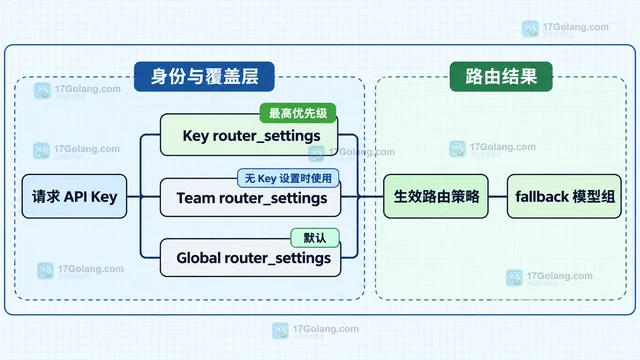
LiteLLM Proxy 支持按 Key、Team、Global 的层级解析 router_settings。本文用一个具体配置说明如何给不同 API Key 设置独立 fallback、timeout、num_retries 和故障冷却,并解释权限与配置覆盖关系。
-
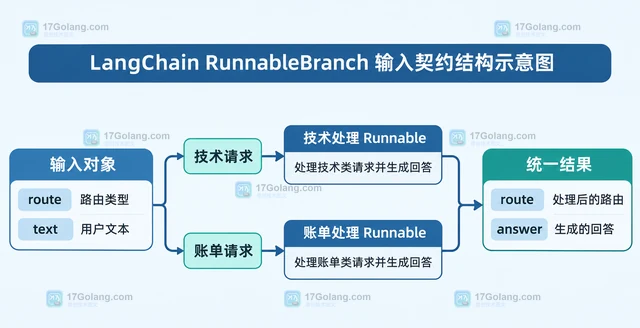
LangChain RunnableBranch 通过条件与 Runnable 对组成输入路由,按条件顺序选择第一个匹配分支,并用默认 Runnable 兜底。本文用统一输入输出契约演示如何构造、串接和控制它。
-
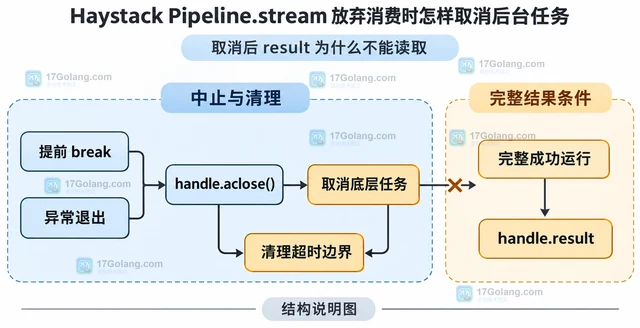
Haystack Pipeline.stream 返回可异步迭代的 PipelineStreamHandle。停止消费流式结果时,建议在 try/finally 中显式调用 await handle.aclose(),取消底层任务并完成有界清理;取消后的 handle.result 不可作为最终结果读取。
-
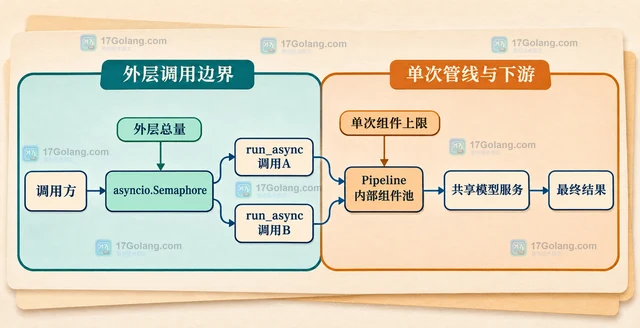
Haystack 的 Pipeline.run_async 可以用 concurrency_limit 限制一次异步管线中同时运行的组件数量。本文区分单次管线、多个调用和组件内部线程池三个边界,并给出 Python 调用示例。
-
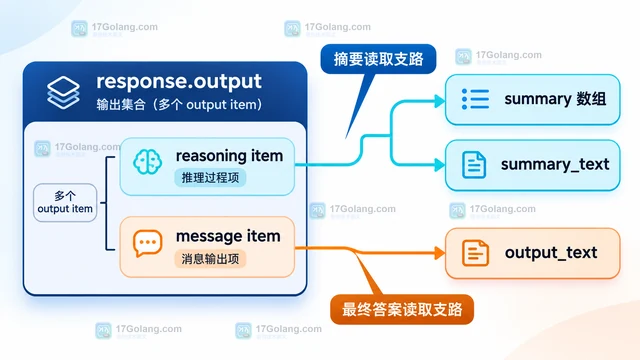
Responses API 不会默认返回 reasoning summary。本文用 reasoning.summary 开启摘要,遍历 reasoning output item 读取 summary_text,并说明 effort、output_text 与模型支持差异。
-
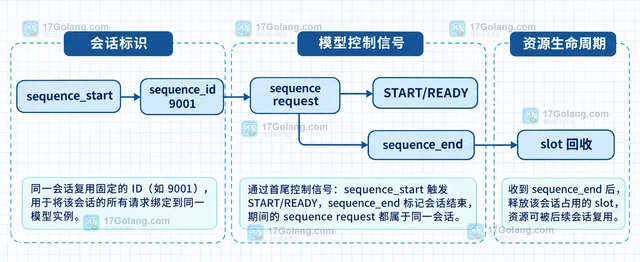
本文围绕 Triton sequence batcher 的 direct scheduling,说明 sequence_id、模型实例、batch slot 和 sequence 控制信号如何配合,让同一会话持续落到同一有状态模型实例;同时区分 direct 与 oldest 策略中 correlation ID 的职责。
-
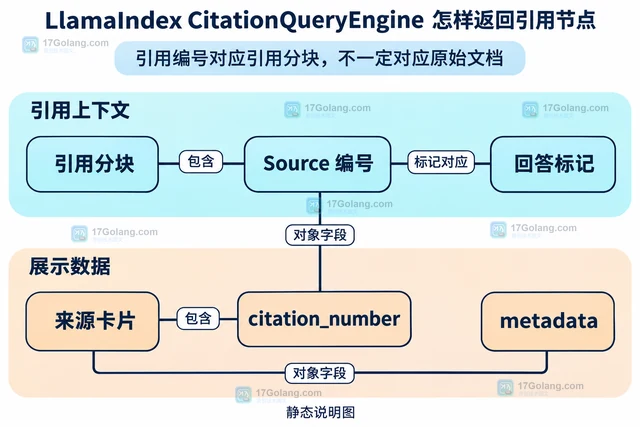
保留 CitationQueryEngine 的响应对象即可读取 source_nodes。通过示例整理引用节点、编号和来源卡片,说明分块粒度、元数据缺失、响应类型与前端展示的适用边界。
