
LiteRT int8 量化结果异常时怎么检查代表性数据集的输入范围
来源:17golang原创
时间:2026-10-13 07:36:23 348浏览 收藏
我第一次遇到 LiteRT int8 输出范围异常时,直觉是怀疑量化算法或模型精度;后来把转换前后的输入链路并排记录,问题大多落在代表性数据集:它和真实推理使用了不同的归一化、shape、dtype,或者样本根本没有覆盖线上输入的范围。
官方地址:https://ai.google.dev/edge/litert/models/post_training_quantization
full integer quantization 需要用代表性数据集估计浮点输入、激活和输出张量的范围。排查 int8 异常时,先把代表性数据集当成“校准输入契约”检查,而不是先改量化参数。
- 代表性样本必须复用真实推理的预处理:缩放方式、通道顺序、shape、dtype 和批次维度都要一致。
- 多输入模型优先使用签名键映射,避免位置列表把输入顺序传反。
- 校准数据追求真实分布覆盖,不是随机生成越多越好;要包含正常样本、边界样本和容易误判的样本。
先把异常归因到校准输入链路
LiteRT 官方把 full integer quantization 描述为对浮点张量的范围进行校准。权重和偏置可以直接处理,但输入、隐藏层激活和输出的范围需要通过若干推理周期估计,因此转换器需要代表性数据集。这里最有用的架构模式不是“再加一个校准开关”,而是把输入链路分成四层:真实预处理、代表性样本、范围校准和 int8 输入。
我现在会先做一个非常小的归因:同一个模型先保留浮点转换结果,再观察量化版本的异常。如果浮点版本的输入输出关系正常,而 int8 版本异常,排查范围就应收缩到校准输入和量化算子,而不是立即重写模型。
# 先保留浮点基线,再为 int8 转换提供同一份代表性数据
import tensorflow as tf

converter = tf.lite.TFLiteConverter.from_saved_model("saved_model")
converter.optimizations = [tf.lite.Optimize.DEFAULT]
converter.representative_dataset = representative_dataset

# 只有在输入契约确认一致后,才强制所有算子使用 int8
converter.target_spec.supported_ops = [tf.lite.OpsSet.TFLITE_BUILTINS_INT8]
converter.inference_input_type = tf.int8
converter.inference_output_type = tf.int8
quantized_model = converter.convert()
这段配置本身不是答案。真正的判断点是:representative_dataset 产生的每一个张量,是否就是应用推理时会送入模型的张量。只要这一层不一致,后面看到的 scale、zero_point 或输出范围都可能只是错误输入的结果。
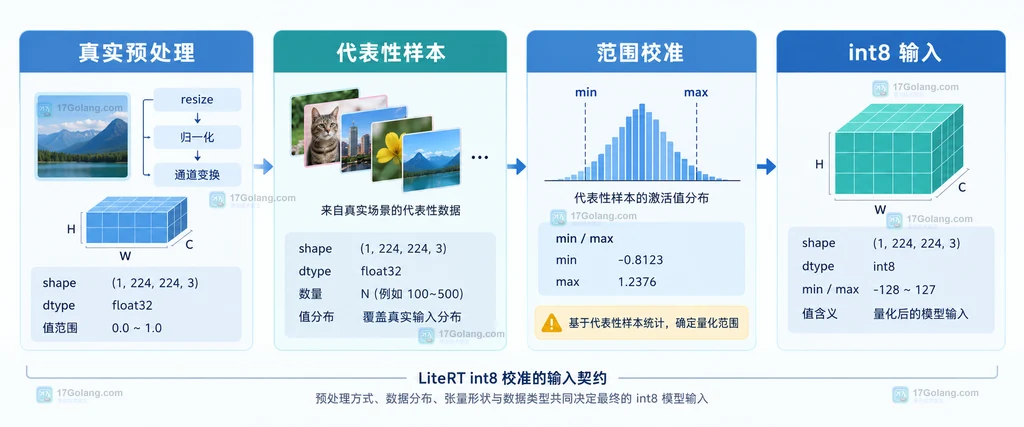
固定代表性样本的预处理契约
最容易忽略的是“数据看起来对,但数值已经变了”。例如线上推理把像素从 uint8 0..255 转成 float32 -1..1,代表性数据却直接把原始像素送入转换器;模型仍然可能完成转换,但校准看到的是另一种输入分布。
我会把预处理单独写成一个函数,并让真实推理和代表性数据共同调用它。函数里不只记录归一化公式,还要明确通道顺序、裁剪策略和批次维度。
# 真实推理和校准数据共用这条预处理路径,避免范围漂移
def preprocess(image):
    image = image.resize((224, 224))       # shape 要与模型输入契约一致
    image = image.convert("RGB")          # 固定通道顺序,避免灰度或 RGBA 混入
    values = np.asarray(image, dtype=np.float32)
    values = values / 127.5 - 1.0         # 明确记录线上使用的归一化公式
    return values[None, ...]               # 增加 batch 维度,得到 [1, 224, 224, 3]

def representative_dataset():
    for image in calibration_images:
        # 每个样本都走与真实推理相同的预处理,不在这里临时换公式
        yield [preprocess(image)]
这一步我会重点看四项:最小值和最大值是否落在预期区间,数组的 shape 是否包含 batch 维,dtype 是否是转换器期待的类型,以及 RGB/BGR 或 NHWC/NCHW 是否发生过隐式调整。不要只打印一张样本;至少要观察一小批样本的统计范围。
用签名键和形状检查多输入模型
单输入模型的问题通常比较直观,多输入模型更容易出现“数据都传进去了,但传给了错误的入口”。LiteRT 官方示例支持按 signature 提供命名输入,也支持输入张量列表;官方建议优先使用签名方式,因为位置列表的输入顺序容易翻转。
# 多输入模型用签名键表达语义,避免 image 和 bias 位置错位
def representative_dataset():
    for image, bias in calibration_pairs:
        # shape 和 dtype 在生成数据时就固定,不等转换器猜测
        yield (
            "encode",
            {
                "image": preprocess(image),
                "bias": np.asarray(bias, dtype=np.float32),
            },
        )
如果只能使用位置列表,就把模型的输入顺序写进记录,并在转换前对照签名检查一次。特别要留意同一个模型可能有多个 signature:每个 signature 的输入集合、shape 和数据语义并不一定相同,不能拿一套样本无条件喂给所有入口。
我会把这几个字段作为一次校准的最小记录:signature 名称、输入名、shape、dtype、预处理版本和样本来源。它们比“这次用了 100 张图”更能解释校准范围为什么发生变化。
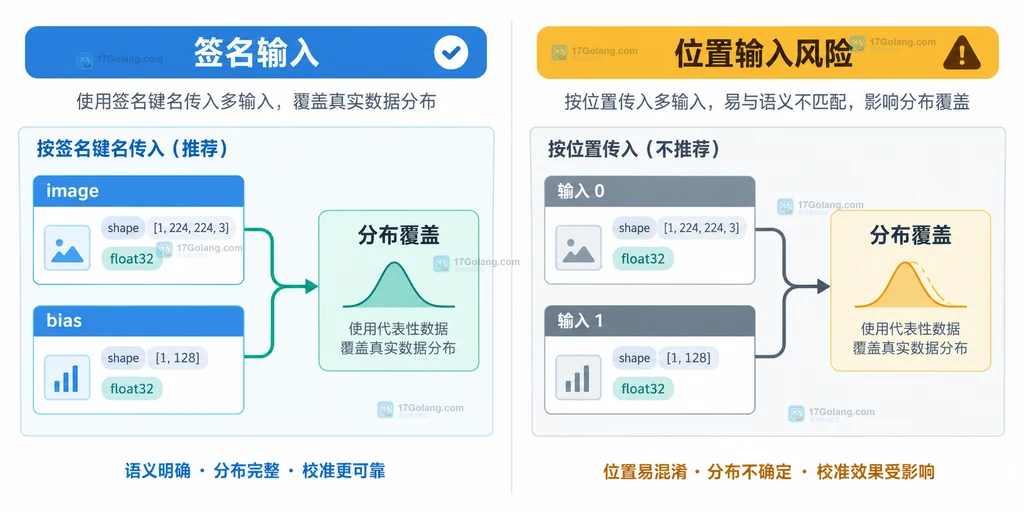
用分布覆盖而不是随机样本补齐范围
代表性数据集的任务是让转换器看到真实输入和中间激活可能经过的区域。官方文档给出的示例量级是训练或验证数据中的小子集,常见说明范围约为 100 到 500 个样本;这不是所有模型都必须遵守的固定数字,关键仍是样本是否代表真实输入。
我通常把样本分成三层:
| 样本层 | 应该覆盖什么 | 排查价值 |
|---|---|---|
| 常态样本 | 线上最常见的亮度、尺寸、类别和背景 | 建立主要激活范围 |
| 边界样本 | 接近输入上下限、极暗、极亮或稀疏的输入 | 观察范围是否被截断 |
| 困难样本 | 历史误判、遮挡、噪声和不同来源的数据 | 避免校准只适配理想数据 |
随机数据可以用于确认代码路径能运行,但不能替代真实分布。随机数组往往没有业务数据的相关性、边缘结构和通道关系,校准出来的范围因此缺少解释力。与其盲目增加样本数量,不如先确认样本来源覆盖了哪些真实场景。
把校准规则沉淀成可复查清单
“输入范围异常”这个说法太宽。为了让下一次排查可以复用,我会把检查项收敛成下面这张清单,并和转换产物一起保存:
| 检查面 | 要记录的内容 | 出现异常时先问什么 |
|---|---|---|
| 预处理 | 缩放、归一化、通道顺序、裁剪 | 校准和真实推理是不是同一函数? |
| 张量契约 | signature、输入名、shape、dtype | 是否把位置输入传反或漏了 batch 维? |
| 数据覆盖 | 常态、边界、困难样本及来源版本 | 线上输入的极端区间是否从未出现? |
| 量化目标 | 输入/输出类型、支持算子和 fallback 选择 | 是校准数据问题,还是目标类型与设备要求不符? |
这里的“记录”不等于为文章增加一套验证系统,而是给工程排查留下可读的输入契约。LiteRT 文档还说明,量化张量的实际值由整数值、zero_point 和 scale 共同表示;当代表性数据的 min/max 不可信时,后续的量化解释自然也会失真。
这种校准输入模式的适用力与代价
把代表性数据集当成输入契约,适合模型输入路径稳定、线上数据分布可以抽样、并且需要复查量化异常的团队。它的好处是责任边界清楚:预处理负责数值,签名负责映射,样本负责覆盖,转换配置负责目标类型。
它也有代价。每次修改归一化、输入尺寸或数据来源,都应该重新确认校准样本;多 signature 模型还需要维护不同入口的样本映射。若业务分布变化很快,旧校准数据不能永远当作代表性数据,应该把样本版本和来源纳入模型构建记录。
我的判断是:先修正输入契约,再讨论更复杂的量化策略。只有当预处理、shape、dtype 和样本分布都能解释时,才值得把注意力转向算子支持、设备 delegate 或训练期量化方案。
常见问题
代表性数据集必须使用训练集吗?
不必须。官方说明允许使用训练或验证数据中的小子集;工程上更重要的是它是否代表真实推理输入,而不是它属于哪一个数据集名称。
为什么代表性数据能转换成功,但 int8 结果仍然异常?
转换成功只说明输入满足转换器的结构要求,不代表数值分布与线上推理一致。优先检查归一化、shape、dtype、通道顺序和样本覆盖。
多输入模型一定要使用 signature 吗?
不一定,但命名输入更容易表达语义,也能降低位置顺序翻转的风险。如果使用输入列表,就必须把模型输入顺序作为契约记录并持续复查。
随机数据能不能作为正式校准集?
随机数据适合做路径冒烟或示例,不适合作为真实业务的正式校准依据。它通常不能还原真实数据的相关性、边缘结构和困难样本。
LiteRT int8 量化异常时,我会先回到一句很朴素的话:转换器到底看到了什么输入?把真实预处理、代表性样本、签名映射和分布覆盖当成一个完整契约,通常比盲目调整量化参数更快找到范围异常的来源。
-
409 收藏
-
363 收藏
-
120 收藏
-
225 收藏
-
202 收藏
-
科技周边 · 人工智能 | 1小时前 | 人工智能 · Transformers DataCollatorForSeq2Seq label_pad_token_id loss mask seq2seq176 收藏
-
213 收藏
-
455 收藏
-
228 收藏
-
226 收藏
-
191 收藏
-
343 收藏
-
科技周边 · 人工智能 | 1小时前 | 人工智能 · 深度学习 · Keras RaggedTensor keras.Input ragged=True TensorFlow backend 模型保存 load_model 变长序列250 收藏
-
337 收藏
-
436 收藏
-
科技周边 · 人工智能 | 1小时前 | 人工智能 · 深度学习 · 内存优化 · 内存 PyTorch 按需加载 mmap checkpoint torch.load map_location state_dict475 收藏
-
375 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习