
Accelerate mixed_precision 怎样选择 fp16 或 bf16
来源:17golang原创
时间:2026-10-15 02:22:24 386浏览 收藏
Accelerate 的 mixed_precision 选择 fp16 还是 bf16,我会先看当前设备与算子是否支持,再看模型的数值行为。普通 CUDA 训练中,原生支持 BF16 且模型适配时,可以优先尝试 bf16;只有 FP16 路径合适时,再选择 fp16 并关注梯度缩放。无法确认支持、正在排查数值错误时,先用 no 建立对照。
如果接手一个启动就报 BF16 不支持、或 loss 很快变成 NaN 的训练脚本,我不会立即把字符串换成另一个模式。前者可能是环境不支持,后者也可能来自数据、学习率或模型本身。它们需要分开判断。下面是我的条件性选择方式,不是某次已完成训练的体验记录,也没有实际跑分。
官方地址:https://huggingface.co/docs/accelerate/package_reference/accelerator
我会先把支持问题和数值问题分开
fp16 和 bf16 都是 16 位浮点格式,但分配给指数与有效数字的空间不同。BF16 的动态范围更接近 FP32,FP16 在可表示范围内能提供不同的有效数字精度。对我来说,“范围较宽”是考虑 bf16 的理由,不是声称它在任何任务上都更准确。
FP16 训练常通过梯度缩放减少小梯度下溢的问题;BF16 通常不需要同样的缩放机制。不过,梯度缩放不是对所有 NaN 的修复器,也不能把超出可表示范围的模型运算自动变正确。混合精度决定哪些操作采用较低精度,某些操作仍使用 FP32;它不是全模型 dtype 改写。
| 条件 | 我会考虑的模式 | 还要核对什么 |
|---|---|---|
| 当前设备与模型算子原生支持 BF16 | bf16 | 训练指标、数值变化和实际耗时 |
| FP16 AMP 路径可用,但 BF16 不适合 | fp16 | 缩放相关行为、溢出与更新是否被跳过 |
| 支持情况不明或要定位异常 | no | 同一数据和设置下是否仍然失败 |
这里讨论普通 PyTorch 与 Accelerate 的单卡 NVIDIA CUDA AMP,不覆盖 CPU、MPS、XPU、TPU、ROCm 或 DeepSpeed/FSDP 插件的精度配置。它们有自己的支持条件,不能把 CUDA 查询结果推广过去。
只在确认当前 CUDA 设备后决定模式
我比较在意“当前设备”这几个字。多卡机器上,一张卡的能力不代表所有卡;分布式任务也不应该让各个进程临时选出互不一致的模式。本文单卡例子固定设备 0,其他场景应按实际进程设备和后端文档判断。
PyTorch 的 torch.cuda.is_bf16_supported 提供 including_emulation 参数。默认允许考虑模拟支持,所以一个 True 不足以证明所有运算都能获得原生 BF16 性能。本文使用 including_emulation=False 作为更保守的选择信号,仍不承诺每个模型算子都适配。
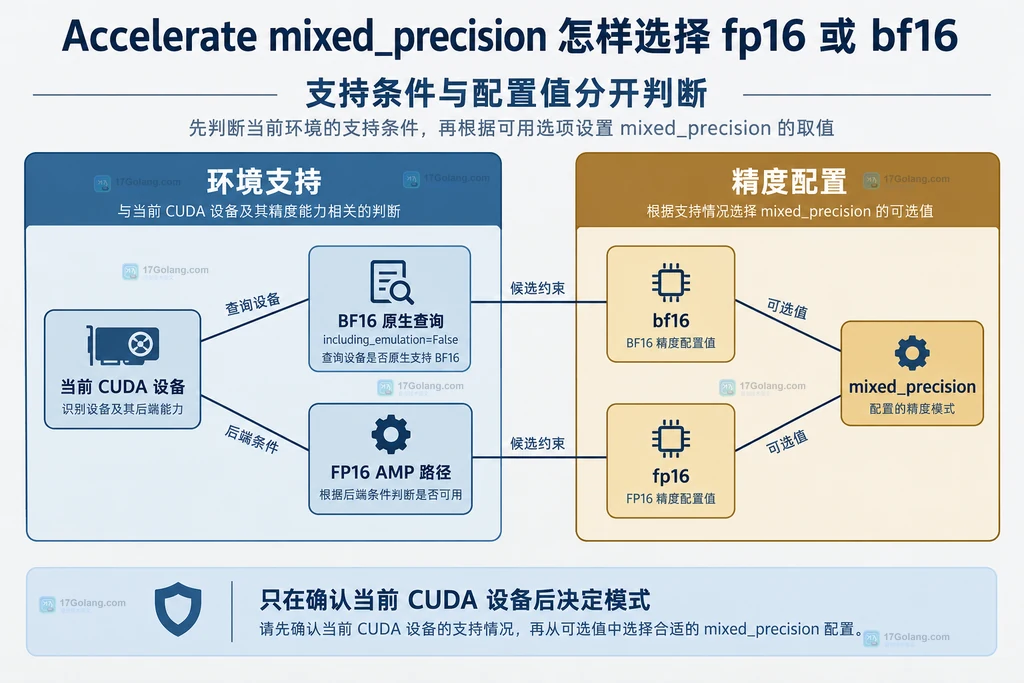
查询参考地址:https://docs.pytorch.org/docs/main/generated/torch.cuda.is_bf16_supported.html。旧 PyTorch 如果不认识 including_emulation 参数,说明接口版本不同;应查看对应版本文档,而不是悄悄去掉参数后把宽松查询当成原生支持保证。
Accelerator 可显式传 mixed_precision,也能从环境、配置或启动参数取得值。我会在一个地方明确决定它,并打印实际 device 与 mixed_precision,避免命令行写 bf16、脚本里却固定 fp16 的混淆。改变模式应重新启动进程,不在同一个已初始化环境中反复创建不同精度的 Accelerator。
把 mixed_precision 接入一个完整训练例子
下面的原创小例子只训练线性分类器,随机样本用于说明参数接入,不用于判断模型质量。安装兼容的 PyTorch 和 Accelerate 后保存为独立 Python 文件;使用普通单进程环境执行,不套用已有分布式插件配置。本文没有执行这些代码。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset
from accelerate import Accelerator

# 每次只选一种模式;对照测试需要重新启动进程
MODE = "bf16"  # 可手动改成 "fp16" 或 "no"
if MODE not in {"no", "fp16", "bf16"}:
    raise ValueError("不支持的混合精度模式")

# 本例限定普通单卡 NVIDIA CUDA,不覆盖其他后端或分布式插件
if MODE != "no":
    if not torch.cuda.is_available() or torch.version.hip is not None:
        raise RuntimeError("本例的半精度模式需要 NVIDIA CUDA 环境")
    torch.cuda.set_device(0)
    if MODE == "bf16" and not torch.cuda.is_bf16_supported(including_emulation=False):
        raise RuntimeError("当前设备未报告原生 BF16 支持,请另选模式")

# 不直接对模型调用 half;由 Accelerate 管理 AMP
accelerator = Accelerator(
    mixed_precision=MODE, cpu=not torch.cuda.is_available()
)
torch.manual_seed(17)
model = nn.Linear(8, 2)
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
features = torch.randn(32, 8)
labels = torch.randint(0, 2, (32,))
loader = DataLoader(TensorDataset(features, labels), batch_size=8)
model, optimizer, loader = accelerator.prepare(model, optimizer, loader)
model.train()
accelerator.print("设备与精度:", accelerator.device, accelerator.mixed_precision)

for features, labels in loader:
    optimizer.zero_grad()
    # 前向和损失使用 AMP 上下文;反向放在上下文之外
    with accelerator.autocast():
        logits = model(features)
        loss = nn.functional.cross_entropy(logits, labels)
    if not torch.isfinite(loss.detach()).item():
        raise RuntimeError("损失出现非有限值,请停止并排查数据与数值范围")
    accelerator.backward(loss)
    optimizer.step()
    accelerator.print(
        "loss:", float(loss.detach().float().item()),
        "更新被跳过:", accelerator.optimizer_step_was_skipped,
    )
如果选择 bf16 而设备不满足保守支持条件,脚本会在初始化训练之前报出明确错误,不自动把模式改成 fp16。自动降级容易掩盖真实设置差异;我更愿意记录原因后明确选择其他模式。选择 fp16 也不是保证所有旧设备和算子一定可用,仍需由实际环境确认。
prepare 处理模型、优化器与数据加载器的协作。autocast 表达前向与损失的混合精度范围,accelerator.backward 负责按当前配置处理反向;普通 FP16 AMP 场景不要再叠加另一套手写 GradScaler,以免把管理责任重复分给两层。
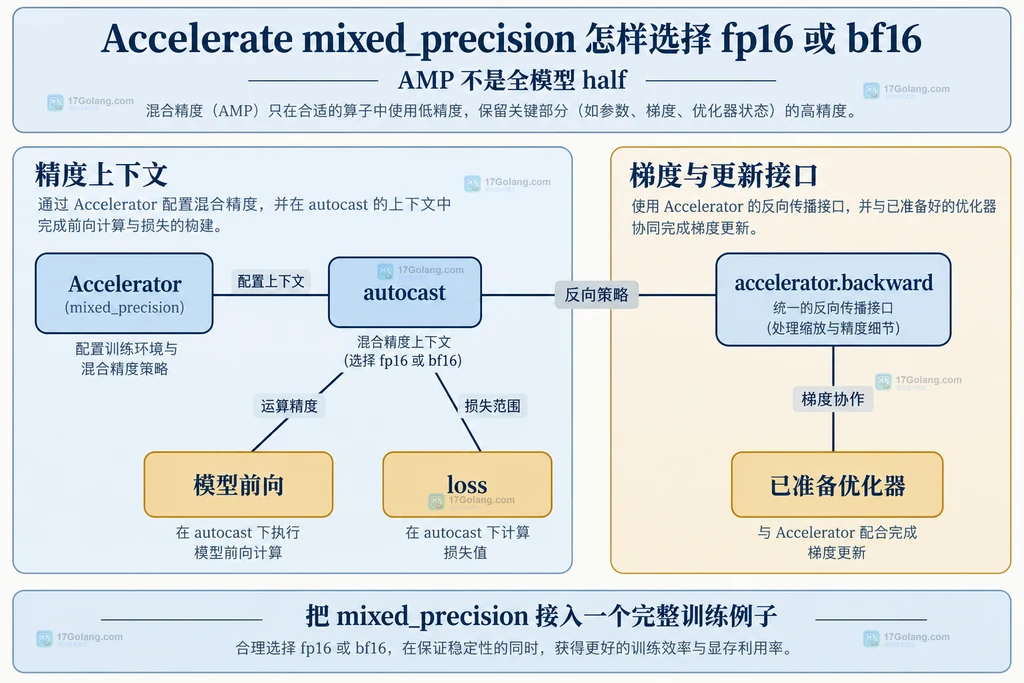
我不建议为了“确保用了半精度”先调用 model.half(),再套这个例子。PyTorch AMP 通常按操作选择 dtype,参数保持 FP32 与部分运算采用低精度可以同时成立。盯着某一个输出张量是 FP32,就断定 mixed_precision 没生效,也容易误判。
能跑起来之后,我还会看哪些信号
参数被接受只能说明初始化走通,不能说明训练稳定、结果正确或速度有收益。我会把设备、软件版本、模式、样本与训练配置一起记录,再看 loss 是否有限、优化器更新有没有被跳过,以及实际任务的验证指标。上面的打印项只是观察入口,不包含实测结果。
FP16 溢出可能导致优化器更新被跳过,Accelerate 提供 optimizer_step_was_skipped 供应用判断。如果实际程序带学习率调度,应理解跳过更新的含义,不能把没有发生的更新当成正常步数。偶发跳过与持续失败也不同,不要只凭一条布尔值宣布模式优劣。
若 no 模式也出现非有限损失,我会先回到数据、模型输出与学习率,而不是继续归因于混合精度。若只有 fp16 异常,设备支持且算子适配时可以对照 bf16,但 BF16 也不是稳定性承诺。所有对照保持数据和主要设置一致,否则差异没有可解释性。
对性能我会保留判断:小模型、数据加载瓶颈或缺少高效低精度内核时,改模式不一定更快。参数、梯度和优化器状态的总显存,也不能简单按 16 位对 32 位推算减半。本文不给固定倍数、显存数字或收敛结果。
bf16 是更省显存的 fp16 吗?
不能这样理解。两者都是 16 位格式,主要取舍是表示范围、精度与硬件算子支持。总显存受许多仍可能保持 FP32 的状态影响,必须在自己的任务里观察。
参数写成 no,是否等于所有计算一定是严格 FP32?
no 表示不启用 Accelerate 的混合精度策略,不负责撤销你自己做过的 dtype 转换,也不等于关闭全部其他数值优化。作为对照时,我会保持模型与数据的原始 dtype,并记录其他相关设置。
训练过程中可以直接切换到另一种模式吗?
我会保存需要的状态后在独立进程里重启,而不是原地改一个字段期待现有包装和缩放状态自动重建。恢复训练涉及状态兼容,不能把字符串替换当作完整迁移方案。
我的取舍是:先确认支持,再用与模型数值范围匹配的模式,最后用任务结果决定是否保留。bf16 是合适环境里的候选,fp16 是需要留意缩放的候选,no 是清楚定位问题的重要对照;三者都不是不看条件就能套用的答案。
官方接入说明:https://huggingface.co/docs/accelerate/basic_tutorials/migration。PyTorch AMP 示例:https://docs.pytorch.org/docs/stable/notes/amp_examples.html。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
278 收藏
-
131 收藏
-
491 收藏
-
187 收藏
-
科技周边 · 人工智能 | 1小时前 | LoRa PEFT adapter save_pretrained adapter_model.safetensors selected_adapters save_embedding_layers483 收藏
-
485 收藏
-
356 收藏
-
441 收藏
-
266 收藏
-
370 收藏
-
485 收藏
-
118 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习