
人工智能技术文章
-
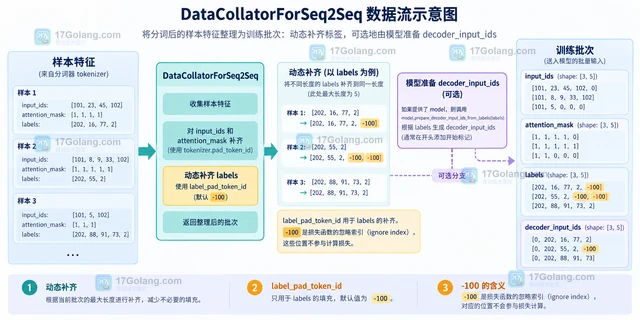 围绕 Hugging Face Datasets 的 map(batched=True) 讲清返回列长度契约、remove_columns 的作用和最小诊断方法,帮助定位预处理函数中的扩行与错配问题。213 收藏
-
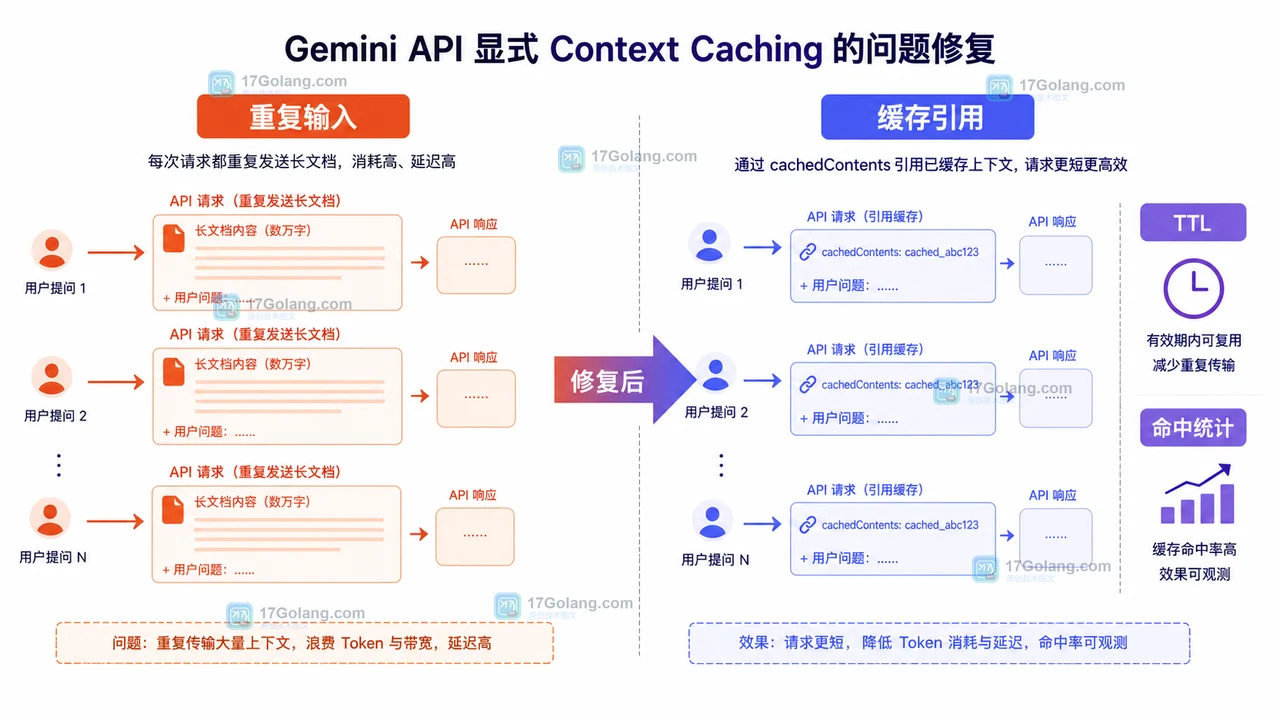 重复把长文档或系统提示词发送给 Gemini API 时,可以用显式 Context Caching 保存公共上下文,再通过 cachedContents、TTL 和 usage.total_cached_tokens 验证缓存是否真的生效。209 收藏
-
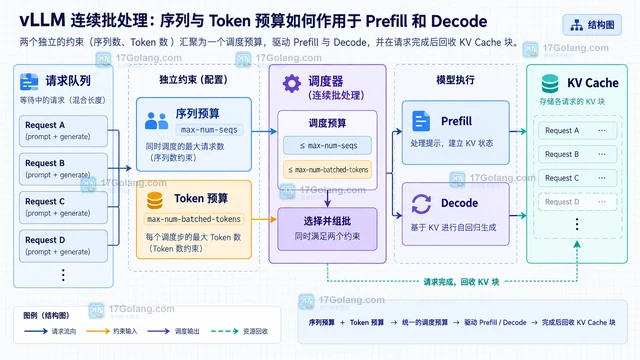 vLLM 连续批处理并不是并发越高越快。本文从模型权重、KV Cache、序列数和批次 token 预算出发,给出显存与吞吐的调参顺序、压测方法和生产降级路径。209 收藏
-
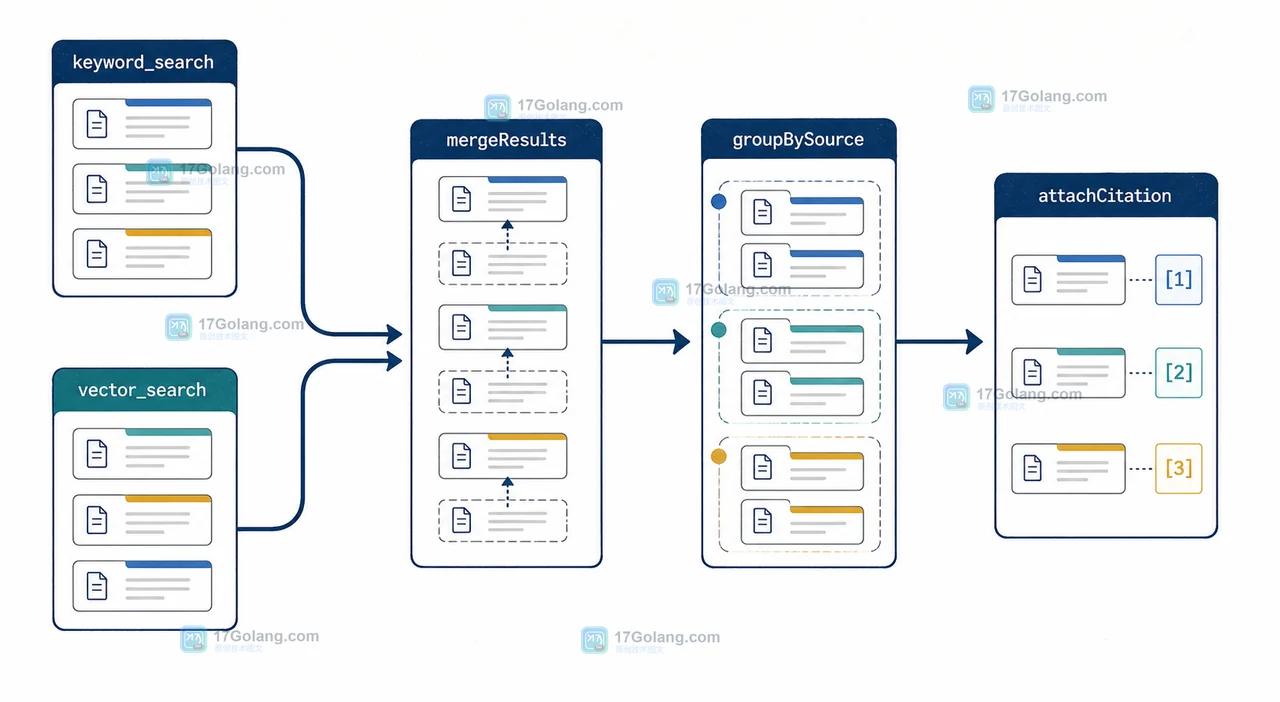 关键词检索和向量检索各自找到了内容,合并后却出现重复段落、来源顺序混乱或引用丢失,问题往往出在结果融合阶段。本文用可运行的 Python 示例拆开去重、分组、来源优先级与引用回填,让多路 RAG 的合并结果可解释、可回归。208 收藏
-
科技周边 · 人工智能 | 3星期前 | 错误处理 · mcp · 工具调用 · AI工程 · MCP工具错误 isError structuredContent CallToolResult JSON-RPC错误
 MCP 工具遇到业务失败时,应在正常工具结果中设置 isError,并把可行动信息放进 content;只有协议层故障才返回 JSON-RPC error。本文用 TypeScript 示例说明结构化错误的设计边界。208 收藏
-
 RAG 检索结果很多却答不准时,先区分召回缺失、候选过杂和上下文丢失,再从语义切块、混合召回、元数据过滤、重排和固定评测集逐层改进。208 收藏
-
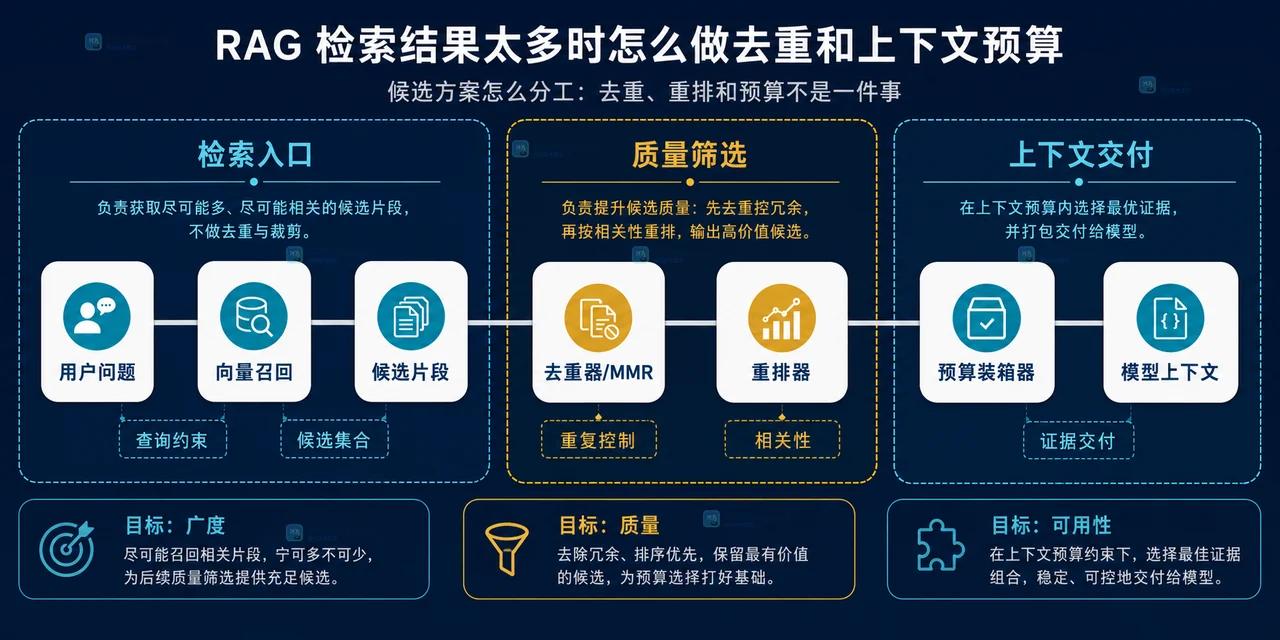 RAG 检索结果过多时,不要只调小 top_k。本文拆分候选去重、重排、上下文压缩与预算装箱,给出可落地的选择规则、Python 示例和四项排查指标。207 收藏
-
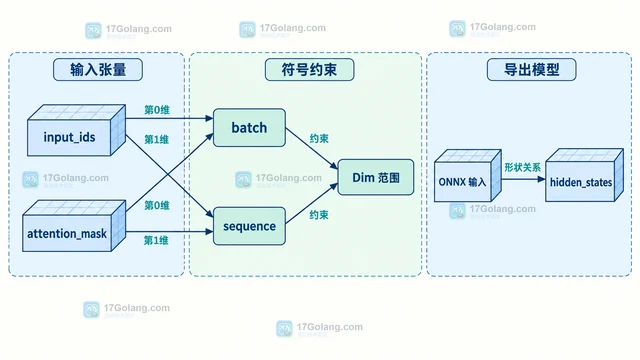 介绍 PyTorch ONNX 导出时如何用 dynamic_shapes 和 torch.export.Dim 声明动态批次、动态序列长度,并比较现代 dynamo 导出器与 legacy dynamic_axes 的选择边界。206 收藏
-
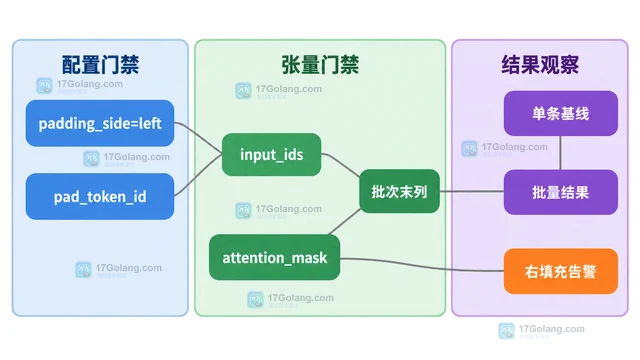 说明 decoder-only 模型批量生成时 padding_side 为什么应设为 left,并结合 input_ids、attention_mask 和生成起点排查对齐问题。206 收藏
-
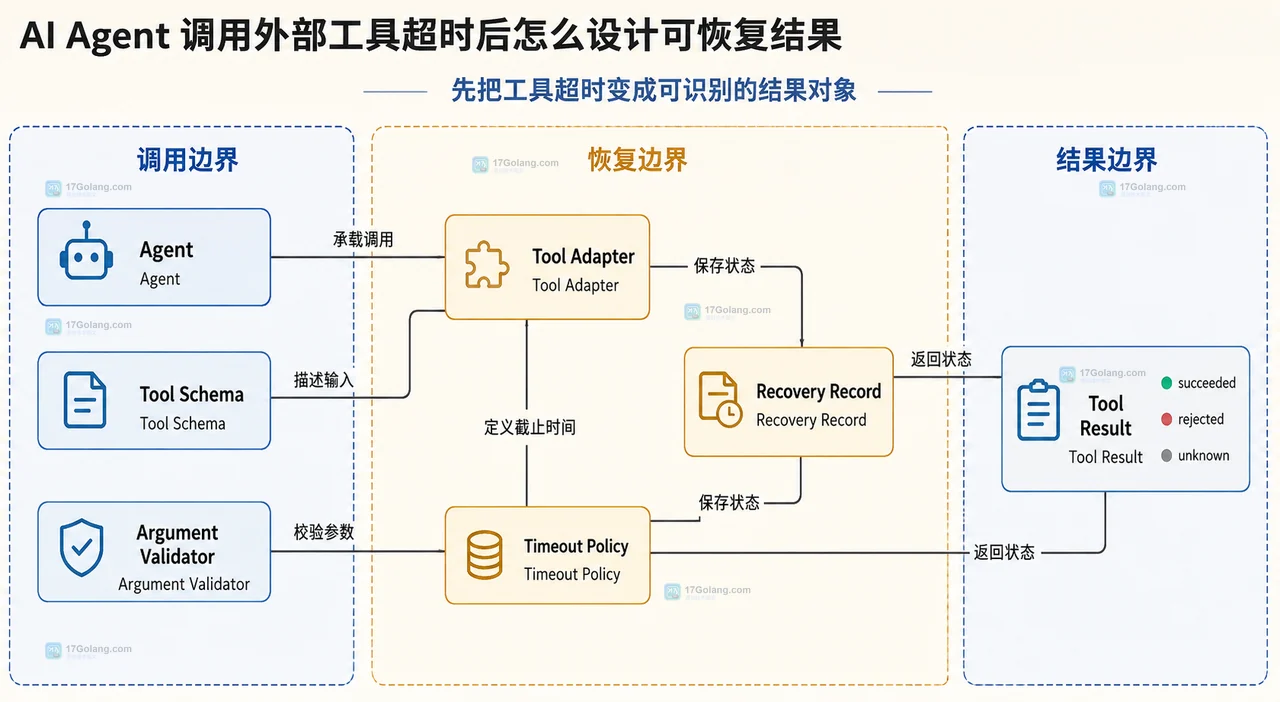 AI Agent 调用外部工具超时后,不要把异常当空结果或无条件重试。通过 schema、参数校验、幂等键、未知状态和恢复队列,设计可判断、可追踪、可继续处理的结果。203 收藏
-
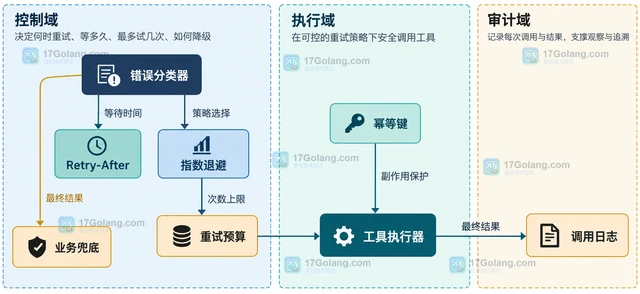 AI 工具调用不应把所有失败都重试。本文从参数校验、限流、超时、服务过载和业务拒绝五类场景出发,设计错误分类、指数退避、重试预算、幂等键与最终兜底。203 收藏
-
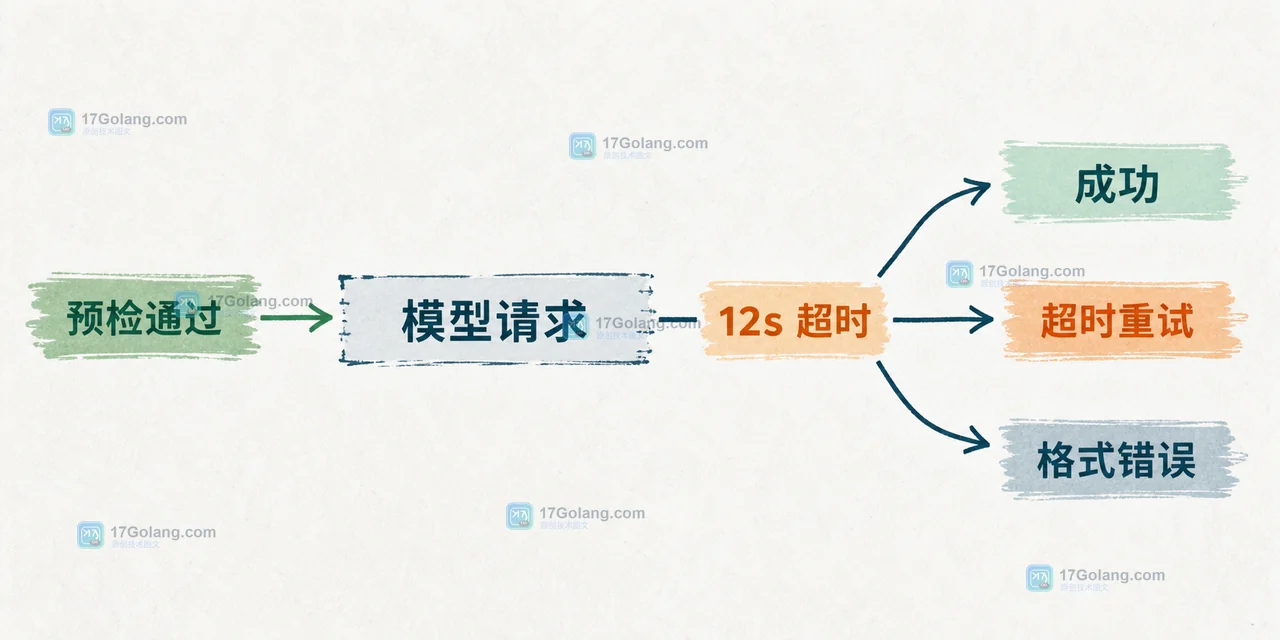 Go 服务接入多模态接口时,图片预检应放在上传入口:先检查 MIME、文件头和字节上限,再决定是否送给模型;遇到格式不支持或服务超时则返回可解释的降级结果。202 收藏
-
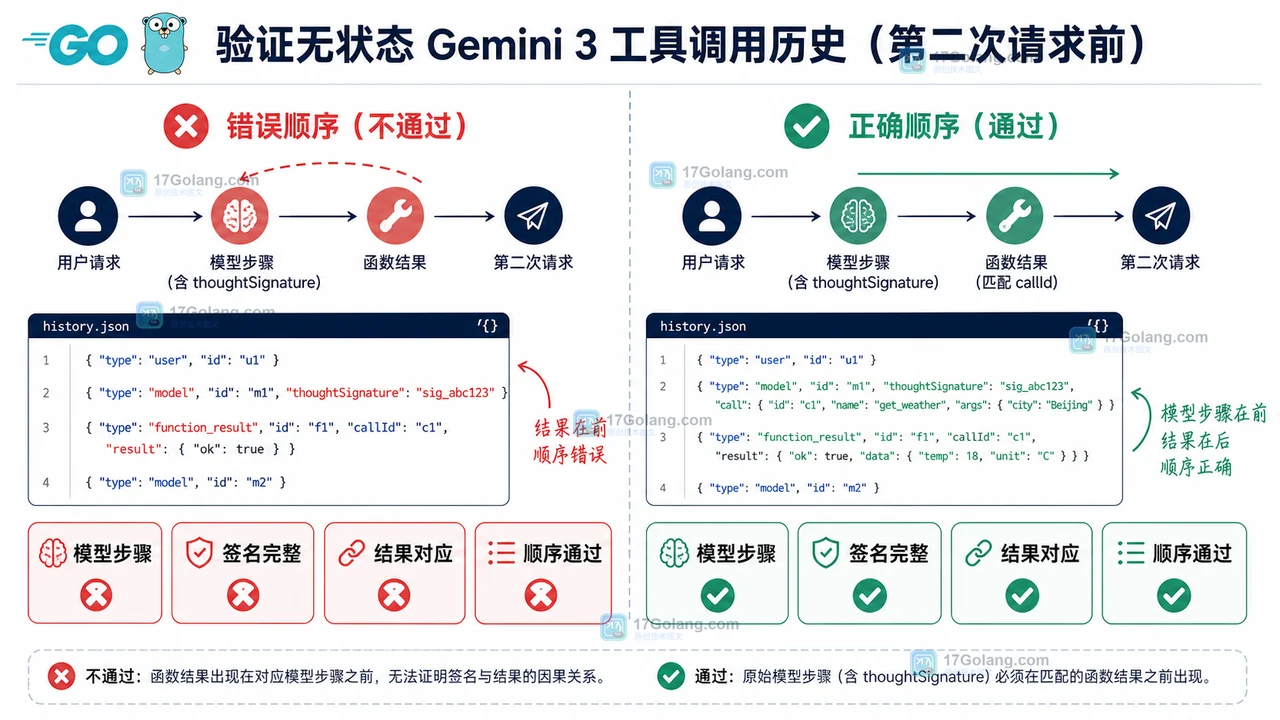 Gemini 3 的函数调用不是拿到 functionCall 就结束:多轮请求必须保留模型返回的 thoughtSignature,并按原顺序回传模型步骤与工具结果。本文用 Go 拆解一次天气工具调用的状态流、签名保存和失败核对。202 收藏
-
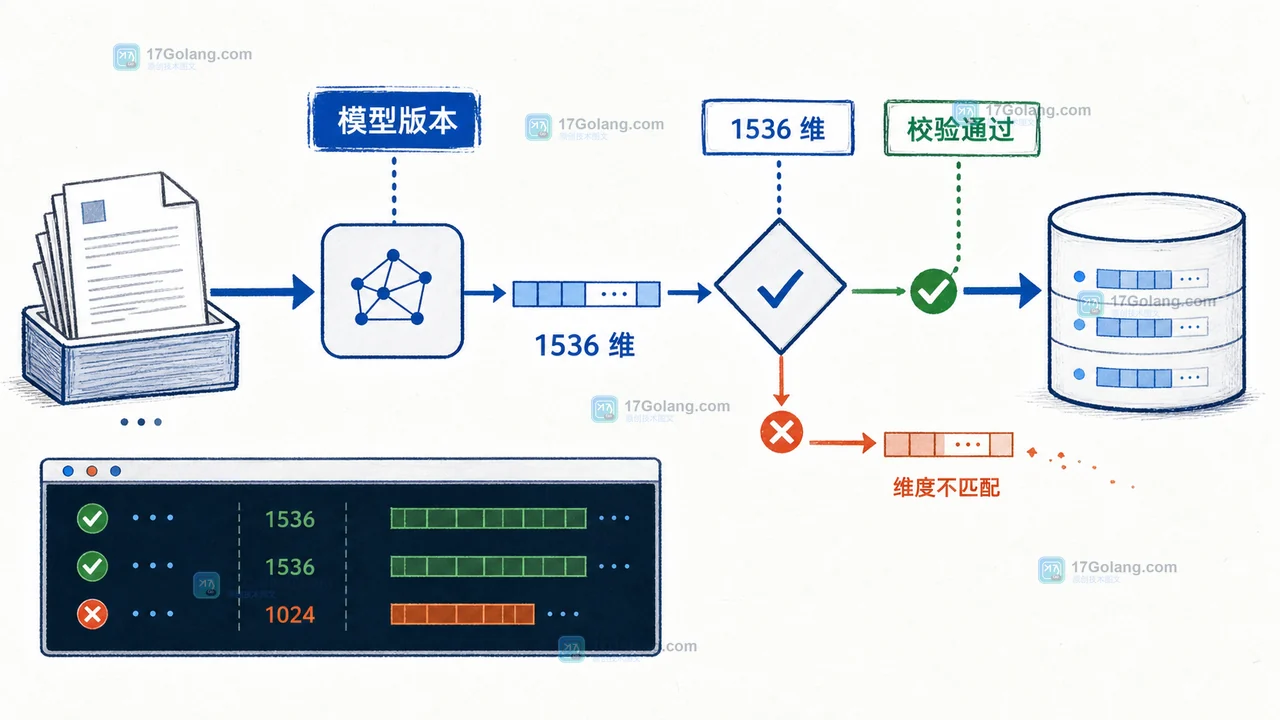 Embedding 模型一换,向量维度可能跟着变化,批量写入时轻则报错,重则让新旧数据混在同一索引里。本文用维度契约、批量预检、双索引切换和回滚清单,把模型升级变成可验收的入库流程。202 收藏
-
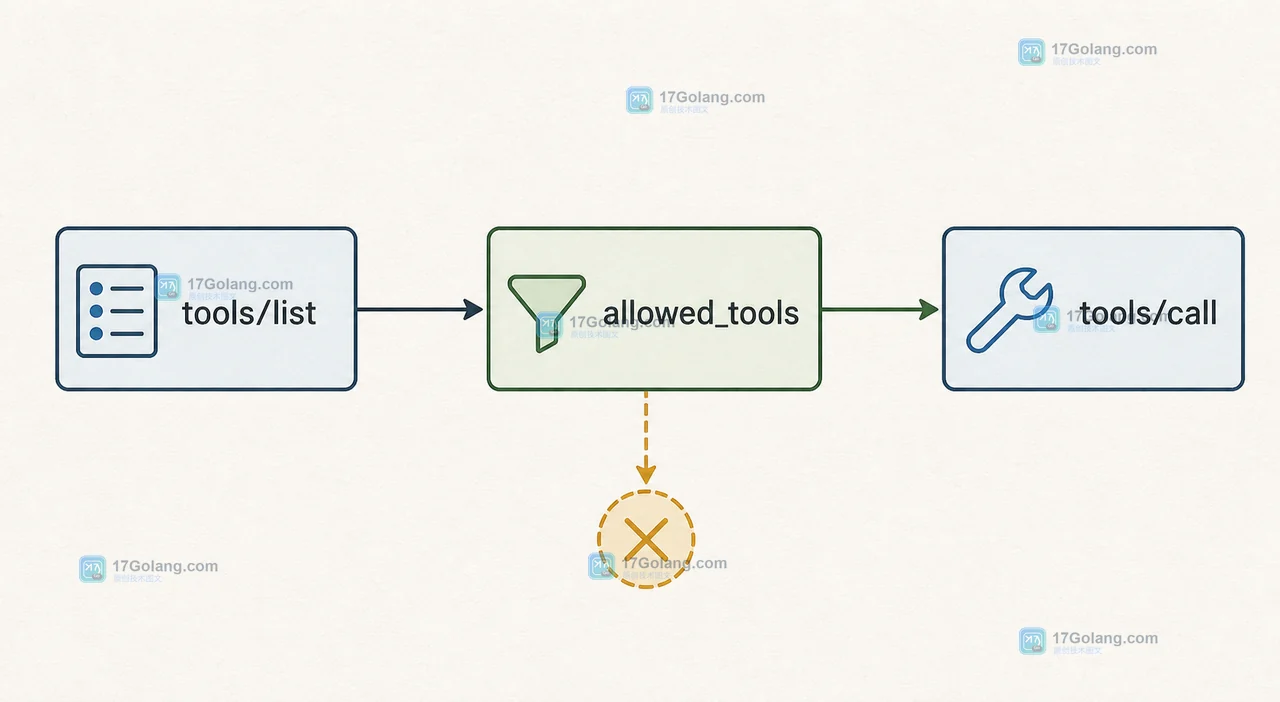 接入远程 MCP 服务器时,不要把工具发现当成授权。本文从工具 allowlist、来源校验、OAuth 受众绑定和审计记录四个边界,整理一套可复核的权限收口方法。202 收藏