
AI 应用怎样记录 token 用量和请求追踪信息
来源:17golang原创
时间:2026-11-02 10:09:16 323浏览 收藏
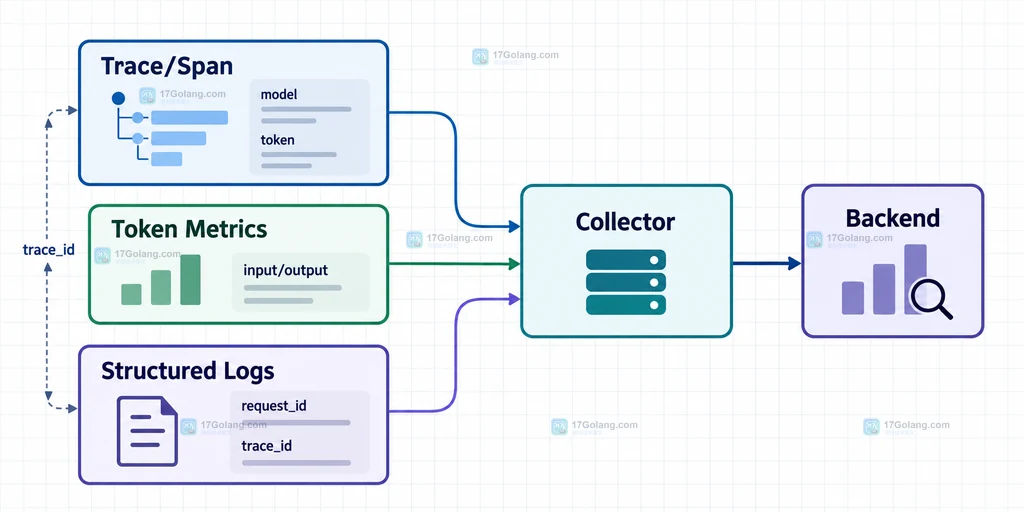
AI 应用要同时记录 token 用量和请求追踪信息,最小可用做法是把一次模型调用建成当前业务请求下的子 span:请求结束时写入模型、提供方、耗时、输入 token、输出 token 和错误状态,再让日志携带同一个 trace_id。这样可以从“哪一次用户请求变慢了”定位到“哪一次模型调用消耗异常”,而不是只在一堆文本日志里猜。
推荐的链路是:业务请求 span → 模型调用 span → token usage 属性与时延指标 → Collector 或观测后端。完整 prompt、response 和用户隐私默认不进入高频 telemetry。
官方参考地址:https://opentelemetry.io/docs/
先划定一次请求的观测边界
先把边界画清楚,再决定记录哪些字段。父 span 表示用户请求或任务,子 span 表示一次实际的模型调用;如果发生重试,每次物理调用单独建 span,并用属性标记重试序号。低基数字段适合放在 span 上,例如 service.name、gen_ai.operation.name、gen_ai.request.model 和提供方标识。会快速膨胀的完整提示词、用户输入和模型输出则应采用采样、哈希或受控脱敏。
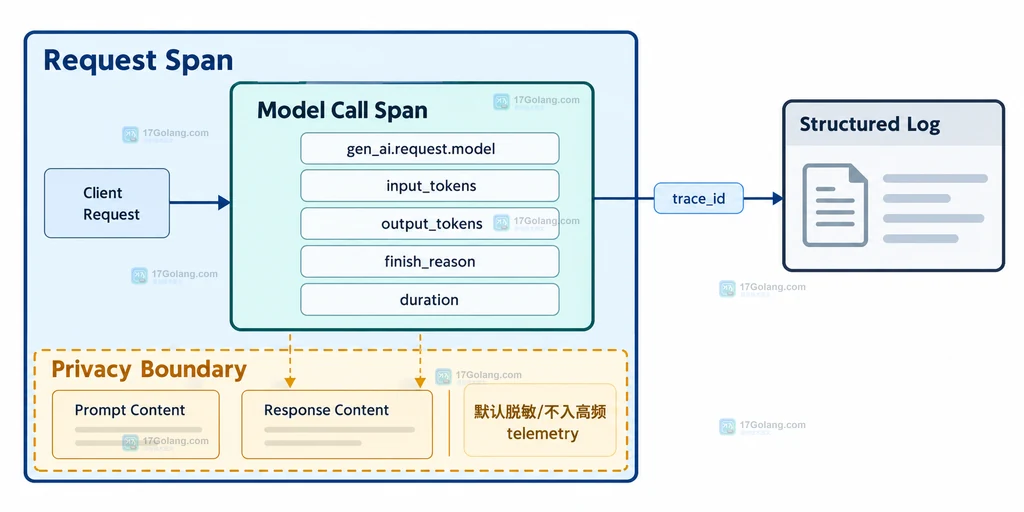
OpenTelemetry 的语义约定用于统一属性命名,便于不同语言和后端按同一维度查询。实际接入时不要把模型名拼进 span 名称,否则模型切换会制造大量高基数时间序列;把它作为属性更稳妥。
token 用量不要只写在日志里
日志适合回答“这次请求发生了什么”,但 token 统计还需要可聚合的指标。模型响应中的 usage 字段由供应商决定,应用层应写一个适配函数,统一映射为输入和输出 token;缺失 usage 时明确记录“未提供”,不要把字符数冒充 token 数。
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("ai-app")

def call_model(client, prompt, model):
    # 子 span 对应一次真实模型调用,父请求上下文会自动继承
    with tracer.start_as_current_span("chat") as span:
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.request.model", model)
        try:
            response = client.generate(model=model, prompt=prompt)
            # 供应商字段先经适配函数,再写入统一语义字段
            usage = extract_usage(response)
            if usage.input_tokens is not None:
                span.set_attribute("gen_ai.usage.input_tokens", usage.input_tokens)
            if usage.output_tokens is not None:
                span.set_attribute("gen_ai.usage.output_tokens", usage.output_tokens)
            span.set_attribute("gen_ai.response.finish_reasons", usage.finish_reason)
            return response
        except Exception as exc:
            # 错误与 span 绑定,日志可通过 trace_id 回到这次调用
            span.record_exception(exc)
            span.set_status(Status(StatusCode.ERROR))
            raise
图中字段名称应以当前采用的 GenAI 语义约定和 SDK 版本为准。单次调用的 token 适合放在 span 属性或事件中;跨请求的总量、分模型总量和时延分布则用指标保存,例如按 gen_ai.token.type 区分 input/output 的用量。指标负责趋势,span 负责个案,二者不要互相替代。
三种记录方案怎样按约束选
只用应用日志最容易开始,适合单体服务和低流量排查,但跨服务关联、聚合和供应商切换都要自行维护。OpenTelemetry SDK 加 Collector 的投入稍高,却能把 trace、metric、log 送到不同后端,适合多服务、需要迁移模型或希望保留数据出口选择权的团队。厂商 SDK 通常最快接入,也可能直接提供 token 看板;代价是字段、采样和导出路径更容易绑定某一家平台。
| 方案 | 适合场景 | 主要代价 |
|---|---|---|
| 结构化日志 | 单体、低并发、先做审计 | 聚合和跨服务 trace 需要自建 |
| OpenTelemetry + Collector | 多服务、模型会切换、要统一观测 | SDK 初始化、Collector 运维和数据治理 |
| 厂商 SDK | 快速试用单一平台的完整看板 | 供应商耦合,迁移时要重做字段适配 |
如果目标是“先知道每次调用用了多少 token”,日志加统一 usage 适配已经够用;如果还要从用户请求穿透到检索、工具调用和模型重试,优先采用 OpenTelemetry,并把厂商 SDK 当作补充而不是唯一数据源。
上线前补齐脱敏、重试和对账边界
第一,给 prompt、response、conversation id 设置脱敏和保留期限,默认只记录长度、哈希或业务标签。第二,把重试次数、流式响应是否完成、finish reason 和错误类型写入 span,否则 token 总量会被误判。第三,不要直接用应用 token 统计替代账单:缓存命中、批处理、舍入、失败请求和不同供应商的计费口径都可能造成差异。最终应保留一份按供应商原始字段映射的对账记录,并让业务 trace 只保存定位所需的最小信息。
常见追问:为什么应用统计的 token 和账单不一致?
通常是统计口径不同:应用记录了单次响应 usage,账单却可能按重试、缓存 token、批处理或计费周期汇总。排查时按 request_id 和 provider request id 对齐原始响应,再比较输入、输出、缓存和失败请求四类数量。
常见追问:要不要把完整 prompt 放进 trace?
除非是受控调试环境且已经脱敏,否则不建议。完整内容会放大隐私、成本和泄露风险;用 trace_id、提示词版本、长度、哈希和业务标签通常就能完成生产排查。
官方语义约定与 GenAI 观测示例可继续参考:https://opentelemetry.io/docs/concepts/semantic-conventions/、https://opentelemetry.io/blog/2026/genai-observability/。
-
155 收藏
-
296 收藏
-
380 收藏
-
188 收藏
-
119 收藏
-
科技周边 · 人工智能 | 1小时前 | 协议 · 客户端 · 人工智能 · mcp · 工具调用 · resources JSON-RPC MCP MCP客户端 tools prompts 能力协商142 收藏
-
250 收藏
-
256 收藏
-
371 收藏
-
475 收藏
-
科技周边 · 人工智能 | 1小时前 | 内存优化 · PyTorch DataLoader IterableDataset num_workers prefetch_factor pin_memory persistent_workers319 收藏
-
356 收藏
-
336 收藏
-
317 收藏
-
370 收藏
-
科技周边 · 人工智能 | 1小时前 | 异步任务 · 人工智能 · openai · 批处理文件 OpenAI Batch API output_file_id error_file_id output_expires_after460 收藏
-
248 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习