
人工智能技术文章
-
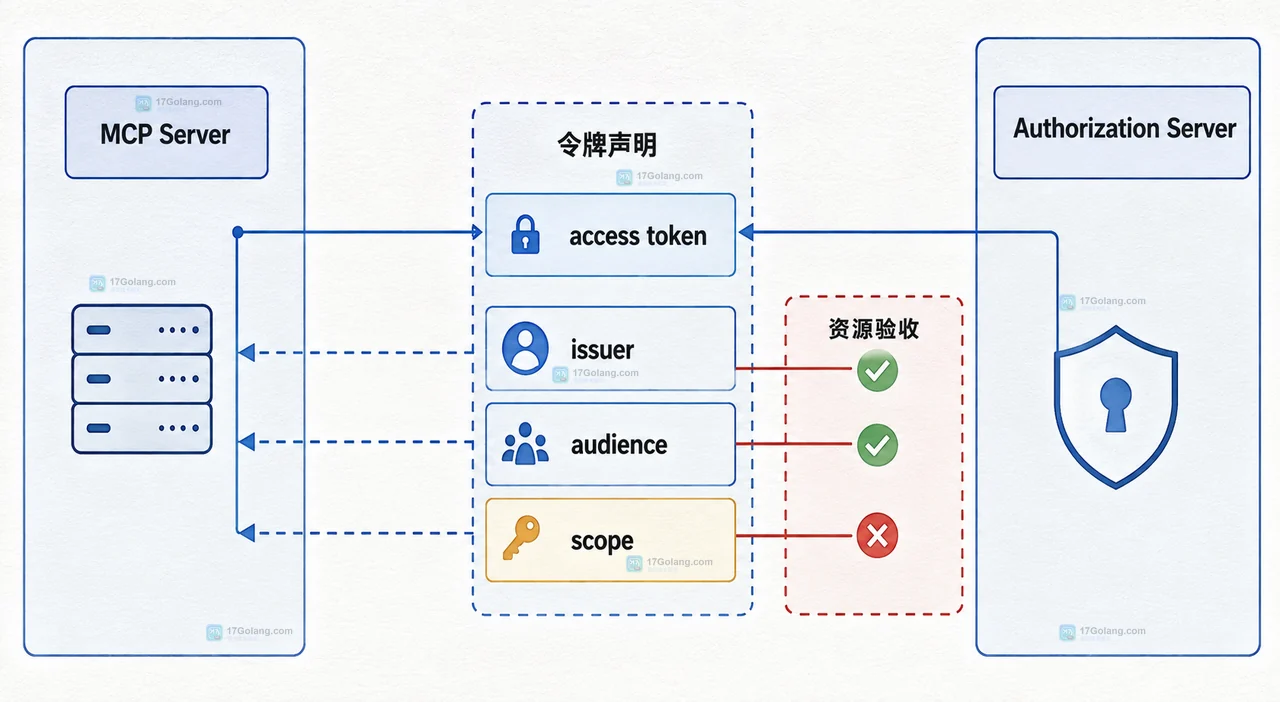 远程 HTTP MCP 的 OAuth 授权不能只把 Bearer token 透传过去。客户端要以 MCP 服务器的 canonical URI 作为 resource,同时放入授权请求和令牌请求;服务端还要校验 token 是否确实签发给自己。本文用一个最小实现拆开这条受众绑定链路,并说明 401、403 与跨服务器误用的边界。123 收藏
-
 RAG 系统把 Markdown 表格按换行或固定字符数切开后,检索结果常常只剩半行字段,模型看似答对却无法说明数据关系。本文用 Markdown AST 识别表格边界、保留表头与行上下文,再用可验收的切片结果接入向量索引。121 收藏
-
 在 Transformers generate 中自定义 StoppingCriteria,用 tokenizer 生成的 token 序列匹配
等标记,并处理批量生成、提示词误匹配和兜底长度限制。 120 收藏 -
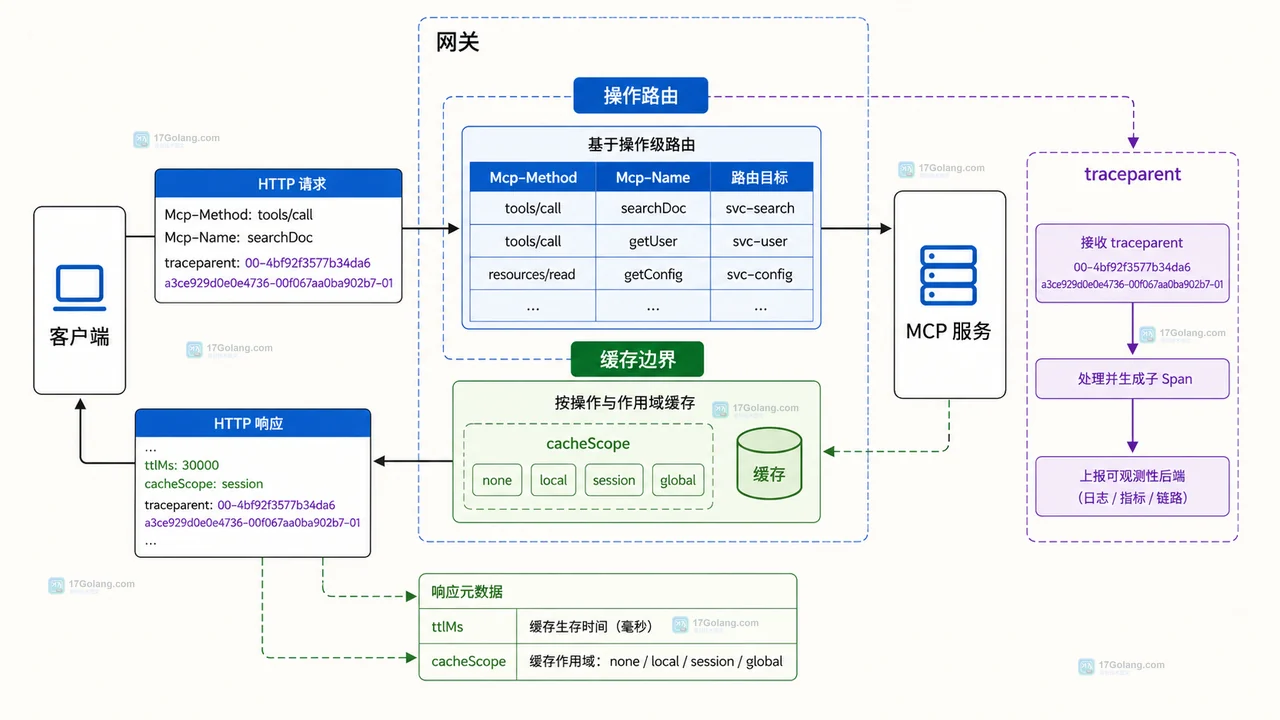 MCP 2026-07-28 将协议层改为无状态,但业务仍可能有状态。本文用显式句柄、请求级路由、缓存范围和 Trace Context 拆解迁移边界。119 收藏
-
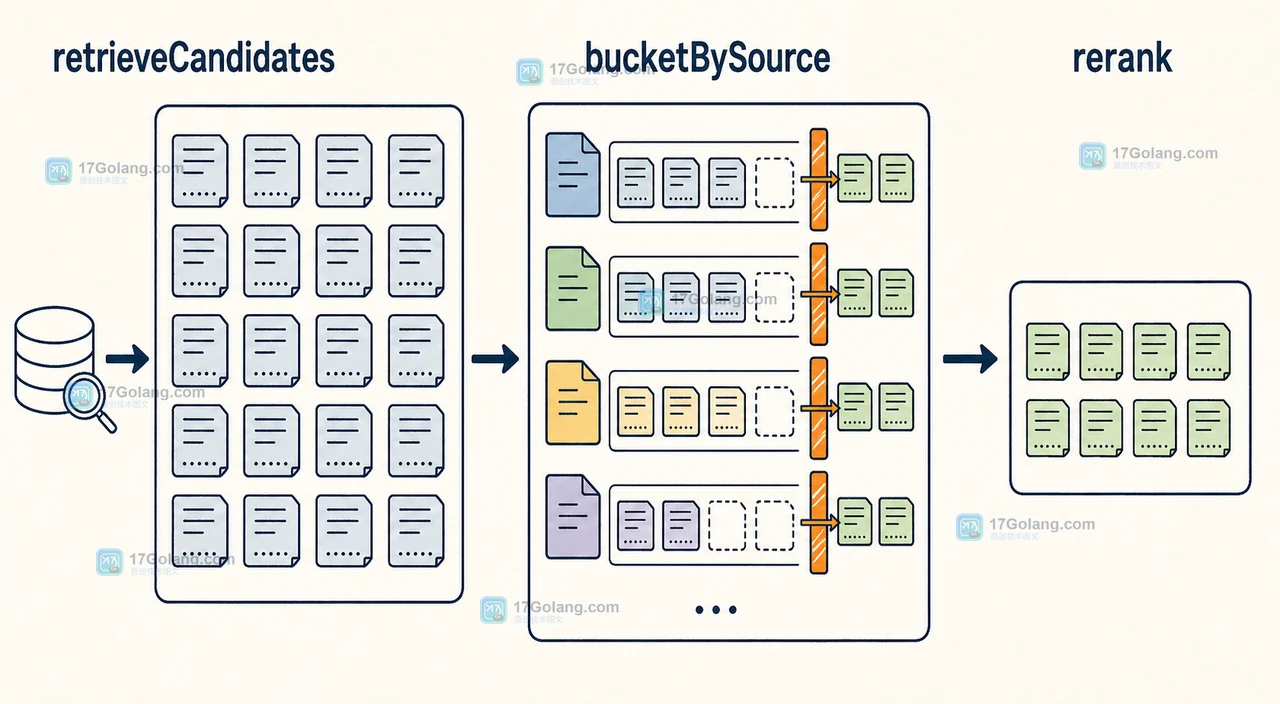 长文切片容易在 RAG 召回中占满候选集。本文用 Go 演示按来源分桶、限制每桶配额,再把候选交给 rerank,最后按 token 预算组装上下文,并给出可复查的召回指标。118 收藏
-
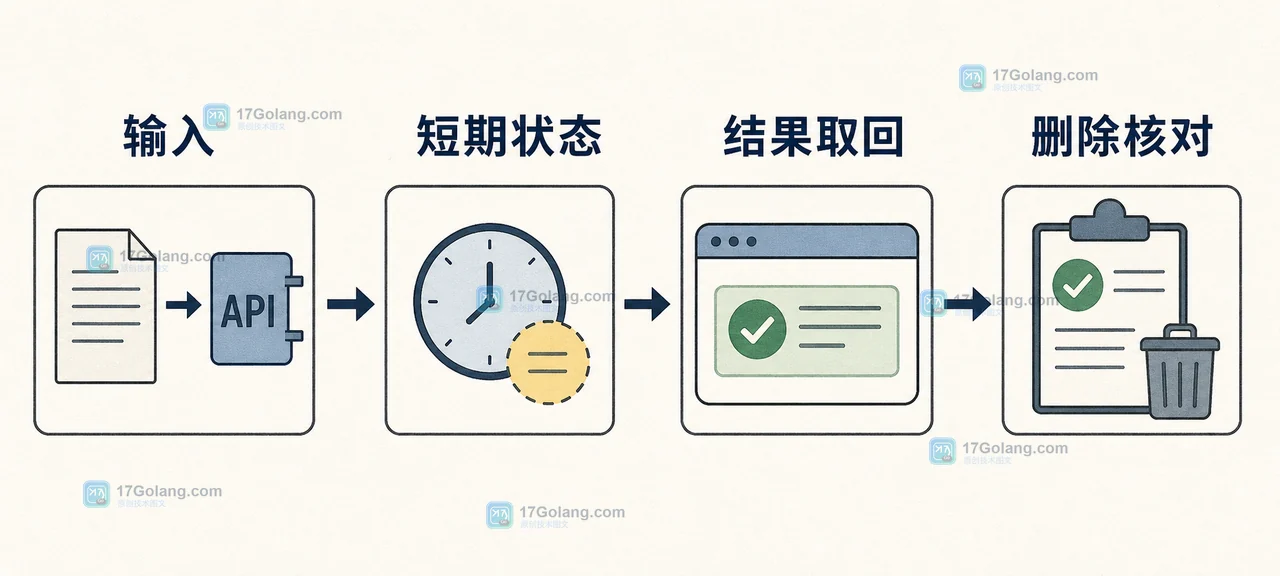 AI API 上线评审不能只看请求是否成功,还要画清输入、平台短期状态、回调结果和删除动作。本文用一个后台响应场景拆解客户数据与短期保留的边界,给出可落地的合规核对清单。115 收藏
-
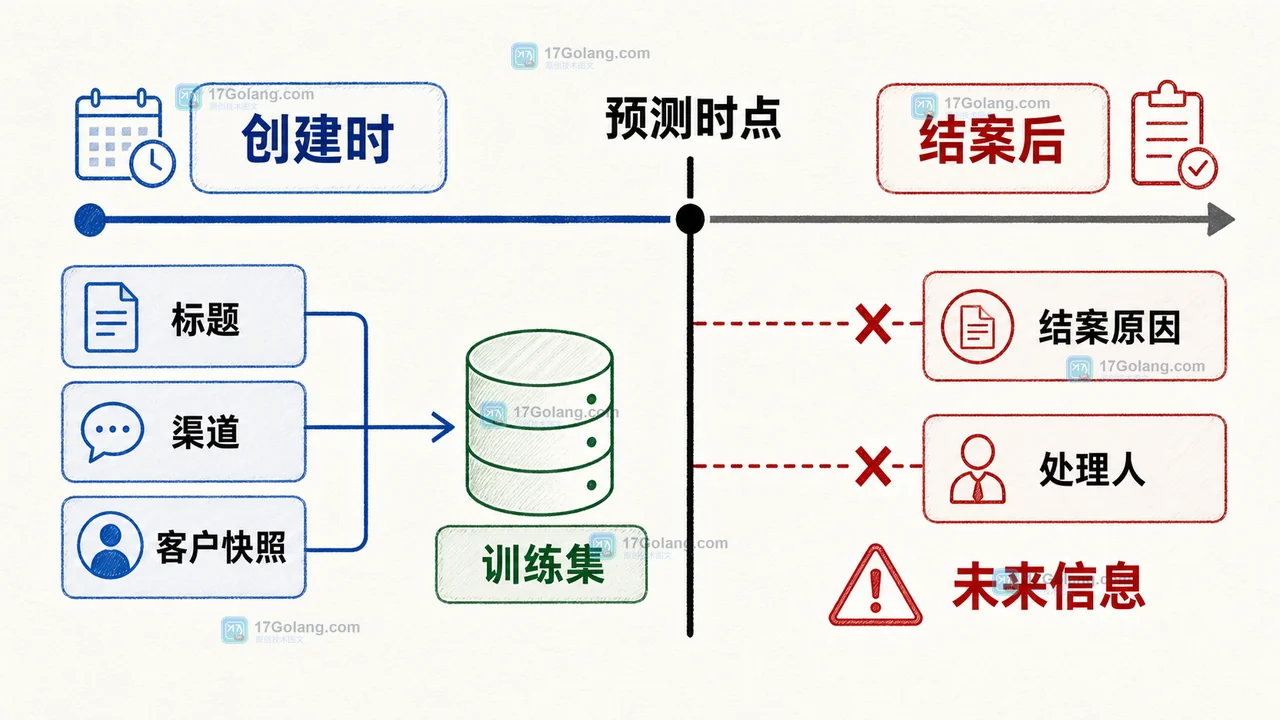 评测分数异常好,未必代表模型真的可靠。训练集、验证集和测试集之间的重复样本、未来字段和错误的预处理顺序,都会造成数据泄漏。本文以带时间的客服工单分类为例,给出切分、去重、特征时间点和最终验收的检查方法。115 收藏
-
 LLM评测不要把事实错误和表达偏差混成一个总分。本文给出分层标签、证据字段、分项统计和复核一致性的可复用设计。115 收藏
-
 语音转写与说话人分离遇到重叠发言时,不要按片段顺序抢词或直接删掉重叠区;应保留普通 diarization,再用词级时间交集决定归属,无法判断的结果进入 ambiguous 复核。115 收藏
-
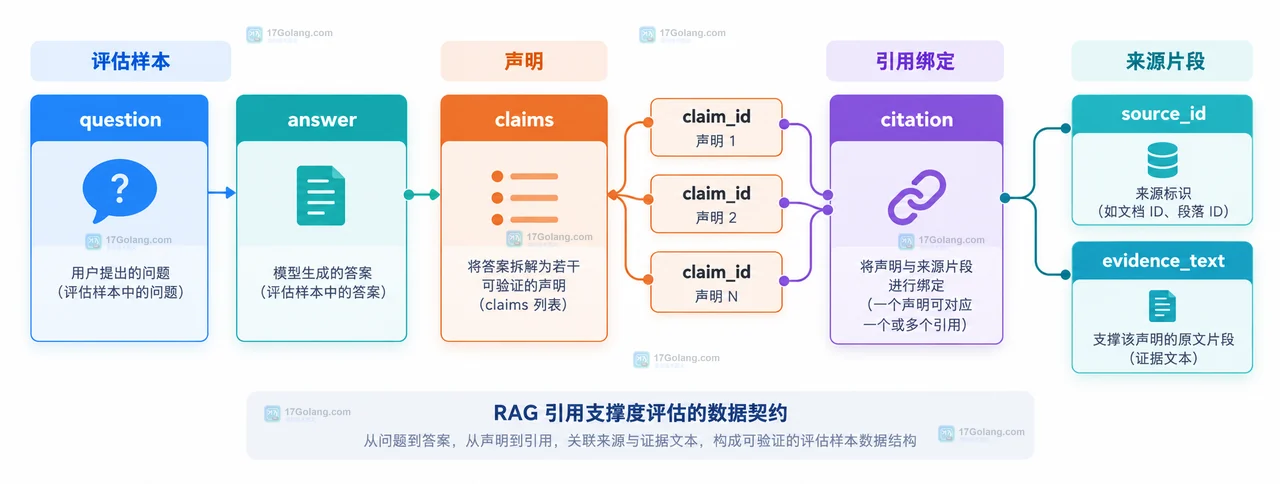 用 Hugging Face 风格的评估数据组织方式,拆解 RAG 引用支撑度的字段契约、覆盖检查、语义判定和分层排障方法。115 收藏
-
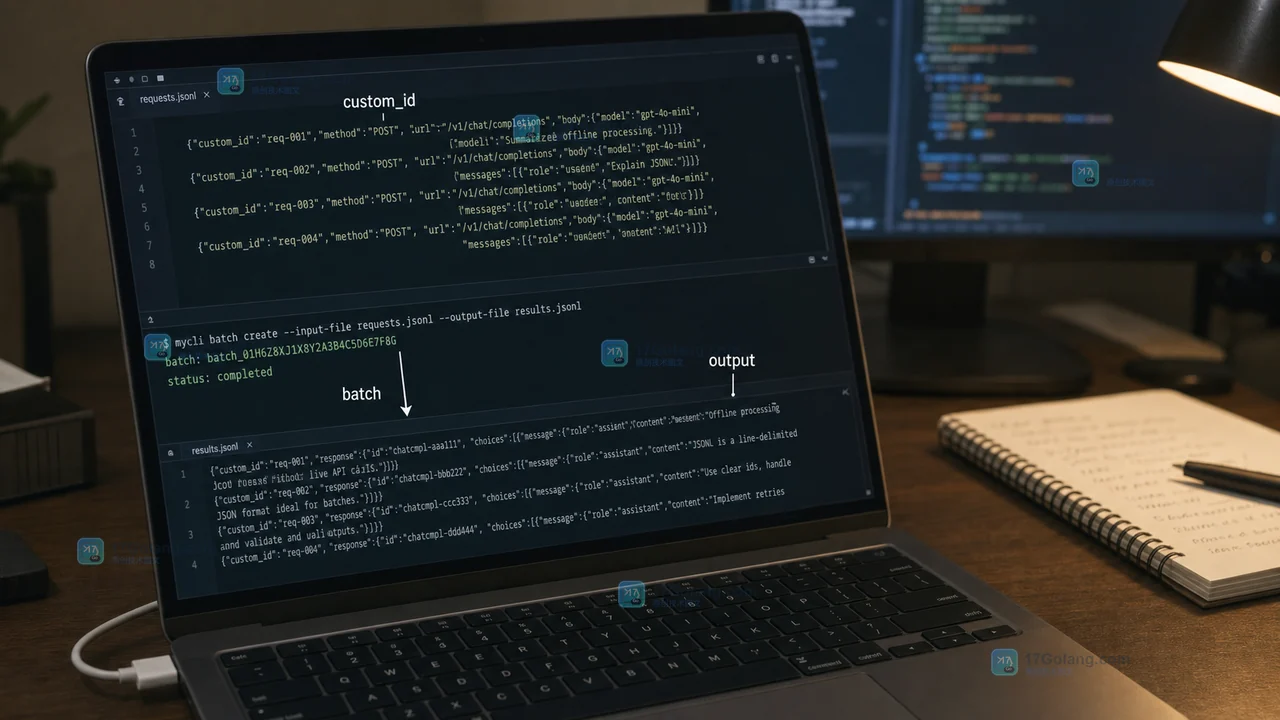 夜间给历史工单打标签、批量生成摘要这类不需要即时返回的工作,不该和在线请求抢同一条队列。本文用一份最小 JSONL 任务说明如何提交异步批次、查看状态、按 custom_id 对齐结果与业务记录,并处理输出文件和错误文件,避免把“批量完成”误当成“每一条都成功”。113 收藏
-
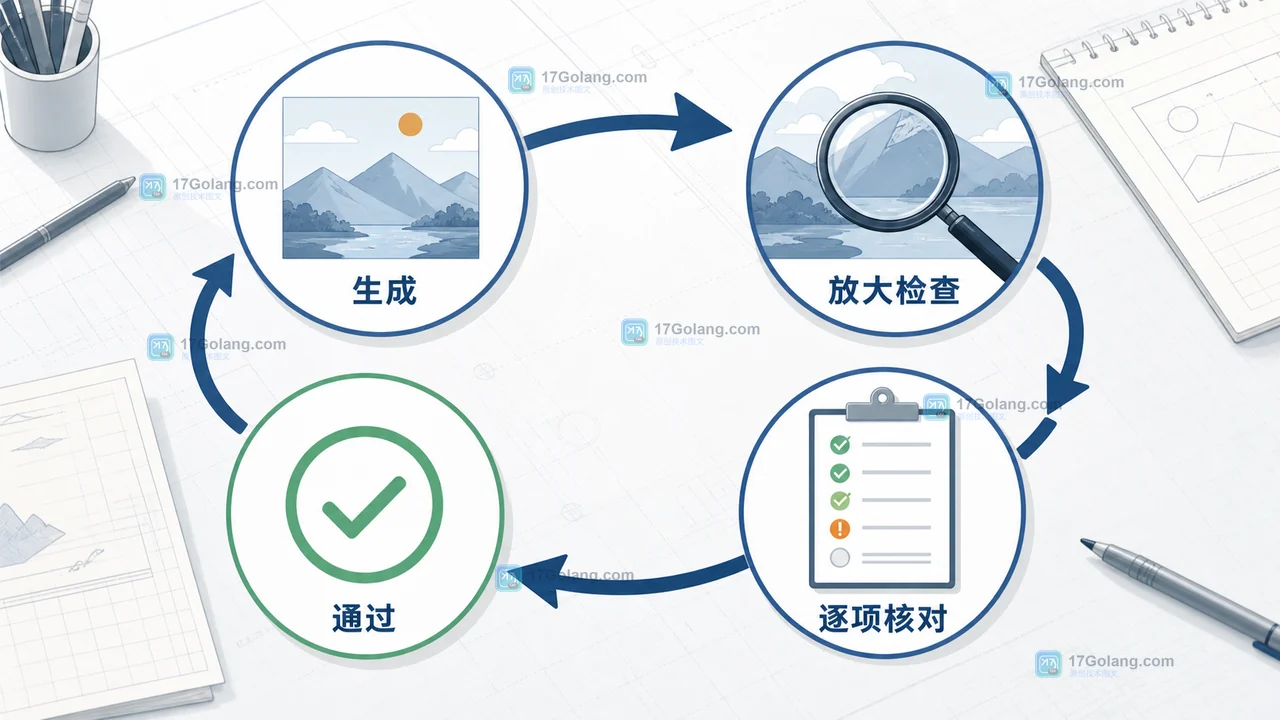 AI 图片里出现多余文字,通常不是把否定词堆得更多就能解决。本文从画面目的、文字约束、分步修改和交付验收四个环节,给出一套可复用的排查方法。113 收藏
-
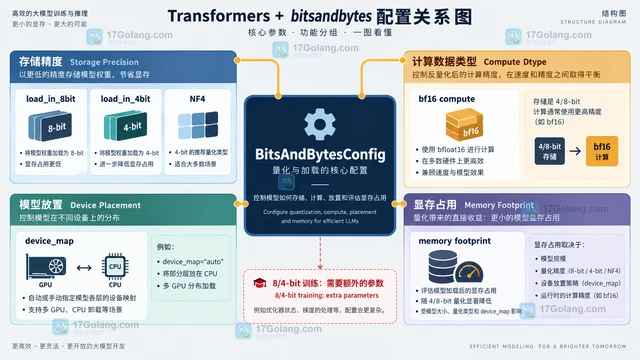 Transformers 量化配置选择的关键不只是显存大小,还要看推理、QLoRA 微调、精度容忍度和硬件后端。本文用 BitsAndBytesConfig 对比 int8 与 int4 的适用边界,并给出检查清单。113 收藏
-
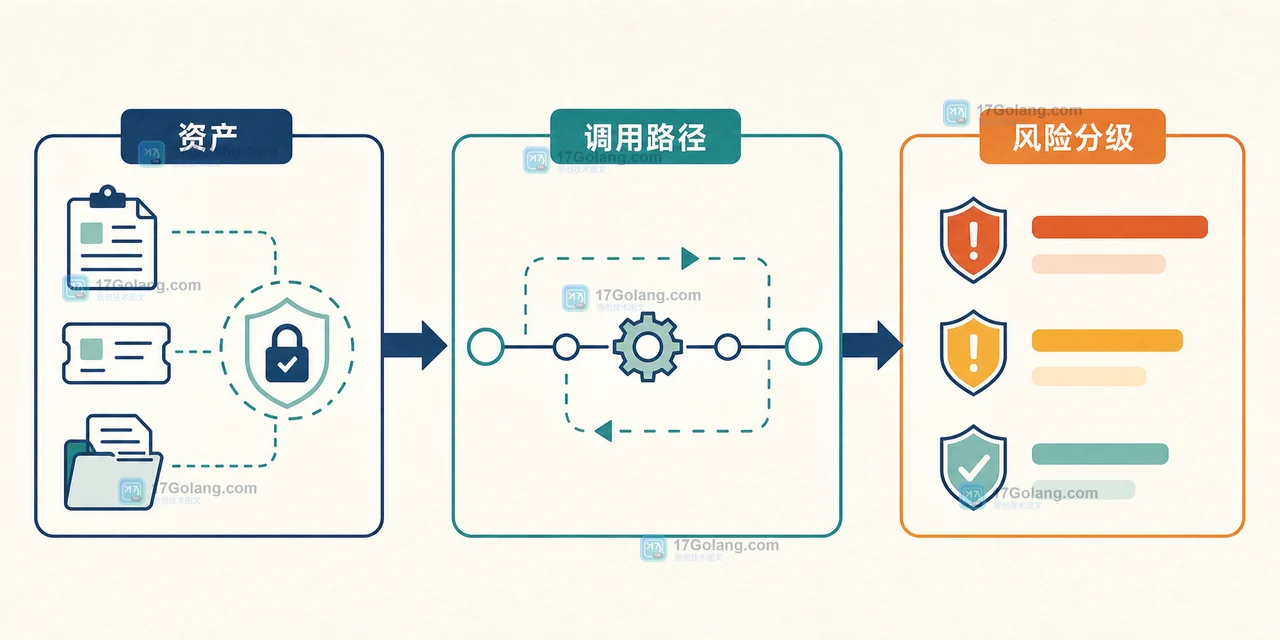 MCP 工具调用遇到超时,不能简单地把所有失败都重试。本文从资产保护、调用路径和错误分级入手,设计一套包含超时、重试、幂等、审计与人工接管的收口方案。111 收藏
-
 RAG 中不要让模型猜来源。给每个检索片段保留稳定 chunk_id,让模型返回可校验的 citations,再由应用层回填标题、页码和原文位置。111 收藏