
大模型回答怎么设计成对评测减少位置偏差
来源:17golang原创
时间:2026-10-05 02:20:15 314浏览 收藏
大模型回答做成对评测时,减少位置偏差最实用的设计不是“提醒裁判不要偏向第一个”,而是让同一对回答分别以 A-B、B-A 两种顺序评两次,再把裁判输出还原到原始回答身份。两次都指向同一个回答才判胜;顺序一换结论就翻转,则标记为不确定、平局或转人工复核。这样能把回答质量与呈现位置拆开,代价是裁判调用量大约增加一倍。
官方评测指南:https://developers.openai.com/api/docs/guides/evaluation-best-practices
位置校准研究:https://aclanthology.org/2024.acl-long.511/
OpenAI 的评测最佳实践把成对比较列为 LLM 裁判常用且相对可靠的形式,同时明确把回答顺序造成的位置偏差、偏爱长回答的冗长偏差列为挑战。ACL 论文进一步展示了:即使提示词要求裁判忽略顺序,交换候选回答的位置仍可能改变结果;论文给出的平衡位置校准思路,就是让每个候选都出现在两个位置,并合并两次评测。
单次 A/B 判断为什么不够
我第一次搭成对评测时,数据表里只保存了 winner=A、winner=B 或 tie。这种结构看起来简单,却把两个不同概念混在了一起:
- 回答身份:哪一个候选模型或版本生成了这段内容;
- 展示位置:本次提示词中它被放在 Candidate A 还是 Candidate B。
如果永远把基线放在 A、把新版本放在 B,裁判对首位或末位的偏好就会持续叠加到模型胜率上。更隐蔽的问题是:只有质量接近的回答容易翻转,而这些样本通常又最能决定一次模型升级是否真实有效。
| 评测设计 | 调用次数 | 能否发现顺序翻转 | 适合用途 |
|---|---|---|---|
| 固定 A-B 单次判断 | 1 | 不能 | 不建议用于模型胜率结论 |
| 随机单次顺序 | 1 | 只能在大样本上稀释系统偏差 | 低成本粗筛 |
| A-B 与 B-A 双向判断 | 2 | 可以定位到每个样本 | 回归评测、模型对比 |
| 双向判断加人工复核 | 2+复核 | 可以处理冲突样本 | 高风险或高价值任务 |
把同一对回答放进两个对称视图
一个评测样本至少保留四个稳定字段:问题、原始回答 answer_a、原始回答 answer_b、样本 ID。构造裁判输入时再生成两个视图:
- 正序视图:Candidate A = answer_a,Candidate B = answer_b;
- 逆序视图:Candidate A = answer_b,Candidate B = answer_a。
这里故意把“原始身份”和“界面标签”分开。裁判只能看到中性的 Candidate A、Candidate B,不应看到模型名、版本号、供应商、价格或“新方案”之类会暗示预期结论的信息。
from dataclasses import dataclass


@dataclass(frozen=True)
class JudgeView:
    sample_id: str
    order: str
    candidate_a: str
    candidate_b: str
    # 记录界面标签对应的原始回答,聚合时不能直接拿 A/B 当答案身份。
    identity_map: dict[str, str]


def build_symmetric_views(sample_id: str, answer_a: str, answer_b: str) -> list[JudgeView]:
    # 同一个样本生成两个完全对称的展示视图。
    return [
        JudgeView(
            sample_id=sample_id,
            order="AB",
            candidate_a=answer_a,
            candidate_b=answer_b,
            identity_map={"A": "answer_a", "B": "answer_b"},
        ),
        JudgeView(
            sample_id=sample_id,
            order="BA",
            candidate_a=answer_b,
            candidate_b=answer_a,
            identity_map={"A": "answer_b", "B": "answer_a"},
        ),
    ]
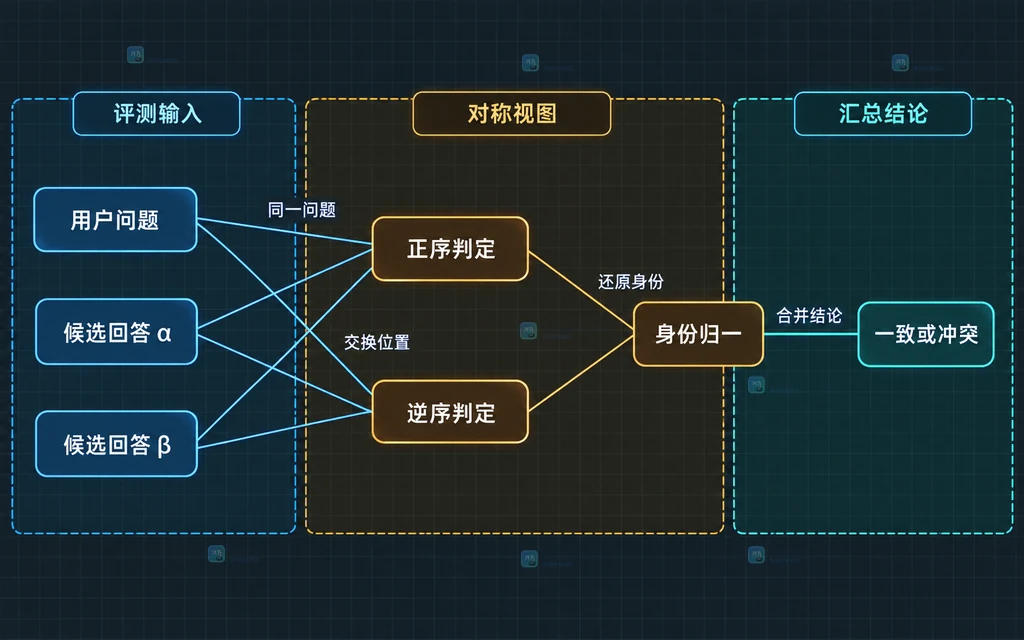
两个视图必须使用同一问题、同一裁判模型、同一采样参数、同一评判标准和同一输出结构。唯一允许改变的是两段回答的位置。否则即使结果不同,也无法判断是顺序、采样还是提示词变化造成的。
评判标准要先固定,再让裁判输出结构化结论
成对比较并不等于一句“哪个更好”。评判标准越模糊,裁判越容易被篇幅、语气、格式和位置牵着走。实用的标准应绑定任务,例如知识问答可以拆为:
- 准确性:关键事实是否正确,是否出现无依据结论;
- 任务完成度:是否真正解决用户提出的问题;
- 相关性:是否围绕问题,是否包含大量无关扩写;
- 清晰度:结构是否便于读者理解和执行;
- 简洁性:在完成任务的前提下,是否避免冗长。
建议裁判只返回 A、B、TIE 三种结论,再给简短依据和按维度的理由。不要让它自由发明“基本胜出”“略微更好”等难以解析的标签。
JUDGE_TEMPLATE = """
你是回答质量评测员。请仅依据下面的任务要求比较两个候选回答。

任务要求:{rubric}
用户问题:{question}

Candidate A:
{candidate_a}

Candidate B:
{candidate_b}

先分别核对准确性、完成度、相关性、清晰度和简洁性。
忽略候选的展示顺序、名称与文风,不因篇幅更长而自动加分。
只返回 winner、reason、criterion_notes 三个字段;winner 只能是 A、B、TIE。
"""


def render_judge_prompt(question: str, rubric: str, view: JudgeView) -> str:
    # 两个方向复用同一模板,避免提示词差异成为额外变量。
    return JUDGE_TEMPLATE.format(
        rubric=rubric,
        question=question,
        candidate_a=view.candidate_a,
        candidate_b=view.candidate_b,
    )
提示词中的“忽略顺序”仍然值得保留,但它只是约束,不是消除偏差的证据。真正的控制来自交换位置后再次判断,以及对两次结果的显式合并。
先还原答案身份,再合并两次判定
最容易写错的地方,是把两个视图返回的字母直接比较。逆序视图里的 A 实际代表原始 answer_b,因此必须先做身份归一。
from typing import Literal

PositionWinner = Literal["A", "B", "TIE"]
FinalWinner = Literal["answer_a", "answer_b", "tie", "uncertain"]


def normalize_winner(view: JudgeView, winner: PositionWinner) -> str:
    # 平局没有位置身份,直接保留为 tie。
    if winner == "TIE":
        return "tie"
    return view.identity_map[winner]


def merge_pairwise_results(forward: str, reverse: str) -> FinalWinner:
    # 两个方向都支持同一原始回答时,才给出明确胜者。
    if forward == reverse and forward in {"answer_a", "answer_b"}:
        return forward

    # 两个方向都判平,保留平局,不强行制造胜者。
    if forward == reverse == "tie":
        return "tie"

    # 其余组合都暴露了位置敏感或边界不清,升级为不确定。
    return "uncertain"
这个合并规则偏保守:一次判 A 胜、一次判平,也不会直接认定 A 胜。生产系统可以按任务风险放宽,例如用多次采样投票或概率平均,但必须在上线前固定规则,不能看完结果后临时挑选对某个模型有利的聚合方式。
一致才定胜负,冲突就升级
交换位置后出现冲突,不意味着样本无用。恰恰相反,它告诉你这对回答可能质量接近、评判标准不够清晰,或者裁判模型对表述、长度和格式过于敏感。可以按下面的方式分层处理:
- 双向一致:计入明确胜负或平局;
- 胜负翻转:标记为位置冲突,不计入单边胜率;
- 胜负与平局混合:标记为边界样本,可增加一次独立裁判;
- 输出解析失败:单独记录为评测基础设施错误,不算模型质量;
- 高价值或高风险样本:交给盲化的人类评审,并保存最终标签。
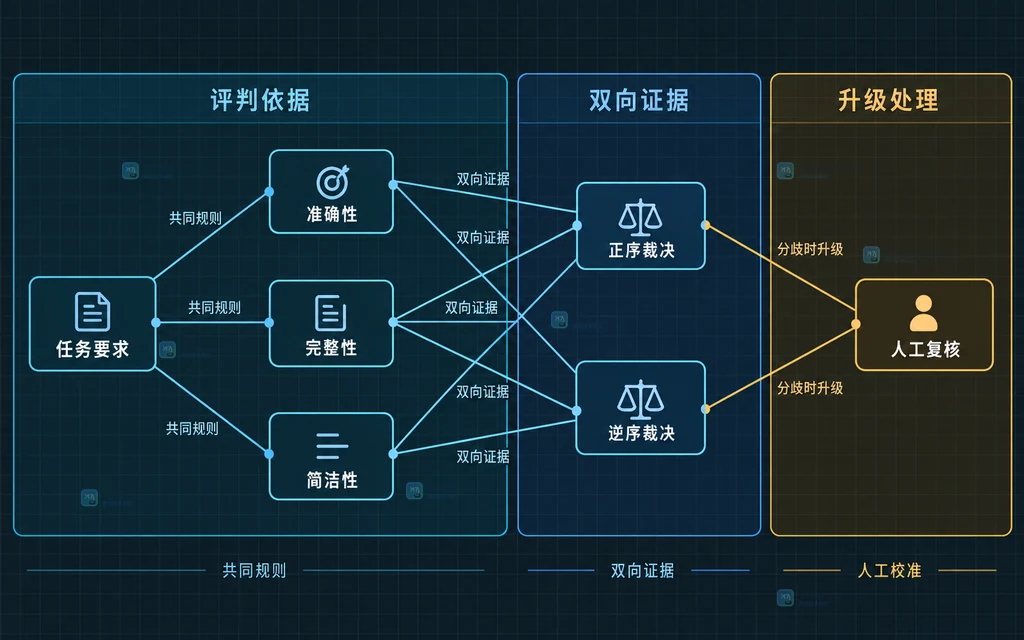
如果业务最终必须给出单一胜率,可以同时报告“保守胜率”和“冲突率”。例如保守胜率只统计双向一致的明确样本;冲突率则表示交换位置后,归一化结论不一致的样本比例。把冲突样本静默丢进某一方,会让位置偏差重新回到总分里。
最少要监控哪几个指标
只有总体胜率不足以判断评测是否稳定。至少同时保存以下指标:
| 指标 | 含义 | 异常时先检查 |
|---|---|---|
| 位置一致率 | 正序和逆序归一后结论一致的比例 | 裁判提示词、候选长度、模型采样 |
| 位置冲突率 | 交换顺序后明确胜者发生翻转的比例 | 答案质量是否接近、标准是否含糊 |
| 平局率 | 两次都判定为平局的比例 | 平局定义是否过宽或过窄 |
| 解析失败率 | 裁判没有返回合法结构的比例 | 结构化输出约束、重试策略 |
| 人工一致率 | 自动裁判与盲化人工标签的一致程度 | 裁判能力、标准示例、任务分层 |
def position_metrics(rows: list[dict]) -> dict[str, float]:
    # rows 中每项已经完成位置标签到原始回答身份的归一。
    total = len(rows)
    if total == 0:
        return {"position_consistency": 0.0, "conflict_rate": 0.0}

    consistent = sum(row["forward"] == row["reverse"] for row in rows)
    conflicts = sum(
        row["forward"] in {"answer_a", "answer_b"}
        and row["reverse"] in {"answer_a", "answer_b"}
        and row["forward"] != row["reverse"]
        for row in rows
    )

    # 一致率和冲突率分开报告,避免只看最终胜率掩盖顺序敏感性。
    return {
        "position_consistency": consistent / total,
        "conflict_rate": conflicts / total,
    }
人工标签不需要覆盖全部数据。可以先做一批分层抽样:双向一致的明显样本、质量接近的冲突样本、不同领域和不同长度区间都要包含。官方评测指南同样建议先把 LLM 裁判与专家人工标签对齐,再考虑扩大规模和优化成本。
兼容不同评测平台时保留哪些字段
无论使用托管 Evals、内部工作流还是自建批处理,数据层都应保留可追溯的中立字段,而不是绑定某家 API 的临时请求格式:
sample_id:同一问题与回答对的稳定标识;answer_a_id、answer_b_id:原始回答身份,不等于展示位置;order:本次是 AB 还是 BA;rubric_version、judge_model、judge_prompt_version:可复现配置;raw_winner:裁判返回的 A、B、TIE;normalized_winner:还原后的 answer_a、answer_b、tie;final_decision:合并后的胜者、平局或 uncertain;reason与按维度记录:用于抽查,不直接替代结构化结论。
平台只要支持提交两次相同裁判任务并返回结构化标签,就能实现这套设计。如果平台暂时不能做双向任务,最低限度应在数据集层随机化 A/B 位置并记录映射,但这只能降低整体系统偏差,不能识别单个样本的翻转。
成本、性能和数据安全的取舍
双向评测会让裁判调用接近翻倍,因此不一定要对所有阶段使用相同强度。一个实用分层是:
- 开发期先用小型代表集做全量双向评测,快速修正标准;
- 回归门禁对高价值、易混淆样本保持双向评测;
- 大规模离线评测先随机单次粗筛,再对接近阈值的样本补双向判断;
- 冲突样本进入更强裁判或人工复核,不反复无限调用同一配置。
数据安全方面,送给裁判的用户问题与回答可能包含个人信息、内部代码或业务数据。进入评测前应做最小化、脱敏和权限隔离,并明确日志保留期限。不要因为评测是“离线任务”就默认可以复制生产数据全集。
常见误区
只在提示词里写“不要受顺序影响”可以吗?
不够。提醒可以保留,但交换位置仍可能改变结论。应通过双向呈现和身份归一实际测出顺序敏感性。
随机一次 A/B 顺序和双向评测有什么区别?
随机一次能在大样本上让两个模型平均出现在不同位置,降低固定位置造成的系统偏差;双向评测则能发现同一个样本是否因换位而翻转。前者偏向总体控制,后者兼顾样本诊断。
两次结果不一致时可以多数投票吗?
只有两次时不存在真正多数。可以增加独立采样或不同裁判形成奇数票,但仍应保留“位置冲突”标记,不能用第三票把偏差证据抹掉。
需要让两个回答长度完全相同吗?
不必机械截成同长度,但要避免某一系统通过无关扩写获得优势。标准中加入简洁性和任务完成度,按长度区间监控结果,并把明显的冗长偏差纳入人工样本。
成对评测能替代人工评测吗?
不能。它适合规模化比较和回归门禁,但裁判自身仍有位置、长度、风格和领域偏差。上线前应使用盲化人工标签校准,并持续抽查分歧样本。
落地检查清单
- 原始回答身份与展示位置分开存储。
- 每个回答对构造 AB、BA 两个视图。
- 两个视图使用完全相同的裁判配置与评判标准。
- 裁判只返回 A、B、TIE 等有限标签和结构化理由。
- 先把位置标签还原为原始回答身份,再合并结论。
- 胜负翻转与胜负/平局混合统一标为不确定。
- 同时报告胜率、位置一致率、冲突率和人工一致率。
- 高风险、冲突和解析异常样本有明确的人工升级路径。
这套方案的价值不是承诺“裁判从此公平”,而是把位置偏差变成一个可以观察、记录和处理的变量。只要回答身份、展示位置和最终结论没有混在一起,后续无论换裁判模型、换平台还是增加人工复核,都能沿着同一份评测记录继续改进。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
293 收藏
-
247 收藏
-
194 收藏
-
268 收藏
-
316 收藏
-
150 收藏
-
148 收藏
-
251 收藏
-
333 收藏
-
145 收藏
-
479 收藏
-
236 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习