
Hugging Face Datasets Streaming 怎么处理超大数据集
来源:17golang原创
时间:2026-10-04 09:57:28 148浏览 收藏
处理远大于本机磁盘或不值得完整下载的数据集时,Hugging Face Datasets 的核心做法是给 load_dataset() 传入 streaming=True。返回值会变成 IterableDataset:样本在迭代时读取,不需要先把全部数据转换并落盘。它适合快速抽样、顺序预处理和持续训练,但不适合依赖任意索引或频繁随机跳转的任务。
官方文档:https://huggingface.co/docs/datasets/stream
streaming=True解决的是完整下载和转换的等待、磁盘占用问题,不会自动消除网络、解压和预处理开销。- 流式加载返回
IterableDataset,擅长顺序迭代,不适合随机访问最后一条或任意一条样本。 shuffle()依靠缓冲区近似打乱,并可打乱分片顺序;缓冲区越大,随机性和内存占用都越高。take()、skip()会锁定分片顺序,需要打乱时应先调用shuffle()。
Streaming 改变的是数据访问方式
普通 Dataset 往往先下载并准备本地 Arrow 数据,再提供快速索引;流式模式则把数据源暴露为可迭代对象。远端 Hub 数据和本地 JSONL、Parquet 等文件都可以按迭代读取。最小用法只需要三行:
from datasets import load_dataset

# streaming=True 返回 IterableDataset,不等待整个数据集下载完成。
dataset = load_dataset("HuggingFaceFW/fineweb", split="train", streaming=True)

# 只读取第一条样本,用于确认字段和内容格式。
first_example = next(iter(dataset))
print(first_example.keys())
这里最重要的核对点不是“能否得到总行数”,而是第一条样本是否包含训练需要的字段、字段类型是否符合预期、数据源是否稳定可读。不要为了查看结构而执行 list(dataset),那会把流式优势重新变成一次长时间的全量消费。
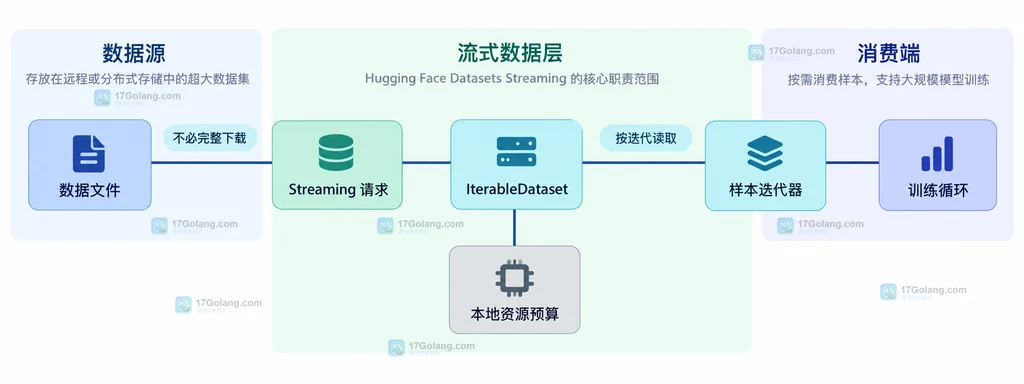
这种模式节省的是“必须完整准备后才能开始”的成本。它并不承诺每个样本都来自内存:训练过程仍可能等待远端读取、压缩文件解码或在线变换。因此,采用 Streaming 的理由应该是磁盘边界、启动速度或持续消费方式,而不是笼统地认为它一定更快。
先用小样本验证字段和数据质量
对超大数据集,最便宜的试错发生在正式训练之前。可以用 take() 查看少量样本,验证 split、列名、空值和文本长度。它返回的仍是可迭代对象,需要显式消费:
from datasets import load_dataset

# 创建流式数据集,不执行全量下载。
dataset = load_dataset("HuggingFaceFW/fineweb", split="train", streaming=True)

# 只取三条做结构检查,避免误触全量遍历。
preview = list(dataset.take(3))
for index, example in enumerate(preview):
    # 只打印序号和字段名,避免把长文本全部输出。
    print(index, sorted(example.keys()))
如果源数据是 Parquet,还可以在加载阶段选择 columns 或配置 filters,让列裁剪和可下推过滤尽量靠近数据源。这样通常比先传输无关列、再在 Python 中删除更符合超大数据集的资源边界。
需要同时抽样和打乱时,顺序不能反。官方文档明确指出,take() 与 skip() 会锁定分片顺序,之后不能再调用 shuffle()。因此应先打乱,再取样或跳过。
把打乱和在线变换排成可控链路
IterableDataset.shuffle() 不是把全部样本放进内存后做完整随机排列。它维护一个缓冲区,从缓冲区随机抽取样本,再用后续样本补位;如果数据由多个分片组成,还会打乱分片顺序。缓冲区大小决定随机混合范围,也决定额外内存开销。
from datasets import load_dataset

# 流式读取训练集。
dataset = load_dataset("HuggingFaceFW/fineweb", split="train", streaming=True)

# 先用固定种子和有限缓冲区打乱,便于复现实验。
dataset = dataset.shuffle(seed=42, buffer_size=10_000)

# 过滤空文本;谓词会在迭代过程中逐条执行。
dataset = dataset.filter(lambda row: bool(row.get("text", "").strip()))

def keep_training_fields(row):
    # 只构造下游需要的字段,避免继续携带无关大字段。
    return {"text": row["text"], "char_count": len(row["text"])}

# map 在样本被拉取时执行,不预先物化完整结果。
dataset = dataset.map(keep_training_fields)

# 在线组成固定大小的批次;最后不足一批时直接丢弃。
batched = dataset.batch(batch_size=32, drop_last_batch=True)
first_batch = next(iter(batched))
print(len(first_batch["text"]))
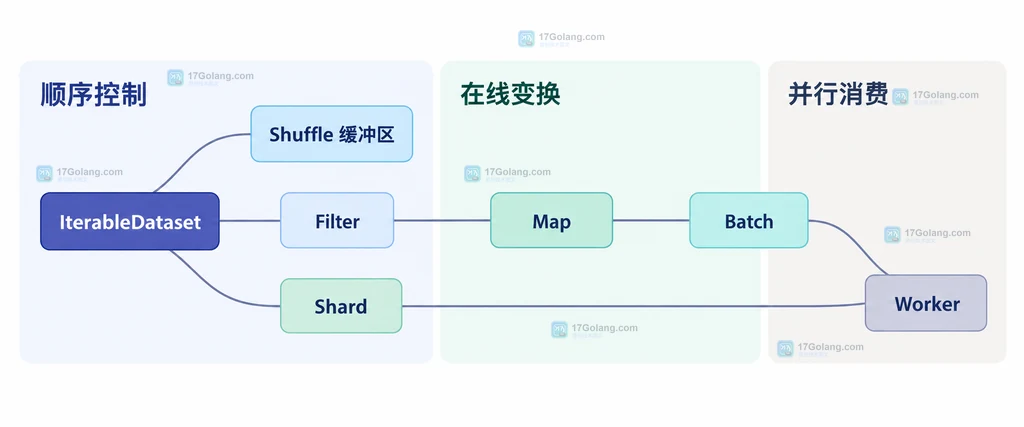
如果预处理函数昂贵,流式模式会把这部分成本持续带进每轮消费。此时应单独测量数据等待时间和变换耗时,再决定是否预先物化处理结果。对于每轮都要重新读取的训练,还可以在每个 epoch 前调用 set_epoch(epoch);文档说明实际种子会结合初始种子和当前 epoch,从而重新打乱。
分片决定多 Worker 能不能真正并行
多进程读取不是把同一个迭代器无条件复制多份。可并行度首先受数据分片约束。对于已有多个文件或可重新分片的数据集,可以用 shard(num_shards, index) 指定当前消费者负责的分片;从本地 Dataset 转成可迭代数据集时,也可以通过 to_iterable_dataset(num_shards=...) 提前建立更多分片。
from datasets import load_dataset

# 创建流式数据集,并保留官方数据源的分片信息。
dataset = load_dataset("fancyzhx/amazon_polarity", split="train", streaming=True)

# 两个独立消费者分别领取不同分片;这里展示第一个消费者。
worker_dataset = dataset.shard(num_shards=2, index=0)

# 每个消费者只迭代自己的数据范围。
for example in worker_dataset.take(2):
    print(example["label"], example["title"][:40])
分片方案需要写进训练配置,而不是临时靠 worker 编号猜测。至少记录总分片数、当前索引、随机种子、epoch 和断点位置。若数据源最终只有一个不可进一步分片的流,多开 worker 也不一定提升吞吐,反而可能增加重复读取或协调成本。
哪些任务适合,哪些任务应该换方案
| 任务 | 是否适合 Streaming | 判断依据 |
|---|---|---|
| 先看几条超大数据集样本 | 适合 | 无需完整下载即可开始迭代 |
| 持续训练或顺序预处理 | 通常适合 | 可以边读边变换、组批和分片 |
| 频繁读取任意索引 | 不适合 | IterableDataset 必须顺序迭代前置样本 |
| 多轮重复且在线变换很昂贵 | 需要测量 | 预先物化结果可能更稳定、更省总成本 |
| 网络不稳定且任务要求严格复现 | 谨慎采用 | 需要重试、版本固定、断点和去重设计 |
正式采用前,可以用一小段训练窗口观察四项指标:每秒有效样本数、模型等待数据的比例、网络或解压失败次数、过滤后样本保留率。如果提高 worker 数或缓冲区后吞吐没有改善,瓶颈可能不在迭代器本身,而在远端带宽、文件格式、解压、映射函数或下游训练。
常见问题
Streaming 会把数据缓存到本地吗?
它的关键语义是按迭代读取,而不是先完整下载并转换整个数据集。运行过程中仍可能出现库和底层文件系统需要的缓存或临时资源,所以磁盘预算不能直接设为零。
buffer_size 越大越好吗?
不是。更大的缓冲区通常能扩大随机混合范围,但也占用更多内存并延长缓冲建立时间。应结合样本大小、可用内存和训练对随机性的要求进行测量。
为什么 take 之后不能 shuffle?
因为 take() 和 skip() 会固定分片顺序。若既要打乱又要抽样,应先 shuffle(),再 take() 或 skip()。
因此,Hugging Face Datasets Streaming 处理超大数据集的正确思路不是“把普通 Dataset 的所有操作原样搬过来”,而是接受顺序迭代模型:先用少量样本验证结构,再选择缓冲打乱和在线变换,最后用分片、种子与吞吐指标管理训练。只要任务不依赖随机索引,并且网络与在线处理成本可控,IterableDataset 就能显著降低开始处理超大数据集的门槛。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
251 收藏
-
333 收藏
-
145 收藏
-
479 收藏
-
236 收藏
-
314 收藏
-
134 收藏
-
357 收藏
-
206 收藏
-
337 收藏
-
133 收藏
-
249 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习