
PEFT LoRA 怎么选择 target_modules
来源:17golang原创
时间:2026-10-04 07:41:30 251浏览 收藏
选择 PEFT LoRA 的 target_modules,不要先背一份固定列表。更稳妥的顺序是:先查看当前模型真实的模块名,再从最小的注意力投影集合建立基线;如果任务需要更强适配能力并且预算允许,再扩大到更多注意力层、MLP 层,或直接使用 "all-linear"。创建 PeftModel 后还要核对实际挂载的 LoRA 层和可训练参数,不能只看配置没有报错。
PEFT 官方文档:https://huggingface.co/docs/peft/main/package_reference/lora
- 常见 Transformers 架构有 PEFT 预定义默认目标,不确定时可以先不写
target_modules。 - 列表按完整名称或模块名后缀匹配,单个字符串按正则匹配;不同模型的层名不能直接照抄。
"all-linear"会选择线性层和 Conv1D;对 PreTrainedModel,输出层会被排除。- 只有全部目标都未命中时才会报错,部分未命中可能被静默跳过,所以必须检查实际状态。
先看模型结构,再决定 target_modules
我第一次把 LoRA 配到陌生架构上时,最不适应的是:别人教程里的 q_proj、v_proj 看起来很标准,但模型里未必真的叫这些名字。target_modules 描述的是要被适配的模块名称,不是抽象功能名;架构一换,命名就可能变成 query、c_attn 或其他形式。
选PEFT LoRA的target_modules不用死记硬背官方示例,优先匹配你当前加载的基座模型注意力层的全量线性层名称,兼容适配当前使用的transformers版本写法,兼顾显存占用和下游任务效果调整覆盖范围即可。
因此,先用 named_modules() 盘点线性模块。我通常只输出候选名称和类型,不打印参数值:
import torch

def list_linear_modules(model):
    # 只列出线性模块名称,避免把庞大的参数内容打印到日志。
    for name, module in model.named_modules():
        if isinstance(module, torch.nn.Linear):
            print(f"{name}: {module.__class__.__name__}")

# 先确认当前架构的真实命名,再填写 target_modules。
list_linear_modules(base_model)
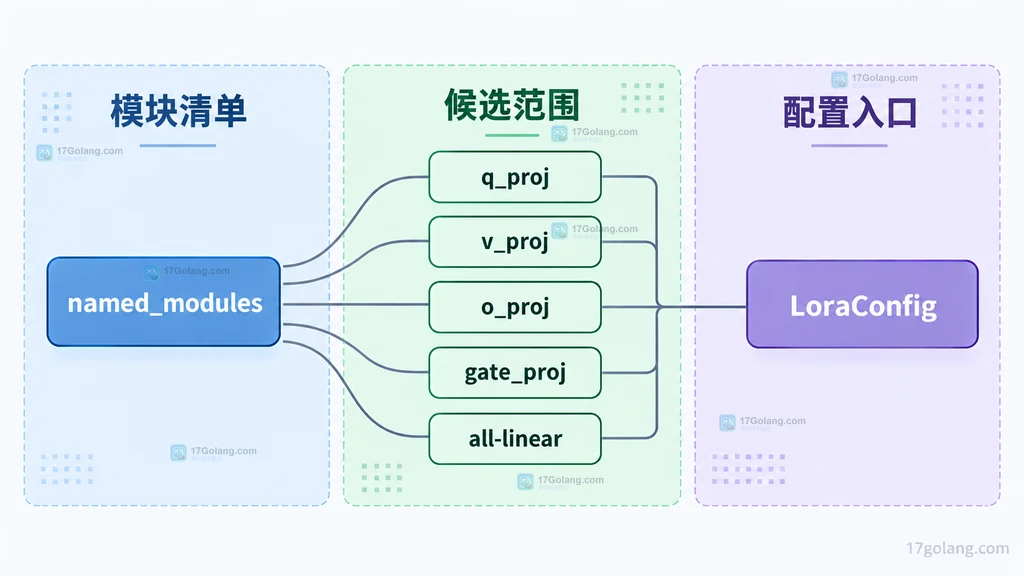
官方参数说明给了两个重要匹配规则:传列表时,PEFT 会尝试完整名称或模块名后缀匹配;传一个字符串时,则按正则表达式匹配。对大多数项目,我更偏向先用明确的列表,因为它更容易阅读、审查和复现。
从最小集合建立第一条可比较基线
对 PEFT 已知的常见架构,可以先省略 target_modules,让库按架构选择预定义目标。官方 Transformers 集成文档提到,Llama、Gemma、Qwen 等常见架构通常已有默认目标,例如 query 和 value 投影。如果架构不在映射中,PEFT 会要求手动指定。
需要显式配置时,注意力的 query/value 投影是一个常见的低成本起点:
from peft import LoraConfig, TaskType, get_peft_model

config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    # 先用小目标集合建立可比较基线,名称必须来自当前模型。
    target_modules=["q_proj", "v_proj"],
)

# 包装后只训练适配器参数,基础模型权重保持冻结。
peft_model = get_peft_model(base_model, config)
这个起点不是“所有模型的最佳答案”。它的价值是让实验范围清楚:先得到一组任务指标、显存占用和训练时长,再决定是否值得扩大目标。对我来说,这比一开始就塞入所有可能层名更容易定位问题。
什么时候扩大到注意力全投影或 all-linear
如果 query/value 基线对任务的适配能力不足,可以把 key 和 output 投影也纳入候选。再往外扩,则会涉及 MLP 的 gate、up、down 等线性层。目标越多,LoRA 可训练参数和优化器状态通常也会增加,训练成本与表达能力之间需要用同一数据、同一评测方法做对照。
| 选择范围 | 典型写法 | 适合的判断起点 |
|---|---|---|
| 使用架构默认值 | 省略 target_modules | PEFT 已识别的常见架构,先求稳 |
| 注意力最小集合 | ["q_proj", "v_proj"] | 参数预算紧,希望建立清晰基线 |
| 注意力全部投影 | q/k/v/o 对应层 | 任务更依赖注意力变换,愿意增加适配容量 |
| 所有线性层 | "all-linear" | QLoRA 风格训练或希望减少架构层名差异 |
PEFT 官方文档建议,QLoRA 风格可以使用 target_modules="all-linear",这样会选择所有线性层与 Conv1D;当基础模型属于 PreTrainedModel 时,输出层会被排除。它避免逐个写架构相关名称,但不等于训练成本不变,也不保证一定优于更小的目标集合。
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    r=16,
    lora_alpha=32,
    # QLoRA 风格覆盖线性层,PEFT 会排除 PreTrainedModel 的输出层。
    target_modules="all-linear",
)

# 扩大目标后要重新记录可训练参数和任务指标,不能沿用旧基线结论。
peft_model = get_peft_model(base_model, config)
特殊架构要区分 target_modules 和 target_parameters
target_modules 面向 nn.Module。部分 MoE 模型把专家权重存成二维或三维 nn.Parameter,而不是独立的 nn.Linear 模块;这时仅靠模块名可能找不到目标。PEFT 为这种情况提供 target_parameters,不要为了命中专家权重而把不存在的层名硬塞进 target_modules。
嵌入层、语言模型头和分类头也需要单独判断。若某个头需要完整训练并随适配器保存,通常应考虑 modules_to_save,而不是把所有非线性职责都混进 LoRA 目标。模型存在权重绑定时,还要结合官方文档检查保存与绑定行为。
创建 PeftModel 后一定要核对命中结果
规模化训练最麻烦的不是完全不匹配,因为全部目标都没命中时通常会报错;更隐蔽的是“部分命中”。PEFT 的故障排查文档说明:如果列表里有些目标匹配、有些不匹配,未匹配项可能被静默跳过。训练仍会启动,但实际适配范围比预期小。
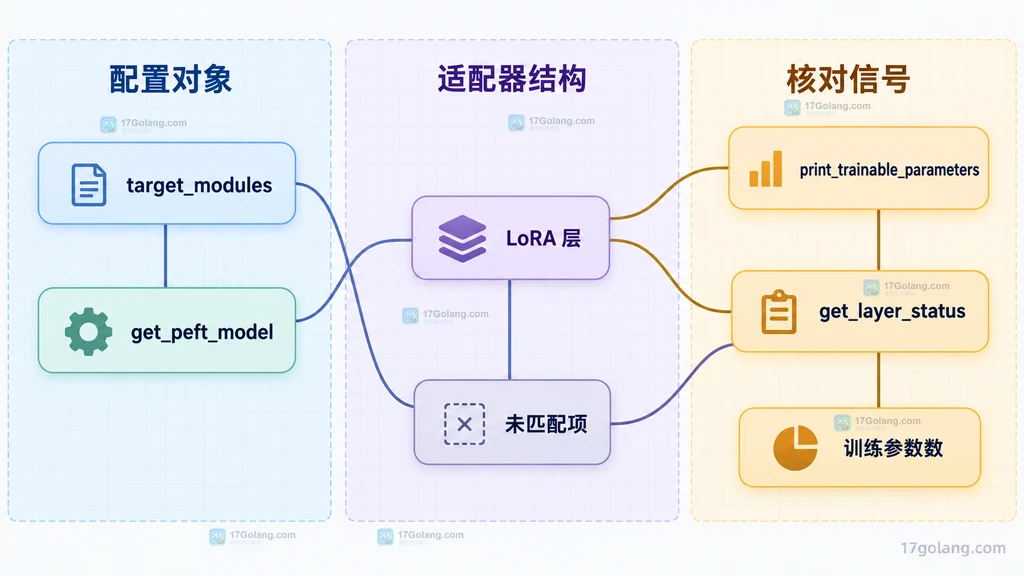
# 可训练参数总量应该与预期目标范围一致,异常偏小通常值得复查。
peft_model.print_trainable_parameters()

# get_layer_status 能查看适配层名称、模块类型、启用状态和活动适配器。
for status in peft_model.get_layer_status():
    print(status.name, status.module_type, status.enabled)
我会把这两项检查变成训练任务的固定启动日志:保存 PEFT 配置、可训练参数数量和适配层名称摘要。这样从单模型扩展到多模型时,层名变化不会悄悄变成训练质量问题。代价是多了一段启动检查和配置维护,但比训练结束后才发现目标层少了一半便宜得多。
一套实用的选择顺序
- 先确认 PEFT 是否已为当前架构提供默认目标;如果有,先建立默认基线。
- 用
model.named_modules()查看真实层名,不从其他模型配置中盲抄。 - 预算紧时从少量注意力投影开始;需要更多容量时再扩大范围。
- 希望覆盖线性层且减少架构命名差异时,评估
"all-linear"。 - 遇到 MoE 的参数张量时检查
target_parameters,不要只盯着模块。 - 创建 PeftModel 后检查可训练参数与适配层状态,再开始正式训练。
这套顺序适合模型种类多、训练任务频繁切换的团队。它不会替你决定最终效果,但能先保证“训练的确发生在你以为的那些位置”,然后再把问题留给数据、任务指标和参数预算。
相关问题
target_modules 可以直接写完整层路径吗?
可以。列表既支持完整名称,也会检查模块名是否以给定字符串结尾;需要精确控制时,完整路径更清楚。传单个字符串则按正则匹配。
为什么配置了三个目标却只命中两个?
当前模型可能没有第三个后缀,或者层被包装后名称变化。部分未命中可能没有警告,应检查 get_layer_status() 和模块树。
all-linear 会包含 lm_head 吗?
对 PreTrainedModel,官方参数说明指出输出层会被排除。若任务需要训练或保存特定头部,应另行评估 modules_to_save。
target_modules 越多效果一定越好吗?
不一定。更多目标意味着更大的适配范围和通常更高的训练成本,也可能增加过拟合或破坏基础能力的风险。应在固定数据与评测条件下比较,而不是只看训练损失。
参考:https://huggingface.co/docs/peft/main/package_reference/lora 与 https://huggingface.co/docs/peft/main/en/developer_guides/troubleshooting。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
333 收藏
-
145 收藏
-
479 收藏
-
236 收藏
-
314 收藏
-
134 收藏
-
357 收藏
-
206 收藏
-
337 收藏
-
133 收藏
-
249 收藏
-
268 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习