
bitsandbytes 量化模型配合 LoRA 训练的显存边界
来源:17golang原创
时间:2026-09-28 21:55:11 249浏览 收藏
把基座模型加载成 4-bit,并不等于训练时每个参数只占半个字节。bitsandbytes 压缩的是冻结基座权重;LoRA 参数、梯度、优化器状态、前向激活、反量化计算缓冲和 CUDA 工作区仍要占显存。于是同一个 7B 模型,有人能在单卡上训练,有人把微批量降到 1 仍然 OOM,差别往往来自序列长度、目标层范围、计算 dtype 和激活保存策略。
- 4-bit 决定基座权重的常驻体积,不决定全部训练显存。
- LoRA 的可训练参数越多,梯度和优化器状态越大;
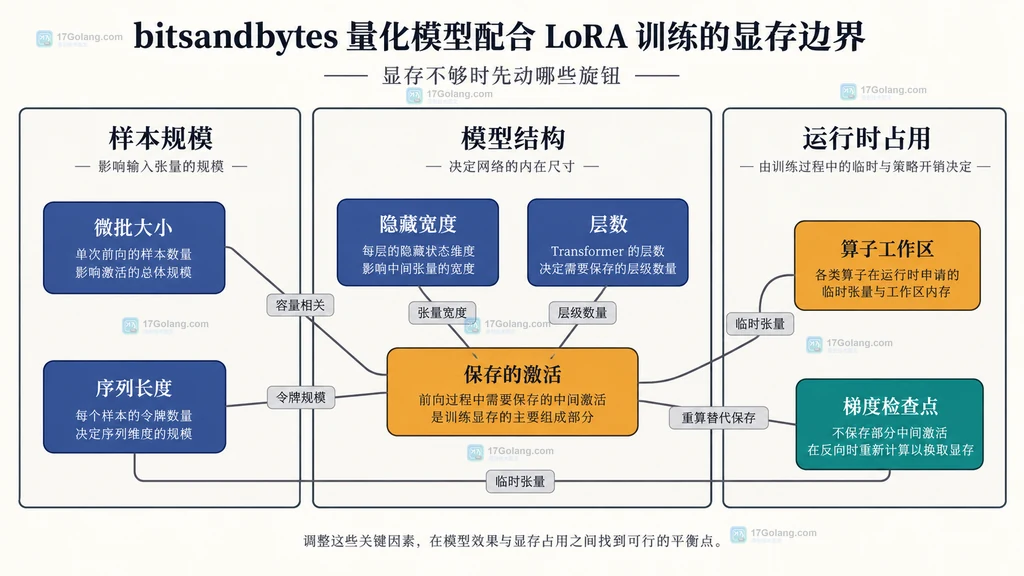
all-linear比只挂注意力层覆盖更广。 - 序列长度和微批量主要推高激活与临时张量,通常是“加载成功、第一步 OOM”的原因。
- 最终边界必须用代表性最长样本跑一次前向与反向,再读取峰值显存,不能只套模型参数量公式。
Transformers bitsandbytes 官方文档:https://huggingface.co/docs/transformers/en/quantization/bitsandbytes
PEFT 量化训练官方文档:https://huggingface.co/docs/peft/developer_guides/quantization
先拆开训练显存,而不是只看 4-bit 权重
QLoRA 的关键关系是:冻结的预训练模型以 4-bit 形式常驻,前向和反向需要时在计算 dtype 中参与运算,梯度只回传到 LoRA 适配器。Hugging Face 文档也明确说明,8-bit 和 4-bit 权重训练只支持训练额外参数,不是直接更新量化基座。
| 显存部分 | 4-bit 是否直接压缩 | 主要受什么影响 |
|---|---|---|
| 冻结基座权重 | 是 | 参数量、NF4/FP4、量化常数与双重量化 |
| LoRA 参数与梯度 | 否 | rank、目标模块数量、保存的额外模块、参数 dtype |
| LoRA 优化器状态 | 不由基座量化决定 | 可训练参数量、优化器类型与状态精度 |
| 训练激活 | 否 | 微批量、序列长度、隐藏宽度、层数、注意力实现 |
| 临时缓冲与预留 | 否 | CUDA 上下文、算子工作区、缓存分配器与碎片 |
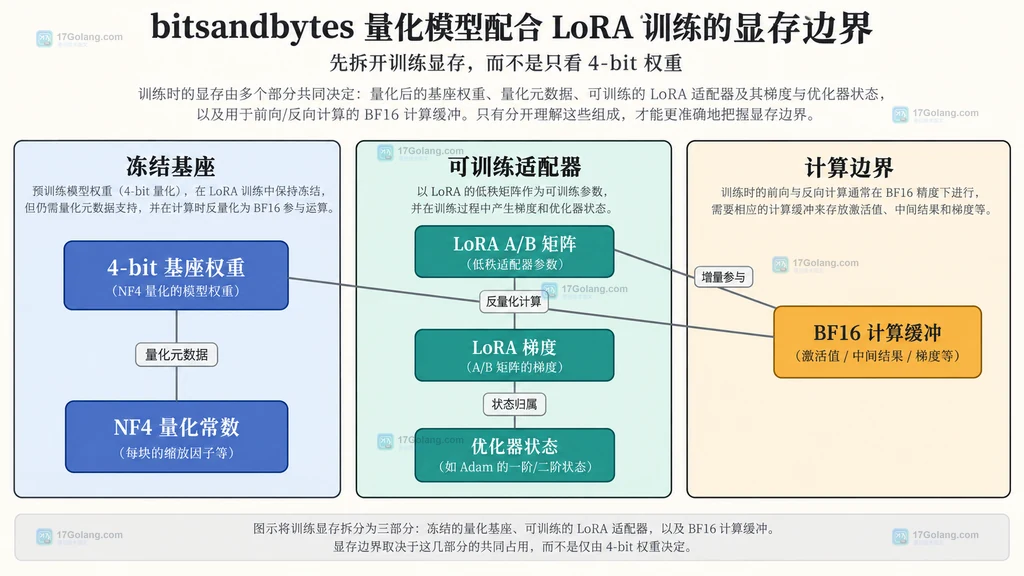
一个便于估算的下界是“参数量 × 0.5 字节”的 4-bit 权重体积,但真实占用一定还包含量化元数据、非量化模块、对齐与运行时缓存。它只能用于判断模型是否大致有机会加载,不能用来承诺训练一定能跑。
用 NF4 和双重量化建立最小配置
官方 PEFT 示例把 4-bit、NF4、双重量化和 BF16 计算组合在一起。NF4 适用于训练 4-bit 基座;双重量化会继续压缩量化常数,Transformers 文档给出的额外节省量为约 0.4 bit/参数。BF16 是否可用仍取决于硬件,不能在不支持的设备上硬开。
# 在隔离环境中安装当前配套组件,避免系统 Python 依赖互相覆盖
python -m pip install --upgrade transformers accelerate bitsandbytes peft datasets
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

# 支持 BF16 时优先使用;否则退回 FP16 计算
compute_dtype = (
    torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float16
)

# NF4 用于 4-bit 训练基座,双重量化继续压缩量化常数
quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=compute_dtype,
)

# 训练时不使用 device_map="auto";让训练框架管理设备放置
model = AutoModelForCausalLM.from_pretrained(
    "mistralai/Mistral-7B-v0.1",
    quantization_config=quant_config,
    dtype=compute_dtype,
)
Transformers 当前文档把 device_map="auto" 定位为推理用法。训练时不要为了“自动塞进多张卡”直接照搬推理配置;单卡先不传 device_map,多卡则交给 Accelerate、FSDP 或明确的训练策略管理。
准备 k-bit 基座,再挂载 LoRA
prepare_model_for_kbit_training() 用于把量化模型预处理成可训练状态,然后再通过 get_peft_model() 注入适配器。QLoRA 风格通常把 LoRA 挂到所有线性层,PEFT 提供了 target_modules="all-linear";如果显存紧张,也可以先只覆盖注意力投影层,但这会改变可训练容量与最终效果。
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training

# 冻结量化基座并完成 k-bit 训练需要的预处理
model = prepare_model_for_kbit_training(model)

# all-linear 覆盖范围更接近 QLoRA;rank 越高,可训练参数越多
lora_config = LoraConfig(
    r=8,
    lora_alpha=16,
    lora_dropout=0.05,
    target_modules="all-linear",
    bias="none",
    task_type="CAUSAL_LM",
)

# 注入适配器,并打印可训练参数比例以核对边界
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()
检查点:打印结果中的可训练参数应只占总参数的一小部分。若比例异常高,先检查 modules_to_save、目标模块和是否意外解冻了基座;否则优化器状态会迅速吞掉量化节省的空间。
用一次代表性训练步测出真实峰值
model.get_memory_footprint() 适合查看已加载模型的内存占用,但训练边界还要包含激活、梯度和优化器状态。应选择接近真实最长序列的一个批次,在优化器已创建后跑完整的前向、反向和更新,并读取 PyTorch 峰值。
import torch

# 清空历史峰值,避免把模型加载阶段和本次训练步混在一起
torch.cuda.reset_peak_memory_stats()
optimizer.zero_grad(set_to_none=True)

# batch 应使用接近生产训练的最长序列与真实掩码
outputs = model(**batch)
loss = outputs.loss
loss.backward()
optimizer.step()

# allocated 是张量实际占用,reserved 包含缓存分配器保留空间
peak_allocated = torch.cuda.max_memory_allocated() / 1024**3
peak_reserved = torch.cuda.max_memory_reserved() / 1024**3
print(f"peak allocated: {peak_allocated:.2f} GiB")
print(f"peak reserved:  {peak_reserved:.2f} GiB")
不要只看空闲显存,也不要只在模型加载后读取一次。最危险的峰值常出现在反向或优化器更新附近。reserved 明显高于 allocated 时,缓存和碎片可能影响下一步分配;但盲目频繁调用 empty_cache() 不是根治方案,首先应降低真实张量峰值。
显存不够时先动哪些旋钮
当模型能加载、第一步却 OOM,优先处理激活规模。一个实用顺序是:
- 先降序列长度。注意力和中间激活会随令牌数显著增长;把无效 padding 清掉通常比先改 LoRA rank 更有效。
- 把每卡微批量降到 1。再用梯度累积恢复所需的有效批量。梯度累积不会降低单个样本的序列激活。
- 开启梯度检查点。它少保存激活、在反向时重算部分前向,代价是训练更慢。
- 缩小 LoRA 覆盖或 rank。这会减少适配器、梯度和优化器状态,但通常不如前两项直接影响激活峰值。
- 最后评估卸载或分片。CPU 卸载会增加传输和主存压力,多卡分片则改变通信与保存流程。
from transformers import TrainingArguments

# 微批量保持为 1,用累积步数恢复更大的有效批量
training_args = TrainingArguments(
    output_dir="./qlora-output",
    per_device_train_batch_size=1,
    gradient_accumulation_steps=8,
    gradient_checkpointing=True,
    bf16=torch.cuda.is_bf16_supported(),
    fp16=not torch.cuda.is_bf16_supported(),
    optim="paged_adamw_8bit",
    logging_steps=10,
)

# 训练结束后显式保存适配器,不把量化基座误当成已全量更新
model.save_pretrained("./qlora-output/adapter")
和全量训练相比,节省发生在哪里
全量微调需要为大量基座参数保存梯度和优化器状态;QLoRA 冻结基座,只训练低秩适配器,因此同时减少了常驻权重、梯度和优化器状态。8-bit 优化器还能压缩优化器统计量,但 LoRA 参数本来就少时,收益可能不如全量训练明显。bitsandbytes 官方也提醒,8-bit 优化器主要节省与参数量成比例的状态;如果任务由激活显存主导,优化器量化不会解决核心瓶颈。
QLoRA 原始论文报告过单张 48GB GPU 微调 65B 模型的研究结果,但这不是所有模型、序列长度和训练栈的通用保证。论文使用了 NF4、双重量化与分页优化器等组合;把其中一个模型规模数字直接换算成自己的显卡上限,会忽略架构、上下文长度、批量和实现差异。
QLoRA 原始论文:https://arxiv.org/abs/2305.14314
采用前要接受的几个边界
- 量化不是免费压缩。运行时仍要反量化参与计算,吞吐和算子支持要在目标硬件上实测。
- BF16 不是所有 GPU 都支持。不支持时退回 FP16,并留意数值稳定性。
- all-linear 增加覆盖也增加状态。效果潜力更大,但参数、梯度和优化器状态同步增长。
- 卸载不等于显存消失。CPU 侧权重可能保留更高精度,并带来总线传输和主存压力。
- 保存的是适配器。部署时必须使用匹配的基座模型和量化配置;合并、反量化或导出都可能需要额外内存。
相关问题
为什么模型能加载,训练第一步仍然 OOM?
加载阶段主要体现常驻权重;第一步还会创建激活、梯度、优化器状态和临时工作区。先检查最长序列、每卡微批量和梯度检查点,而不是继续把基座从 4-bit “再压一次”。
把 LoRA rank 从 16 降到 8 一定能解决吗?
它会减少适配器相关显存,但若峰值主要来自长序列激活,改善可能有限。用峰值测量配合逐项修改,才能确定真正主导项。
梯度累积会降低单步显存吗?
它允许用多个小微批量模拟更大的有效批量,但单个微批量的序列激活仍需完整容纳。先把 per_device_train_batch_size 降低,累积步数才有意义。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
268 收藏
-
221 收藏
-
399 收藏
-
258 收藏
-
360 收藏
-
100 收藏
-
468 收藏
-
268 收藏
-
206 收藏
-
458 收藏
-
478 收藏
-
477 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习