
兼容 OpenAI API 的客户端怎样设置请求超时
来源:17golang原创
时间:2026-11-11 22:26:27 135浏览 收藏
兼容 OpenAI API 的客户端设置请求超时,关键不是把一个数字随手改成 30,而是先确定这个数字覆盖的是整次调用、连接阶段,还是读取模型输出的阶段。最稳妥的迁移方式是:客户端先配置一个默认超时,长任务再用单次请求覆盖,并明确处理超时异常与重试预算。
本文以 Python 客户端为例,兼顾 OpenAI 风格的 base_url 接口和 Hugging Face 的兼容端点。Hugging Face 当前的官方入口是 https://huggingface.co/docs/inference-providers;如果使用官方 Python SDK,可参考 https://github.com/openai/openai-python。示例中的令牌只从环境变量读取,不把凭据写进代码。
直接结论:普通聊天请求可以从客户端级timeout=30.0开始;需要区分连接和读取时,用httpx2.Timeout;只调整某一次请求时,用with_options(timeout=...)或对应客户端的timeout参数。超时后的重试还会继续消耗时间,必须单独配置或计算。
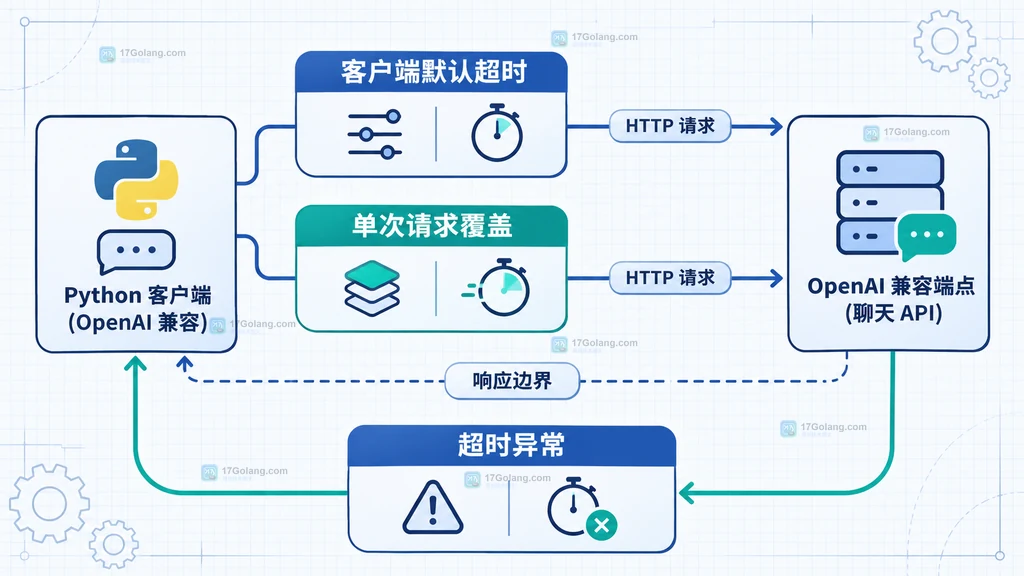
先确定要迁移的超时范围
OpenAI 兼容通常描述请求路径和数据格式相近,不代表所有客户端的超时默认值、异常类名和重试次数都相同。迁移前先把调用分成三类:
| 调用类型 | 常见等待特征 | 建议的起点 |
|---|---|---|
| 短文本聊天 | 连接快、输出短 | 客户端默认 20~60 秒 |
| 长上下文或长输出 | 读取阶段可能持续更久 | 单次请求覆盖更长 read timeout |
| 批处理或后台任务 | 允许排队,但不能无限挂起 | 总预算、重试和任务取消一起设计 |
不要把服务端生成慢、网络连接不上和客户端没有设置上限混成一个问题。一个请求可能在连接阶段就失败,也可能已经建立连接,却在等待响应内容时超时。迁移的目标是让每一种情况都能被识别,而不是追求所有场景共用一个超大数字。
客户端级默认超时怎么设置
如果使用官方 Python SDK,最小改法是在创建客户端时传入 timeout。官方 README 当前给出了数值超时和细粒度超时对象两种形式;兼容端点只需要替换 base_url,超时配置仍然属于客户端侧。
import os

from openai import OpenAI

# base_url 指向兼容 OpenAI API 的服务;令牌从环境变量读取。
client = OpenAI(
    base_url=os.environ["OPENAI_COMPATIBLE_BASE_URL"],
    api_key=os.environ["OPENAI_COMPATIBLE_API_KEY"],
    # 让每个请求都有明确的基础等待上限,单位是秒。
    timeout=30.0,
)

try:
    response = client.chat.completions.create(
        model="your-model",
        messages=[{"role": "user", "content": "用一句话说明超时配置的作用"}],
    )
    print(response.choices[0].message.content)
except Exception as exc:
    # 生产代码应按 SDK 的超时异常和连接异常分别记录,不要吞掉原因。
    print(f"请求失败:{type(exc).__name__}: {exc}")
当前官方 SDK 的默认等待时间并不是兼容端点的统一协议。即使某个 SDK 默认允许等待很久,也不代表你的 Web 请求、队列消费者或命令行任务愿意一直占用连接。因此应用侧应根据自己的 SLA 主动传入默认值。
特殊请求用单次覆盖,不要污染全局
同一个客户端里,普通问答、长文总结和标题生成的等待特征可能不同。把全局 timeout 调到很大,会让短请求故障暴露得更晚;把全局值压得很小,又会误伤长输出。官方 Python SDK 支持通过 with_options 为单次调用生成覆盖配置。
from openai import APITimeoutError

# 长输出只放宽这一条请求,不改变 client 的默认超时。
long_response = client.with_options(
    timeout=120.0,
    # 如果业务不允许同一请求自动重放,可显式关闭默认重试。
    max_retries=0,
)

try:
    response = long_response.chat.completions.create(
        model="your-model",
        messages=[{"role": "user", "content": "整理一份较长的技术说明"}],
    )
except APITimeoutError:
    # 只在这里处理单次长请求的超时,便于返回可重试的业务结果。
    print("长文本请求超过等待预算")
如果某个兼容服务不完全实现官方 SDK 的响应字段,仍然可以复用这种客户端侧超时思路,但要以所用 SDK 的参数和异常文档为准。不要因为接口路径相同,就把一个客户端的异常类型直接复制到另一个客户端。
需要时拆分连接、读取和写入边界
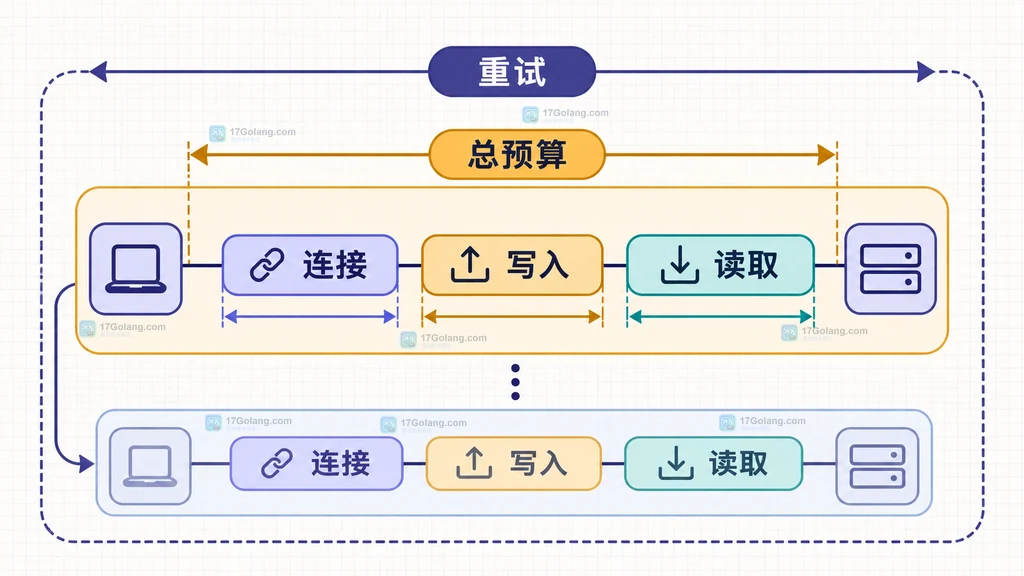
单一的浮点数适合快速设定总超时;排查网络问题时,细粒度对象更容易说明“到底慢在哪里”。当前 OpenAI Python SDK 的 HTTPX2 迁移说明使用 httpx2.Timeout,可以分别给出连接、读取和写入时间。
import httpx2
from openai import OpenAI

# 连接只允许较短时间;读取给模型输出留下更长空间。
timeout = httpx2.Timeout(
    90.0,
    connect=5.0,
    read=60.0,
    write=10.0,
)

client = OpenAI(
    base_url=os.environ["OPENAI_COMPATIBLE_BASE_URL"],
    api_key=os.environ["OPENAI_COMPATIBLE_API_KEY"],
    timeout=timeout,
)

# 不要在代码里打印请求头;这里只演示调用边界。
response = client.chat.completions.create(
    model="your-model",
    messages=[{"role": "user", "content": "返回一个简短结果"}],
)
这里的 connect 更适合发现域名解析、代理或握手问题,read 主要约束等待响应数据的时间,write 则约束请求体写出阶段。具体对象的导入名要和当前 SDK 版本匹配:如果项目迁移到 HTTPX2,就不要继续把旧的 httpx.Timeout 对象无条件传入要求 HTTPX2 的客户端。
把 Hugging Face 兼容客户端的 timeout 单独看待
如果使用 Hugging Face Hub 的 InferenceClient,官方参考文档提供了直接的 timeout 参数。文档说明它的默认值为 None,也就是持续等待;当设置为秒数后,超时会抛出 InferenceTimeoutError。这和 OpenAI Python SDK 的异常名不同,不能混用。
import os

from huggingface_hub import InferenceClient, InferenceTimeoutError

# InferenceClient 的 timeout 是等待服务器响应的秒数。
client = InferenceClient(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
    timeout=45,
)

try:
    result = client.chat.completions.create(
        model="openai/gpt-oss-120b:fastest",
        messages=[{"role": "user", "content": "回答一个简短问题"}],
    )
    print(result.choices[0].message.content)
except InferenceTimeoutError:
    # 只把超时转换成可识别的业务状态,其他 HTTP 错误继续向上抛出。
    print("Inference 请求超时")
这个例子使用的官方地址是 https://huggingface.co/docs/huggingface_hub/package_reference/inference_client。如果你的客户端仍然是 OpenAI SDK,只需要使用兼容端点的 base_url,不要同时套用 InferenceClient 的异常处理。
重试会把总等待时间放大
超时数字只描述一次请求尝试的等待边界,自动重试会在失败后再次发起调用。当前 OpenAI Python SDK 文档说明部分连接错误、408、409、429 和 5xx 默认会重试两次;因此设置 timeout=30 后,业务感知到的总耗时不能简单理解为最多 30 秒。
对幂等的后台读取任务,可以保留有限重试;对会触发计费、写入外部系统或生成不可重复副作用的调用,应先确认服务端是否支持安全重放。需要让上层队列统一控制重试时,可在 SDK 层关闭自动重试:
from openai import OpenAI

# 把重试决策交给上层任务系统,避免 SDK 和队列各自重试。
client = OpenAI(
    base_url=os.environ["OPENAI_COMPATIBLE_BASE_URL"],
    api_key=os.environ["OPENAI_COMPATIBLE_API_KEY"],
    timeout=30.0,
    max_retries=0,
)

try:
    response = client.chat.completions.create(
        model="your-model",
        messages=[{"role": "user", "content": "执行一次可重试的读取任务"}],
    )
except Exception as exc:
    # 由上层根据异常类型、幂等性和剩余预算决定是否重试。
    raise RuntimeError("兼容接口调用失败,请交给任务层处理") from exc
迁移完成前检查这几项
- 入口是否统一:所有兼容端点都通过同一个客户端工厂创建,避免有的调用仍然使用无限等待。
- 默认值是否合理:短请求、长输出和后台任务是否分别有可解释的等待预算。
- 阶段是否可区分:只有在连接、读取或写入明显有不同 SLA 时,才拆分细粒度 timeout。
- 异常是否按 SDK 处理:OpenAI SDK 的
APITimeoutError和 Hugging Face 的InferenceTimeoutError不要互换。 - 重试是否重复:确认 SDK、队列、网关没有同时叠加多层自动重试。
- 密钥是否隔离:base_url、api_key 和响应内容都不应进入日志或文章示例中的真实配置。
如果只是想解决“请求永远不返回”,先加客户端级默认 timeout;如果是长输出偶发超时,再给读取阶段或单次调用放宽;如果总耗时仍然不可控,就把重试从 SDK 层收回到任务层。这样迁移后的设置才真正对应业务预算,而不是只把一个数字改大。
相关问题
兼容 OpenAI API 的服务都支持 timeout 参数吗?
不一定。timeout 通常是客户端或 HTTP 传输层参数,不是聊天请求 JSON 的统一字段。先看当前客户端的构造函数和请求方法文档,不要把它放进 messages 或请求体。
把 timeout 设成很大是不是最稳妥?
不是。过大的值会让连接、线程、协程或队列任务长期占用;应该根据输出长度、网关预算和上层任务超时共同设定,并为长任务使用单次覆盖。
流式输出还需要设置读取超时吗?
需要。流式调用可能持续很久,但中间长时间没有数据仍然可能代表连接异常。应结合客户端对流式读取的 timeout 语义,给每个阶段设置可解释的空闲等待与总任务预算。
-
214 收藏
-
478 收藏
-
484 收藏
-
151 收藏
-
396 收藏
-
204 收藏
-
134 收藏
-
160 收藏
-
科技周边 · 人工智能 | 44分钟前 | 人工智能 · 深度学习 · PyTorch DataLoader Accelerate 多进程训练 split_batches dispatch_batches222 收藏
-
270 收藏
-
378 收藏
-
373 收藏
-
科技周边 · 人工智能 | 57分钟前 | python · 人工智能 · Hugging Face Datasets DatasetDict Features concatenate_datasets161 收藏
-
160 收藏
-
488 收藏
-
239 收藏
-
117 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习