
Datasets streaming 读取大语料的迭代方式
来源:17golang原创
时间:2026-09-29 02:46:43 337浏览 收藏
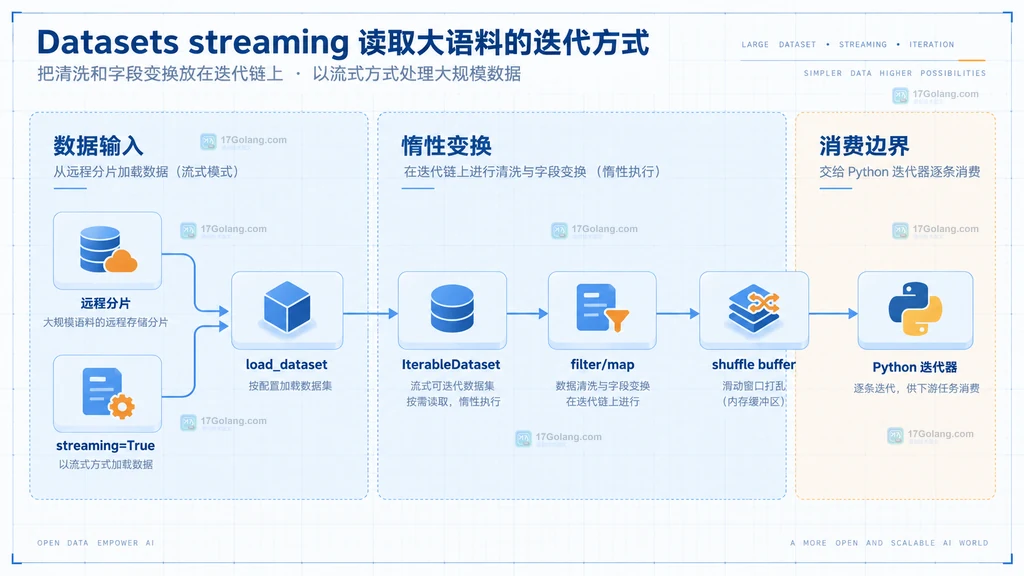
用 Hugging Face Datasets 读取超大语料时,最直接的方式是在 load_dataset() 中设置 streaming=True。返回值不是支持随机索引的普通 Dataset,而是按迭代逐条取数的 IterableDataset:数据不会先完整下载并转换成 Arrow 缓存,而是在真正遍历时从数据分片中按需读取。
官方地址:https://huggingface.co/docs/datasets/en/stream
生产环境的关键不是把
streaming=True加上就结束,而是同时设计好惰性变换、近似打乱、分片并行、轮次重排和检查点恢复。尤其不要对 IterableDataset 使用dataset[0]、len(dataset)或无边界的list(dataset)来模拟普通数据集。
先用最小迭代确认数据能流动
下面是最小可用写法。示例选择一个官方文档使用的公开语料,重点只在迭代方式;如果数据集需要权限,应从环境或登录状态读取令牌,不要把凭据写进源码。
from datasets import load_dataset

# streaming=True 返回 IterableDataset,split 明确只取训练集
dataset = load_dataset(
    "HuggingFaceFW/fineweb",
    split="train",
    streaming=True,
)

# 逐条消费并设置明确上限,避免调试时无边界遍历大语料
for index, example in enumerate(dataset):
    text = example.get("text", "")
    print(index, text[:120])
    if index >= 2:
        break
这里的 for 循环才是触发读取的边界。若只创建对象而不迭代,不会把全部样本装入内存。调试时可以使用 next(iter(dataset)) 或 list(dataset.take(3)) 查看少量样本,但不应直接把整个迭代数据集转换成列表。
流式读取也不等于所有源格式都具备同样效率。官方加载说明指出,文本、CSV、JSONL 等可迭代格式适合流式读取;某些 JSON 文件可能需要完整下载,不同压缩格式的流式能力也不同。若发现首条数据迟迟不返回,应先核对仓库中的文件格式与分片方式,而不是盲目增加 worker。
把清洗和字段变换放在迭代链上
IterableDataset.map() 与 filter() 会在迭代过程中按需应用。这样可以把字段裁剪、空文本过滤和轻量预处理放在数据链上,而不必先生成一份完整中间数据集。
from datasets import load_dataset

# 只保留训练真正需要的文本字段,减少后续对象体积
dataset = load_dataset(
    "HuggingFaceFW/fineweb",
    split="train",
    streaming=True,
).select_columns(["text"])

def has_enough_text(example):
    # 过滤空值和过短文本,函数返回布尔值
    text = example.get("text")
    return isinstance(text, str) and len(text.strip()) >= 200

def normalize(example):
    # map 在迭代时执行,这里只做轻量、确定性的清洗
    return {"text": " ".join(example["text"].split())}

dataset = dataset.filter(has_enough_text).map(normalize)

# take 只取有限样本,适合检查字段和清洗结果
preview = list(dataset.take(2))
print([len(row["text"]) for row in preview])
变换函数会进入训练数据的关键路径,生产上应满足三个条件:输入缺字段时有明确处理;输出字段类型稳定;函数不依赖不可控的全局状态。网络调用、重型模型推理或无上限重试不宜直接塞进单样本 map,否则数据读取会成为吞吐瓶颈,也难以定位卡住的位置。
理解 shuffle 是缓冲区近似打乱
流式数据集无法像普通 Dataset 那样一次拿到全部索引并做全排列。IterableDataset.shuffle() 会打乱数据分片顺序,并维护一个有限的样本缓冲区:先装入 buffer_size 条样本,从中随机取出一条,再用后续样本补位。
from datasets import load_dataset

dataset = load_dataset(
    "HuggingFaceFW/fineweb",
    split="train",
    streaming=True,
)

# 缓冲区越大,局部混合越充分,但会占用更多内存
dataset = dataset.shuffle(seed=42, buffer_size=10_000)

# shuffle 应放在 take 或 skip 之前,避免分片顺序先被固定
sample = list(dataset.take(5))
print(len(sample))
buffer_size=10_000 不代表在全语料上完成均匀随机排列,它只是在有限窗口内近似打乱。缓冲区至少会保存相应数量的样本对象,因此长文本、图片或音频会显著增加内存占用。选值时应以单样本平均大小乘缓冲区数量估算,而不是照搬固定数字。
另一个容易踩坑的顺序是 skip()、take() 与 shuffle()。前两者会固定分片顺序,官方文档建议先完成 shuffle 配置,再进行跳过或截取。若用 skip(n) 作为长距离恢复方案,恢复成本会随着当前分片内的跳过量增长;长期训练更适合保存数据集状态。
用分片和 DataLoader 提升吞吐
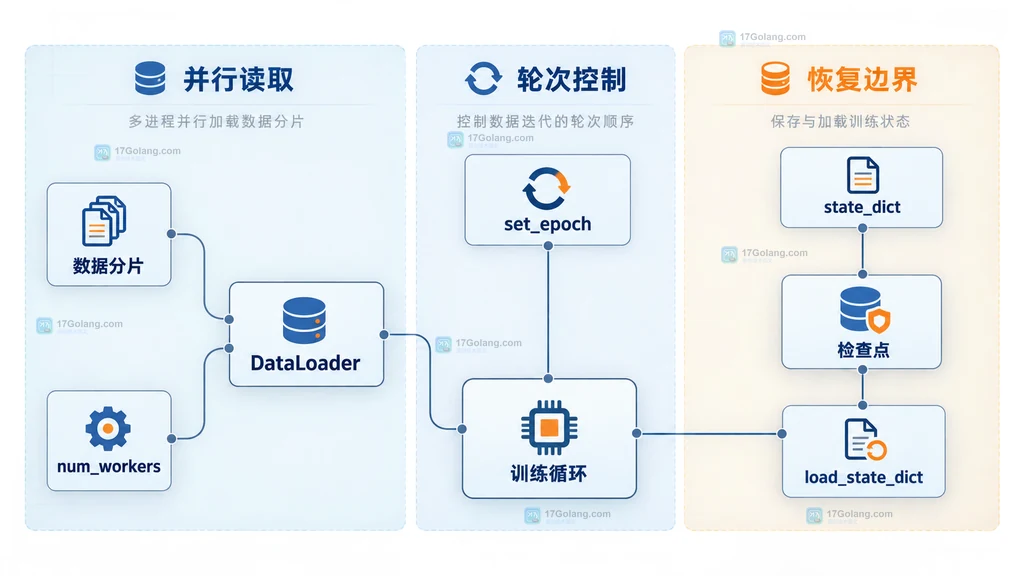
多 worker 能否有效并行,取决于数据是否具有足够多的分片。PyTorch 的 DataLoader 会把分片子集分配给不同 worker;它不是把一个不可分割的远程文件自动切成任意多份。因此,num_workers 大于分片数通常不会带来同比提升。
from datasets import load_dataset
from torch.utils.data import DataLoader

dataset = load_dataset(
    "HuggingFaceFW/fineweb",
    split="train",
    streaming=True,
)

# 转为 torch 格式后仍保持 IterableDataset 的按需迭代特性
dataset = dataset.with_format("torch")

# 多 worker 会分配不同分片;worker 数应结合分片数和网络吞吐测试
loader = DataLoader(dataset, batch_size=8, num_workers=4)

for batch_index, batch in enumerate(loader):
    print(batch_index, len(batch["text"]))
    if batch_index >= 1:
        break
上线时要同时观察网络等待、CPU 清洗耗时、批次组装时间和训练设备空闲率。若 GPU 经常等待而 CPU 与网络仍有余量,可以逐步增加 worker;若网络带宽已满或服务端频繁超时,继续加 worker 只会放大请求压力。对于本地普通 Dataset,先用 to_iterable_dataset(num_shards=...) 建立多个分片,通常比重新走远程 streaming 更快。
为训练轮次和中断恢复保存状态
固定 seed 可以复现同一轮的打乱配置,但多轮训练还要调用 set_epoch(epoch)。官方实现会把当前 epoch 纳入有效随机种子,使不同轮次获得不同顺序,同时保留可控性。
import torch
from datasets import load_dataset

dataset = load_dataset(
    "HuggingFaceFW/fineweb",
    split="train",
    streaming=True,
).shuffle(seed=42, buffer_size=10_000)

for epoch in range(3):
    # 每轮更新 epoch,让分片与缓冲区随机顺序发生可控变化
    dataset.set_epoch(epoch)
    for step, example in enumerate(dataset):
        # 此处接入分词、组批和模型训练逻辑
        if step >= 100:
            break

# 保存当前位置;实际项目应与模型和优化器状态放在同一检查点目录
dataset_state = dataset.state_dict()
torch.save(dataset_state, "dataset-state.pt")

# 重启后恢复到已保存的分片和分片内位置
restored_state = torch.load("dataset-state.pt", weights_only=True)
dataset.load_state_dict(restored_state)
state_dict() 记录当前分片及分片内样本位置,恢复时会跳过已经完成的分片,再在当前分片内定位。它比从头 skip() 更适合长时间训练。但有一个必须记录在发布检查中的边界:启用 shuffle() 后,检查点不会完整保存随机缓冲区里的样本;恢复时缓冲区会重新填充,因此恢复点附近的精确样本顺序不能按“逐条完全一致”理解。
上线前检查资源与可重复性
把流式管道投入长任务前,可以按下面的清单逐项确认:
| 检查项 | 建议 | 常见风险 |
|---|---|---|
| 数据源 | 确认格式可流式读取、分片数量足够 | 单个超大文件限制并行度 |
| 字段 | 先用 take 查看少量样本,再固定必要字段 | 脏值让惰性 map 在长任务中途失败 |
| 打乱 | 记录 seed、buffer_size 和 set_epoch | 把局部近似打乱误认为全局均匀打乱 |
| 并行 | 让 worker 数不超过有效分片与资源预算 | 并发过高引发网络抖动或限流 |
| 凭据 | 从环境或受控登录状态读取访问令牌 | 把令牌写入代码、日志或镜像 |
| 恢复 | 同步保存模型、优化器、步数和数据集状态 | 只恢复模型却从语料开头重新读取 |
| 观测 | 记录已消费样本数、当前 epoch、吞吐和异常 | 只看训练 loss,无法判断数据链是否卡住 |
简而言之,Datasets streaming 适合“边读边用”的大语料任务:用迭代器替代随机索引,用惰性变换替代预先全量加工,用有限缓冲区换取近似打乱,再通过分片、worker 与检查点补足生产能力。它解决的是存储与读取边界,不会自动解决数据质量、全局随机性或训练恢复一致性。
相关问题
streaming 模式会把数据缓存到本地吗?
官方加载说明将 streaming 描述为迭代时按需加载,不像普通模式那样先完整下载并缓存成 Arrow 表。但网络栈、底层文件系统或数据格式仍可能产生临时读取行为,不能把它等同于“完全没有任何本地 I/O”。
为什么不能直接使用 dataset[0]?
IterableDataset 没有普通数据集的随机访问索引。应使用 next(iter(dataset))、take(n) 或有上限的 for 循环。
buffer_size 越大越好吗?
不是。更大的缓冲区通常能扩大近似打乱范围,但会增加内存占用和预填充成本。应依据样本大小、主机内存和实际训练吞吐压测。
恢复检查点后样本顺序会完全一致吗?
未使用 shuffle 时可以根据保存的位置恢复迭代;使用 shuffle 时,缓冲区中的样本不会被完整保留,恢复后会重新填充,因此恢复点附近顺序存在边界。
-
346 收藏
-
235 收藏
-
387 收藏
-
447 收藏
-
360 收藏
-
133 收藏
-
249 收藏
-
268 收藏
-
221 收藏
-
399 收藏
-
258 收藏
-
360 收藏
-
100 收藏
-
468 收藏
-
268 收藏
-
206 收藏
-
458 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习