
OpenAI Realtime API 怎么配置语音轮次检测
来源:17golang原创
时间:2026-10-04 23:59:18 293浏览 收藏
OpenAI Realtime API 的语音轮次检测配置位于 session.audio.input.turn_detection。支持 VAD 的实时语音会话通常默认使用 server_vad;希望减少对自然停顿的误切分,可以选择 semantic_vad;按键说话或完全由客户端决定边界时,把它设为 null。
官方地址:https://developers.openai.com/api/docs/guides/realtime-vad
server_vad:根据音量与静音时长切分,参数直接、延迟可预测。semantic_vad:根据话语是否表达完整来判断结束,更适合自然对话。null:关闭服务端轮次检测,由客户端提交音频并触发响应。
模式命名:把轮次边界当成独立架构决策
我做语音交互时最容易踩的坑,是把“用户没声音了”直接等同于“用户说完了”。短暂停顿、思考、吸气和环境噪声都会让音量边界偏离语义边界。Realtime API 把这个取舍拆成两类 VAD,再允许彻底关闭检测,正好对应三种架构模式。
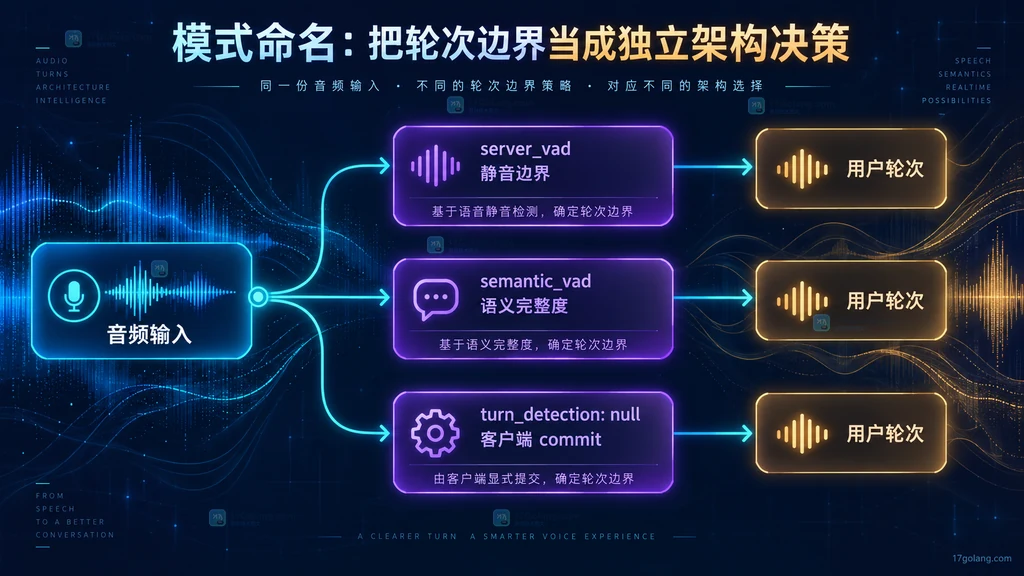
如果业务是客服问答、设备控制等短句场景,我通常先用 server_vad;访谈、辅导、陪练等允许较长停顿的场景,更值得试 semantic_vad;录音按钮、对讲机和严格审核链路则适合关闭 VAD。
适用压力:server_vad 怎样平衡噪声和延迟
server_vad 通过静音区间自动切分音频。三个最常用参数分别控制“多大声才算开始”“起点前保留多少声音”和“安静多久算结束”。
const event = {
  type: "session.update",
  session: {
    type: "realtime",
    audio: {
      input: {
        turn_detection: {
          type: "server_vad",
          threshold: 0.5,          // 提高后需要更响的声音才触发,嘈杂环境可逐步上调。
          prefix_padding_ms: 300,  // 把检测起点前的音频带入本轮,减少吞掉首字。
          silence_duration_ms: 500,// 静音达到该时长后判断本轮结束。
          create_response: true,   // 检测到结束后自动创建模型响应。
          interrupt_response: true// 用户开口时允许打断正在生成的响应。
        }
      }
    }
  }
};

// WebSocket 和 WebRTC 数据通道都可以发送同一类 session.update 事件。
channel.send(JSON.stringify(event));
threshold 范围是 0 到 1,更高意味着需要更响的输入;silence_duration_ms 越短,轮次结束越快,但也更容易把思考停顿误判成结束。prefix_padding_ms 则用于保留检测到说话前的一小段音频。
典型实现:semantic_vad 用语义完整度决定等待
semantic_vad 不只看静音,还根据用户已经说出的内容判断是否可能表达完毕。它的核心调节项是 eagerness:
const event = {
  type: "session.update",
  session: {
    type: "realtime",
    audio: {
      input: {
        turn_detection: {
          type: "semantic_vad",
          eagerness: "low",        // 让用户有更多时间停顿和组织语言。
          create_response: true,   // 对话模式下,轮次结束后自动回复。
          interrupt_response: true// 用户再次开口时允许打断模型语音。
        }
      }
    }
  }
};

// 会话更新后,服务端会返回 session.updated 供客户端同步状态。
channel.send(JSON.stringify(event));
eagerness 可设为 low、medium、high 或 auto,其中 auto 等价于 medium。需要更快切分时选 high,希望减少打断时选 low。
反例:不要把检测、打断和自动响应绑死
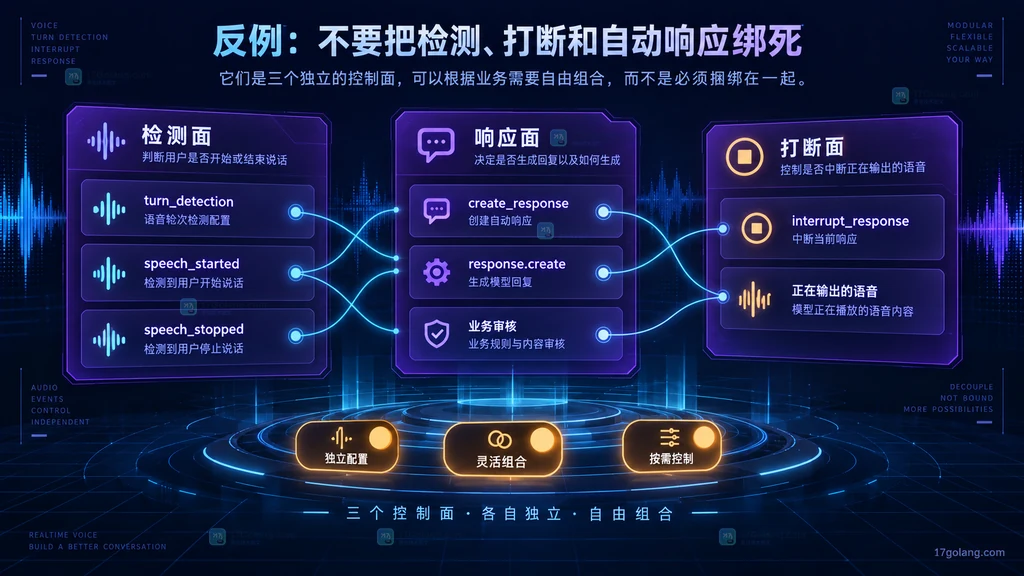
很多应用确实需要自动检测轮次,但不希望立刻回复。例如先做审核、检索增强或输入校验,再决定是否让模型响应。这时保留 VAD,同时把 create_response 和 interrupt_response 设为 false,客户端在检查通过后再发送 response.create。
另一个反例是把转录会话和语音对话会话完全等同。create_response 与 interrupt_response 只用于语音对话模式;在转录会话里,VAD 主要控制音频怎样分块。
后果:关闭 VAD 后客户端接管轮次
按键说话时,可以通过 session.update 把 turn_detection 设为 null。客户端随后负责提交输入缓冲区并触发模型响应:
// 关闭服务端 VAD,让应用自己决定用户何时说完。
channel.send(JSON.stringify({
  type: "session.update",
  session: {
    type: "realtime",
    audio: { input: { turn_detection: null } }
  }
}));

// 松开说话按钮后提交这一轮音频。
channel.send(JSON.stringify({ type: "input_audio_buffer.commit" }));

// 显式请求模型生成下一条响应。
channel.send(JSON.stringify({ type: "response.create" }));
关闭 VAD 后,应用还应在新一轮开始前按传输方式处理缓冲区,并在用户打断时取消未完成响应。需要特别注意:gpt-live-transcribe 和 gpt-realtime-whisper 要求省略轮次检测配置或设为 null,并通过 input_audio_buffer.commit 完成每个音频轮次。
判断清单:怎样选择第一版参数
- 短句、命令、低延迟:从
server_vad开始,逐步调整阈值和静音时长。 - 长句、自然停顿、避免抢话:使用
semantic_vad,先试auto或low。 - 按键说话或严格审核:关闭 VAD,客户端显式 commit 和 create response。
- 要检测但不要自动回答:保留 VAD,将自动响应相关开关设为 false。
- 排查切分问题:监听
input_audio_buffer.speech_started与input_audio_buffer.speech_stopped,把参数、音频环境和事件时间放在同一条观测链路里。
常见问题
问:Realtime API 默认是哪种轮次检测?
对于支持 VAD 的会话和模型,默认是 server_vad。
问:只想让服务端切分音频,但由业务决定何时回答,可以吗?
可以。保留 VAD,把 create_response 与 interrupt_response 设为 false,再由客户端发送 response.create。
问:静音时长是不是越短越好?
不是。更短会降低等待延迟,也会增加把自然停顿切成两轮的概率,需要用真实噪声与说话节奏调参。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
247 收藏
-
194 收藏
-
268 收藏
-
316 收藏
-
150 收藏
-
148 收藏
-
251 收藏
-
333 收藏
-
145 收藏
-
479 收藏
-
236 收藏
-
314 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习