
PyTorch DataLoader 多进程为什么会重复随机数据
来源:17golang原创
时间:2026-10-04 14:27:44 316浏览 收藏
PyTorch DataLoader 开启多进程后出现“随机数据重复”,通常不是一个原因:如果重复的是随机裁剪、噪声或采样值,先查 worker 中 Python random、NumPy 或自建随机对象的状态;如果重复的是相同原始记录,先查 IterableDataset 是否给每个 worker 都遍历了同一段数据。PyTorch 会给每个 worker 设置不同的 PyTorch seed,但第三方随机库和可迭代数据副本仍需要显式处理。
官方文档:https://docs.pytorch.org/docs/stable/data.html
排查时不要一看到重复就继续叠加
manual_seed。先标出 worker id、样本 id 和随机来源,确认是“同一条样本被读了多次”,还是“不同样本拿到了相同随机变换”。两类问题的修复方向完全不同。
问题现场:多开 worker 后随机值像复制出来的
我排查这类问题时,最先遇到的误区是把 shuffle=True 当成万能开关。它控制的是索引顺序,并不负责重置 Dataset 内部所有随机源。一个样本即使由不同索引取出,随机增强函数仍可能因为共享或复制的状态给出相同结果。
另一个常见现场是把日志里的“重复样本”也归因于 seed。实际上,对 map-style Dataset,DataLoader 的索引通常由主进程中的 Sampler 产生并交给 worker;对 IterableDataset,每个 worker 都拿到 Dataset 的副本,如果 __iter__ 没有分片,多个副本就会从同一个起点读取同一批记录。
先判断:重复的是随机值还是样本
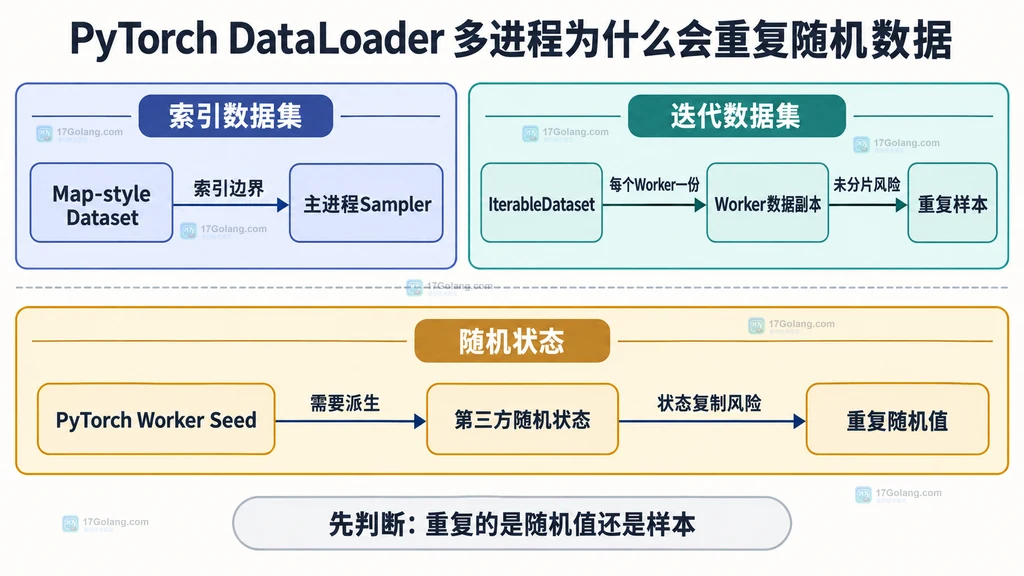
| 观察到的现象 | 优先检查 | 典型修复 |
|---|---|---|
| 样本 id 不同,但裁剪坐标或噪声相同 | random、NumPy、自建 RNG | 在 worker_init_fn 中派生种子 |
| 不同 worker 返回相同样本 id | IterableDataset.__iter__ | 按 worker id 切分范围 |
| 每次启动结果不同,单次运行不重复 | 主进程 generator | 给 DataLoader 传固定 Generator |
| 开启 persistent_workers 后跨 epoch 行为不符合预期 | Dataset 内部状态是否持续存在 | 把 epoch 状态设计成可显式更新 |
为了确认是哪一种,不必先改训练代码。可以临时让 Dataset 返回诊断字段:worker id、样本 id、torch.initial_seed(),以及各随机库的一次取值。下面只展示诊断写法,不把输出假装成本机实测结果。
import random
import numpy as np
import torch
from torch.utils.data import Dataset, get_worker_info

class InspectDataset(Dataset):
    def __len__(self):
        return 32

    def __getitem__(self, index):
        # 记录当前 worker;单进程加载时 worker_id 使用 -1。
        info = get_worker_info()
        worker_id = -1 if info is None else info.id
        return {
            "sample_id": index,
            "worker_id": worker_id,
            "torch_seed": torch.initial_seed(),
            "python_random": random.random(),
            "numpy_random": float(np.random.random()),
        }
如果 sample_id 本身重复,先看 Dataset 类型和 Sampler;如果 sample id 不同而某一列随机值持续重复,问题就落在那一套随机状态上。不要只打印 batch 内容,因为增强后的张量相同不一定能说明原始样本是否相同。
定位原因:PyTorch seed 不等于所有随机库都已处理
官方文档说明,多进程 DataLoader 默认把每个 worker 的 PyTorch seed 设置为 base_seed + worker_id。base_seed 来自主进程 RNG,或者来自传给 DataLoader 的 generator。因此,worker 之间的 torch.initial_seed() 应当不同。
但 Dataset 中的随机逻辑可能不只调用 torch.rand。它还可能使用 Python random、NumPy,或者在 __init__ 中提前创建一个随机生成器对象。官方可复现性文档仍建议在 worker_init_fn 中读取 PyTorch 已分配的 seed,再初始化 NumPy 和 Python random。这样配置的价值不只是“让值不同”,还包括让同一组代码在相同配置下可复现。
修复随机状态:让每个 worker 派生自己的种子
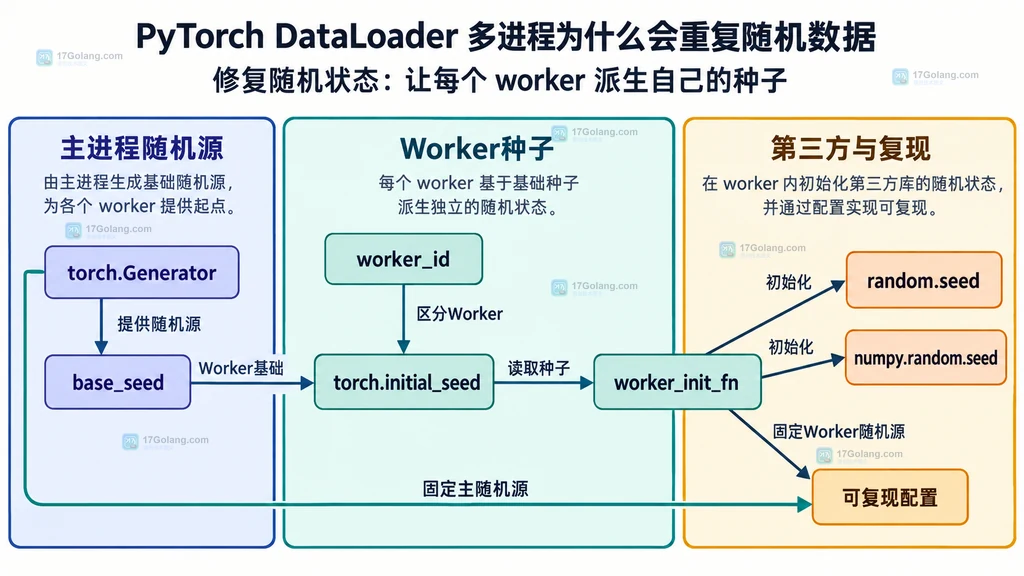
下面采用 PyTorch 官方可复现性文档推荐的组合:主进程给 DataLoader 一个固定 torch.Generator,每个 worker 再用 torch.initial_seed() 初始化 Python 与 NumPy。取模 2**32 是为了得到适合这些接口的 32 位种子。
import random
import numpy as np
import torch
from torch.utils.data import DataLoader

def seed_worker(worker_id):
    # PyTorch 已把 worker_id 纳入初始种子,这里不要再次手工相加。
    worker_seed = torch.initial_seed() % (2**32)
    np.random.seed(worker_seed)  # 初始化 NumPy 全局随机状态。
    random.seed(worker_seed)  # 初始化 Python random 全局状态。

generator = torch.Generator()
generator.manual_seed(20261004)  # 固定主进程用于采样和派生 worker 的随机源。

loader = DataLoader(
    dataset,
    batch_size=8,
    shuffle=True,
    num_workers=4,
    worker_init_fn=seed_worker,
    generator=generator,
)
worker_init_fn 必须是模块顶层可导入函数,特别是在使用 spawn 的平台上不要写成 lambda。还要注意,np.random.seed 只影响 NumPy 的全局旧式随机状态;如果 Dataset 保存的是提前创建的 np.random.default_rng() 实例,就要在每个 worker 中单独创建或重置该实例。
import numpy as np
import torch
from torch.utils.data import Dataset, get_worker_info

class AugmentDataset(Dataset):
    def __init__(self, items):
        self.items = items
        self.rng = None  # 不在主进程提前冻结自建 RNG 状态。

    def __len__(self):
        return len(self.items)

    def __getitem__(self, index):
        if self.rng is None:
            # 每个 Dataset 副本首次访问时,从本 worker 的 PyTorch seed 派生 RNG。
            info = get_worker_info()
            seed = torch.initial_seed() if info is None else info.seed
            self.rng = np.random.default_rng(seed % (2**32))
        noise = self.rng.normal(0.0, 0.01)
        return self.items[index], noise
这种按 worker 延迟创建 RNG 的写法适合自建生成器。若使用 persistent_workers=True,Dataset 副本会继续存活,RNG 状态也会继续推进;如果业务要求每个 epoch 从新种子开始,就需要额外把 epoch 信息传给 worker,而不是期待 worker_init_fn 每个 epoch 自动重跑。
修复重复样本:给 IterableDataset 的副本分片
如果重复的是样本记录,继续调整 seed 往往没有用。IterableDataset 的每个 worker 都有一个 Dataset 副本,朴素的 __iter__ 会让所有副本遍历相同范围。官方文档建议通过 get_worker_info() 区分副本并切分工作量。
import math
from torch.utils.data import IterableDataset, get_worker_info

class RangeDataset(IterableDataset):
    def __init__(self, start, end):
        self.start = start
        self.end = end

    def __iter__(self):
        info = get_worker_info()
        if info is None:
            # num_workers=0 时由主进程遍历完整区间。
            iter_start, iter_end = self.start, self.end
        else:
            # 多进程时把区间按 worker 数量切成互不重叠的片段。
            per_worker = int(math.ceil((self.end - self.start) / info.num_workers))
            iter_start = self.start + info.id * per_worker
            iter_end = min(iter_start + per_worker, self.end)
        return iter(range(iter_start, iter_end))
流式文件、消息队列和远程数据源不一定能按整数区间切分,但原则相同:每个 worker 必须拥有互斥的文件列表、分片编号、游标范围或队列分区。随机 seed 只能改变抽样顺序,不能把同一个数据源副本自动拆成互斥分片。
验证结果:看三组证据,不只看一批数据
修复后我通常核对三件事。第一,worker id 不同的时候 torch.initial_seed() 不同;第二,固定 DataLoader generator 后,重新启动同一配置能得到可复现的索引和随机序列;第三,IterableDataset 的样本 id 在 worker 之间没有交叉。
还要把“可复现”和“每个 worker 不重复”分开。固定所有 seed 的目标,是相同配置重复运行得到相同结果;在一次运行内部,不同 worker 仍应从不同 seed 或不同数据分片工作。把所有 worker 都强行设成同一个常量,虽然看上去更可控,反而会制造标题里的重复问题。
几个容易漏掉的边界
- Map-style Dataset:shuffle 索引由主进程 Sampler 产生。样本重复时还要检查自定义 Sampler、replacement 采样或 Dataset 的索引映射。
- IterableDataset:
drop_last针对每个 worker 的副本丢弃最后一个不完整 batch,统计数量时不要按单进程直觉推算。 - persistent_workers:worker 和 Dataset 实例不会在每轮迭代结束后销毁,内部缓存与 RNG 会保留。
- Windows/macOS spawn:主入口放进
if __name__ == "__main__":,Dataset、collate_fn 和 worker_init_fn 使用顶层定义。 - 分布式训练:进程 rank 与 DataLoader worker id 是两层并行身份;还要确认各 rank 的 Sampler 与种子设计,不能只看单个进程。
常见问题
已经 torch.manual_seed,为什么 NumPy 增强还会重复?
torch.manual_seed 管理 PyTorch RNG,不等于重置 Dataset 中所有第三方随机对象。按官方建议在 worker_init_fn 中用 torch.initial_seed() 派生 NumPy 和 Python random 的种子。
shuffle=True 为什么不能解决 IterableDataset 重复?
IterableDataset 没有普通索引和 Sampler 的同一语义,迭代顺序由用户实现控制。每个 worker 拿到副本后必须自行分片,否则仍会遍历相同数据。
worker_init_fn 里需要再加 worker_id 吗?
通常不需要。PyTorch 分配的 worker seed 已经基于 base_seed + worker_id,直接读取 torch.initial_seed() 或 get_worker_info().seed 即可。
固定 generator 会让所有 worker 的随机值相同吗?
不会。generator 固定的是主随机源和可复现关系,PyTorch 仍会为不同 worker 派生不同的 worker seed。重复通常来自第三方状态未正确派生,或 IterableDataset 没有分片。
总结
PyTorch DataLoader 多进程中的重复随机数据,先分成两类:随机增强重复,检查每个 worker 的第三方 RNG;原始样本重复,检查 IterableDataset 副本是否分片。标准修复是用固定 torch.Generator 控制主随机源,用 worker_init_fn 从 torch.initial_seed() 派生 Python 与 NumPy seed,并用 get_worker_info() 给可迭代数据分配互斥范围。把这三层分开后,问题通常不再需要靠反复更换常量 seed 猜答案。
-
284 收藏
-
176 收藏
-
387 收藏
-
310 收藏
-
328 收藏
-
150 收藏
-
148 收藏
-
251 收藏
-
333 收藏
-
145 收藏
-
479 收藏
-
236 收藏
-
314 收藏
-
134 收藏
-
357 收藏
-
206 收藏
-
337 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习