
向量检索用余弦距离与内积的参数对齐方案
来源:17golang原创
时间:2026-11-13 15:10:57 459浏览 收藏
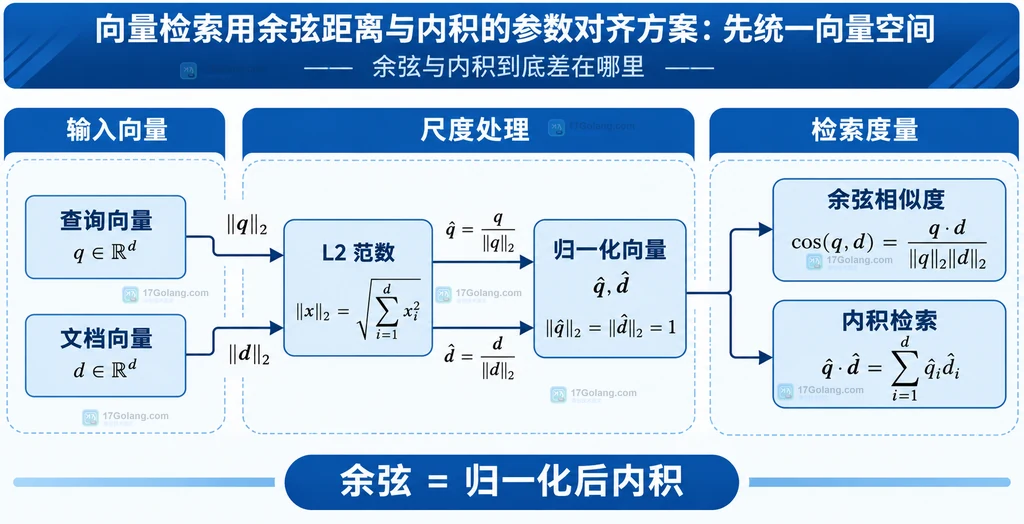
向量检索从余弦距离切换到内积时,不能只把索引参数从 cosine 改成 IP 或 dot。真正决定排序是否保持一致的是:建库向量和查询向量是否都经过同样的 L2 归一化。两侧都归一化后,内积等价于余弦相似度;如果向量仍保留不同长度,内积会把长度也计入分数,top-k 结果就可能发生变化。
官方资料入口:https://huggingface.co/learn/cookbook/en/advanced_rag
Faiss 度量说明:https://github.com/facebookresearch/faiss/wiki/MetricType-and-distances
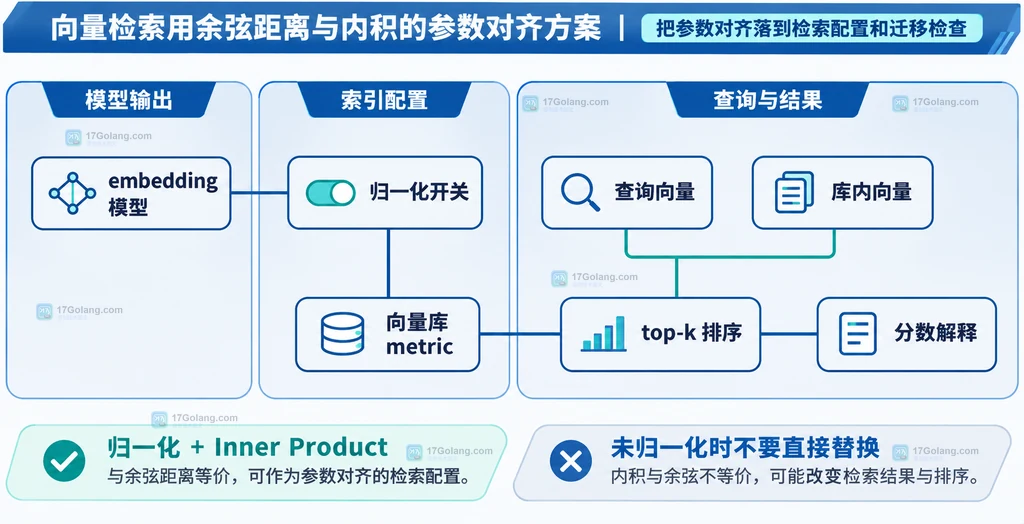
对齐方案可以压缩成一句话:同一个 embedding 模型、同一种归一化策略、同一种向量库 metric,并且查询侧和建库侧必须成对处理。
- 余弦相似度比较方向,公式中会除以两个向量的 L2 范数。
- 内积同时受到方向和长度影响,只有单位向量之间的内积才等价于余弦相似度。
- 迁移时先核对范数,再核对 metric,最后才比较分数和 top-k。
先把两种度量的输入含义分开
设查询向量为 q,库内向量为 x。余弦相似度是 q·x / (||q|| × ||x||),它会消除长度因素;内积则直接计算 q·x。因此,两个方向相同但长度不同的向量,在余弦下可以得到相同方向分数,在内积下却可能因为长度更大而排名更靠前。
Hugging Face 的 RAG 示例也把这一区别说得很清楚:余弦需要把 embedding 归一化到单位范数,内积会把向量长度带入相似度。Faiss 的官方说明进一步给出工程映射:先归一化,再使用最大内积索引,就可以实现余弦检索。
把建库向量和查询向量同时归一化
如果目标是让内积复现余弦排序,归一化必须发生在两侧:写入索引前处理库内向量,查询前处理 query。只处理库内向量或只处理 query,都不能保证分数具有同一含义。
import numpy as np

def l2_normalize(vectors: np.ndarray) -> np.ndarray:
    # 沿最后一个维度计算每条向量的 L2 范数,避免把样本混在一起
    norms = np.linalg.norm(vectors, axis=1, keepdims=True)
    # 零向量没有方向,先拒绝它,避免除零后得到 NaN
    if np.any(norms == 0):
        raise ValueError("不能对零向量执行余弦检索")
    # 建库和查询必须调用同一个归一化函数
    return vectors / norms

documents = l2_normalize(document_embeddings)
query = l2_normalize(query_embedding[None, :])[0]

# 归一化后,dot(query, documents[i]) 就是余弦相似度
scores = documents @ query
top_indices = np.argsort(-scores)[:top_k]  # 相似度越大,排名越靠前
代码中的输入约定是二维的 [样本数, 维度] 数组。工程中还要记录维度、dtype 和归一化开关,避免离线建库脚本与在线查询服务各自实现一套略有差异的预处理。
用同一语义映射向量库参数
不同向量库的字段名称不完全相同:有的使用 Cosine,有的使用 IP,有的使用 Dot。不要根据名称猜测分数含义,应该先确认三个事实:库是否在内部自动归一化、索引按大分数还是小距离排序、返回值是相似度还是距离。
以 Faiss 为例,已经手动归一化的向量可以放入 IndexFlatIP,查询向量也要先归一化。以 Qdrant 为例,集合配置的 Cosine 会按余弦语义处理,文档也说明其搜索实现可以在归一化向量上使用点积。迁移时不能把一个系统返回的“距离”直接当作另一个系统的“相似度”。
import faiss

# embeddings 已经在进入索引前做过 L2 归一化
dimension = embeddings.shape[1]
index = faiss.IndexFlatIP(dimension)  # IP 按内积从大到小取结果
index.add(embeddings.astype("float32"))

# 查询侧必须沿用相同的归一化规则和 float32 输入
query = l2_normalize(query_embedding[None, :]).astype("float32")
scores, ids = index.search(query, top_k)

# scores 是内积;当两侧都是单位向量时可按余弦相似度解释
for item_id, score in zip(ids[0], scores[0]):
    print(item_id, float(score))
如果原系统使用 cosine,而新系统使用 dot 或 IP,最稳妥的迁移记录应包含“原 metric、目标 metric、是否归一化、分数方向、阈值换算”五列。这样后续看到结果差异时,能区分配置问题和模型本身的差异。
用固定样本检查迁移是否真的对齐
迁移测试不要一开始就比较线上所有结果。先准备少量固定的文档向量和 query,保存源系统的 top-k ID、分数、向量范数以及模型版本。然后在目标系统按相同预处理重放这组输入。
def compare_scores(query, target, source_score):
    # 手算两种分数,先判断差异来自公式还是来自索引配置
    query_norm = np.linalg.norm(query)
    target_norm = np.linalg.norm(target)
    cosine = float(np.dot(query, target) / (query_norm * target_norm))
    inner_product = float(np.dot(query, target))

    # 输出范数是排查“只归一化了一侧”的最短证据
    print({
        "query_norm": float(query_norm),
        "target_norm": float(target_norm),
        "cosine": cosine,
        "inner_product": inner_product,
        "source_score": float(source_score),
    })
    return cosine, inner_product

cosine, inner_product = compare_scores(query, target, source_score)
# 只有在 query_norm 和 target_norm 接近 1 时,才应期待两者接近
if abs(cosine - inner_product) > 1e-4:
    print("检查归一化策略、metric 及分数方向")
检查顺序建议固定为:第一,维度和模型输出是否一致;第二,query 与库向量的范数是否都接近 1;第三,索引 metric 是否映射正确;第四,排序方向是否一致;第五,top-k 的 ID 重合度是否满足业务要求。不要只看某一个分数相等,因为量化、近似索引和浮点精度也会带来小幅差异。
未归一化时为什么不能直接替换 metric
有些 embedding 模型或排序任务会刻意保留向量长度,让长度表达置信度、热度或其他训练信号。此时把 cosine 改为 dot 会改变问题定义,而不是简单的性能优化。反过来,把 dot 改成 cosine 也会抹掉长度信息。
因此,遇到未归一化向量时先回答两个问题:模型训练或官方文档推荐哪一种度量?向量长度是否具有业务意义?如果长度只是预处理差异,可以统一做 L2 归一化并重新建库;如果长度本身有意义,就保留内积,并重新制定阈值和离线评估基线。
| 检查对象 | 余弦方案 | 内积方案 |
|---|---|---|
| 向量输入 | 通常先做 L2 归一化 | 可保留原始长度 |
| 排序方向 | 相似度越大越靠前 | 最大内积越大越靠前 |
| 两者等价条件 | 查询向量和库内向量都为单位向量 | |
| 迁移动作 | 重新核对预处理、metric、分数含义和阈值 | |
常见问题
只把 query 归一化,库内向量不处理可以吗?
不建议。内积仍会受到库内向量长度影响,结果不能稳定地解释为余弦相似度。要么两侧都归一化,要么明确选择保留长度信息的内积语义。
余弦和内积分数一定完全相等吗?
只有在两侧向量都已经是单位向量时才有数学等价关系。近似索引、量化和浮点计算可能造成细小差异,但不应掩盖整体排序语义。
向量库配置为 Cosine 后还要自己归一化吗?
要看该向量库的实现契约。部分系统会在写入或搜索时内部归一化,部分系统不会。不要凭经验重复处理,先对照目标版本的官方文档确认输入和返回分数。
迁移后阈值应该直接沿用吗?
不要直接沿用。即便排序接近,返回值可能从距离变成相似度,或从负内积变成正向分数。应使用固定样本重新标定阈值,并记录分数方向。
延伸资料:https://qdrant.tech/documentation/migration-guidance/diagnosing-discrepancies/
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
324 收藏
-
346 收藏
-
139 收藏
-
318 收藏
-
科技周边 · 人工智能 | 36分钟前 | python · dataset Hugging Face Datasets DatasetDict save_to_disk load_from_disk 离线加载365 收藏
-
323 收藏
-
科技周边 · 人工智能 | 46分钟前 | 人工智能 · 深度学习 · PyTorch Accelerate mixed precision Accelerator accelerate launch370 收藏
-
397 收藏
-
451 收藏
-
科技周边 · 人工智能 | 51分钟前 | 人工智能 · 工具调用 · Transformers JSON Schema 工具调用 chat template apply_chat_template tool_calls495 收藏
-
科技周边 · 人工智能 | 53分钟前 | python · Hugging Face Datasets Dataset.filter with_indices input_columns load_from_cache_file num_proc225 收藏
-
134 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习