
AI 检索结果怎样记录来源片段而不是只存答案
来源:17golang原创
时间:2026-10-23 05:43:02 456浏览 收藏
AI 检索应用最容易留下一个“看起来能用、实际上无法追溯”的结果:数据库里只有最终答案,没有当时命中的来源片段。答案一旦被改写、来源页面一旦更新,团队就无法说明某句话依据了哪段材料。
更稳妥的做法是把一次回答拆成三层保存:答案文本、来源片段、支持关系。来源片段记录来源标识、片段标识和原文快照;支持关系记录回答中的哪一段对应哪些片段。这样既能展示引用,也能在后续复盘时还原当时的证据。
官方地址:https://ai.google.dev/gemini-api/docs/generate-content
不要把引用当成答案字符串里的几个 URL。引用是答案与检索证据之间的关系,至少要让来源、片段、位置和回答版本可以独立保存。
把答案与来源片段放进同一个记录
一个可长期保存的回答记录,建议把“用户问了什么”和“模型答了什么”与检索证据放在同一条主记录下,但不要把所有内容拼成一段字符串。最小字段可以这样划分:
answer_id:这次回答的稳定标识,不能用展示页面的临时 ID 代替。query:原始问题或经过脱敏后的问题快照。source_id、chunk_id:来源文档和来源片段的稳定标识。chunk_text:实际送入模型或被引用的片段文本,而不是只存标题。answer_text、supports:最终答案和它关联的片段范围。
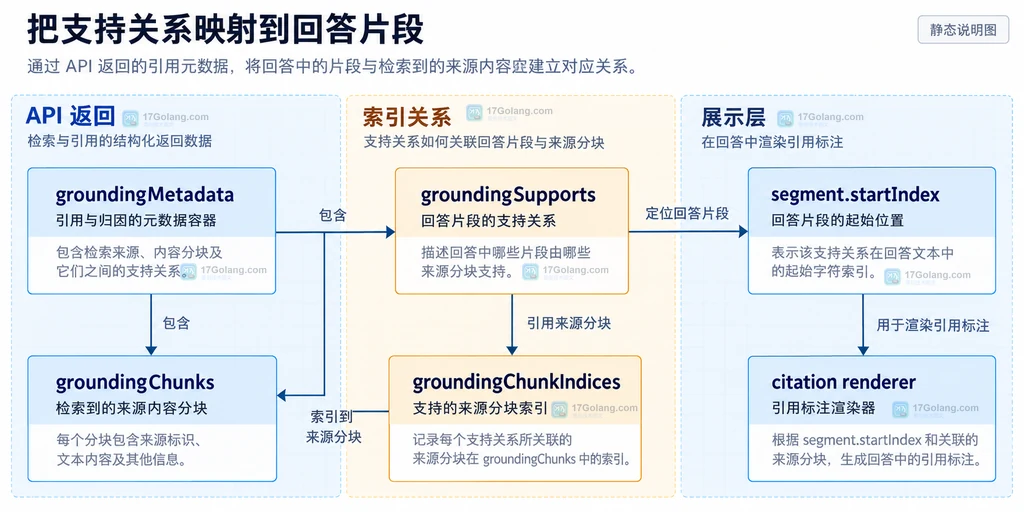
这里的关键不是字段数量,而是保留“片段原文”。只保存一个 URL,无法知道模型看到的是页面的哪一段;只保存答案,又无法区分模型自己的归纳和来源中的原句。
用 source_id 和 chunk_id 保存真正命中的片段
检索层最好返回结构化候选,而不是只返回一串上下文文本。下面的 Go 结构体是应用内部的最小模型,字段名可以按自己的存储系统调整:
package evidence

import "time"

// RetrievedChunk 保存模型实际可见的来源片段和检索位置。
type RetrievedChunk struct {
	SourceID    string            `json:"source_id"`
	ChunkID     string            `json:"chunk_id"`
	URI         string            `json:"uri"`
	Title       string            `json:"title"`
	Text        string            `json:"text"`
	Rank        int               `json:"rank"`
	Metadata    map[string]string `json:"metadata,omitempty"`
	RetrievedAt time.Time         `json:"retrieved_at"`
}

// CitationSupport 把回答中的字节范围关联到一个或多个来源片段。
type CitationSupport struct {
	Start            int      `json:"start"`
	End              int      `json:"end"`
	ChunkIDs         []string `json:"chunk_ids"`
	EvidenceSnapshot string   `json:"evidence_snapshot"`
}

// AnswerRecord 让答案和证据可以独立重放,不把引用信息埋在 HTML 字符串里。
type AnswerRecord struct {
	AnswerID string             `json:"answer_id"`
	Query    string             `json:"query"`
	Answer   string             `json:"answer"`
	Chunks   []RetrievedChunk   `json:"chunks"`
	Supports []CitationSupport  `json:"supports"`
}
evidence_snapshot 不是重复装饰。来源内容可能被重新切分或更新,保留当时用于生成回答的片段,才能让审计人员看到当时的依据。若原文涉及隐私,应在入库前做脱敏,并把原始权限交给独立的文档系统管理。
把支持关系映射到回答片段
如果使用 Gemini 的 grounding 能力,官方返回的结构里会区分来源数组和支持关系:groundingChunks 保存检索到的来源,groundingSupports 说明回答中的某个文本片段对应哪些来源索引。支持关系里常见的 segment.startIndex、endIndex 是回答文本中的范围,groundingChunkIndices 则指向来源数组的位置。
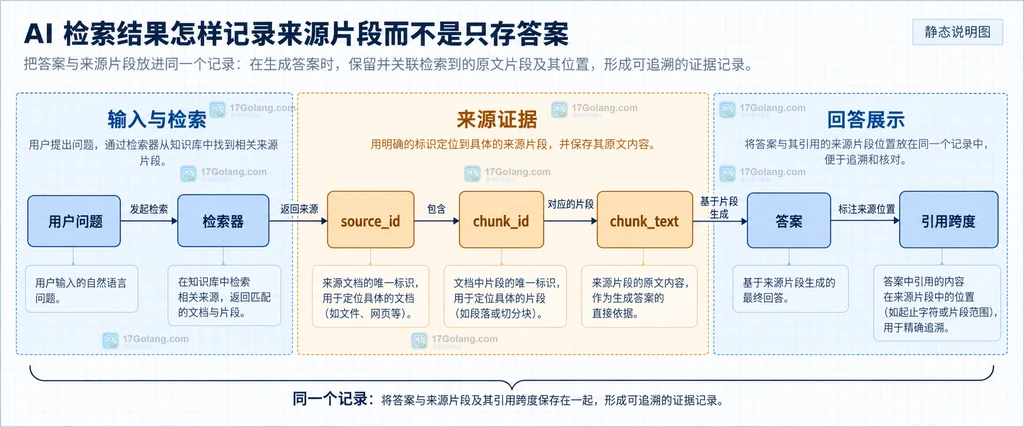
落库时不要只复制最终渲染后的 Markdown 链接。可以先把官方返回的索引关系转换成自己的 CitationSupport,再根据索引查出来源快照。这样前端换成脚注、悬浮卡片或“展开证据”面板时,不需要重新调用模型。
func normalizeSupports(answer string, raw []struct {
	Start     int
	End       int
	ChunkRefs []int
}, chunks []RetrievedChunk) []CitationSupport {
	result := make([]CitationSupport, 0, len(raw))
	for _, item := range raw {
		ids := make([]string, 0, len(item.ChunkRefs))
		for _, index := range item.ChunkRefs {
			// 越界索引不能静默变成错误引用,保留范围并跳过无效来源。
			if index = len(chunks) {
				continue
			}
			ids = append(ids, chunks[index].ChunkID)
		}
		if item.Start  len(answer) || len(ids) == 0 {
			// 没有合法来源的范围不进入可展示引用,避免制造“有据可查”的假象。
			continue
		}
		result = append(result, CitationSupport{
			Start:            item.Start,
			End:              item.End,
			ChunkIDs:         ids,
			EvidenceSnapshot: answer[item.Start:item.End],
		})
	}
	return result
}
示例中的范围按字节处理,是为了与接口字段保持一致;如果应用需要按用户可见字符定位,应在展示层明确转换规则,并在同一版本中固定文本编码和切片方法。不要把一个索引越界的支持关系强行渲染成引用。
来源更新时怎样保持引用可重放
来源片段不是永远不变的。对每条片段至少追加三类信息:
- 内容版本:记录文档版本、抓取时间或索引快照号,区分同一 URL 的不同内容。
- 内容摘要:对脱敏后的片段计算稳定哈希,用来判断重复命中和检测内容是否被替换。
- 检索上下文:记录排序名次、检索器版本和过滤条件,方便解释为什么它进入候选。
更新索引时不要覆盖旧片段后再让历史答案指向新内容。可以让 chunk_id 在版本变化时生成新值,历史回答继续引用旧快照;新回答则使用新版本。删除或过期的来源也只改变可见状态,不要抹掉已发布答案的证据记录。
如果来源系统提供自定义元数据,例如作者、页码、业务文档号或原始 URL,也应把这些字段放进片段元数据。Google 的文件检索文档说明,检索到的上下文可以携带自定义元数据,这正适合在引用卡片中展示“来自哪份文档、哪一页”。
常见问题
为什么只存 URL 不够?
URL 只说明入口,不说明模型看到的片段、命中顺序和回答中的对应位置。页面更新后,同一个 URL 可能已经无法复现原来的依据。
来源片段要不要全部原文保存?
至少保存实际送入模型的脱敏快照;对大文件可以保存片段正文、内容哈希和受控的原文引用。权限与隐私要求高时,不要把原始文件直接复制到回答库。
没有支持关系的回答能否展示引用?
可以展示“检索到的相关来源”,但不要把它标成支撑某句话的精确引用。精确引用必须有回答范围与来源片段之间的明确映射。
小结
AI 检索结果要可追溯,核心是保存三层数据:回答文本、来源片段、支持关系。source_id 和 chunk_id 负责定位证据,chunk_text 负责保留当时的内容,start/end 与来源索引负责把回答中的一句话映射回证据。再加上版本、时间和哈希,前端就能稳定展示引用,团队也能在来源变化后复盘历史答案。
技术依据:https://ai.google.dev/gemini-api/docs/generate-content;https://ai.google.dev/gemini-api/docs/generate-content/google-search;https://ai.google.dev/gemini-api/docs/generate-content/file-search
-
478 收藏
-
484 收藏
-
151 收藏
-
396 收藏
-
167 收藏
-
491 收藏
-
114 收藏
-
319 收藏
-
395 收藏
-
260 收藏
-
321 收藏
-
150 收藏
-
263 收藏
-
378 收藏
-
290 收藏
-
科技周边 · 人工智能 | 1小时前 | JSON · API · python · 人工智能 · 结构化输出 · 结构化输出 JSON Schema Gemini API response_schema response_mime_type additionalProperties145 收藏
-
467 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习