
人工智能技术文章
-
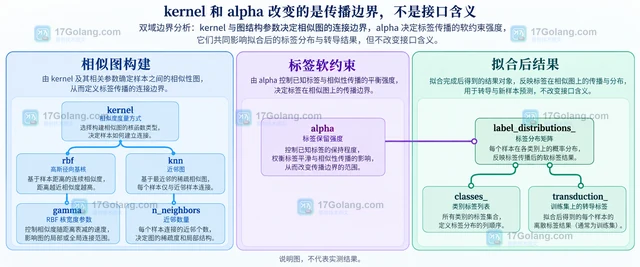 LabelSpreading 的 transduction_ 是 fit 阶段整张训练图上的传导标签,predict 与 predict_proba 则用于拟合后新样本的归纳式推断。本文按样本范围、接口、参数和上线检查清楚区分三者。467 收藏
-
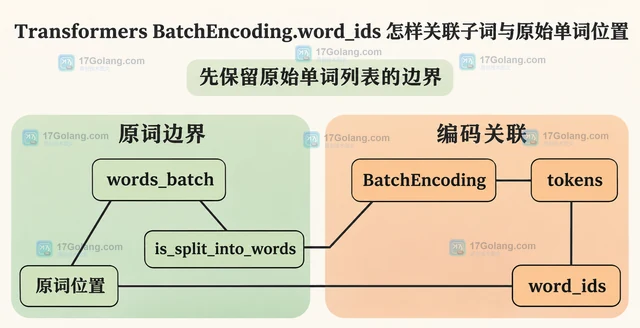 介绍 BatchEncoding.word_ids 如何把 token 关联到原词位置,提供 fast tokenizer 批次示例和首子词标签对齐写法,并解释 None、填充、截断与句对的限制。462 收藏
-
科技周边 · 人工智能 | 2星期前 | 异步任务 · 人工智能 · openai · 批处理文件 OpenAI Batch API output_file_id error_file_id output_expires_after
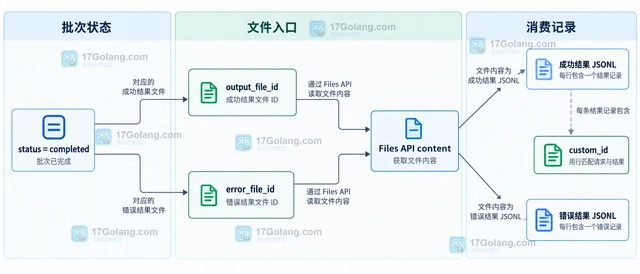 OpenAI Batch API 的 output_expires_after 怎样设置?本文说明 created_at 锚点、seconds 的合法范围,以及如何区分批次完成窗口、输出文件和错误文件的读取时机。460 收藏
-
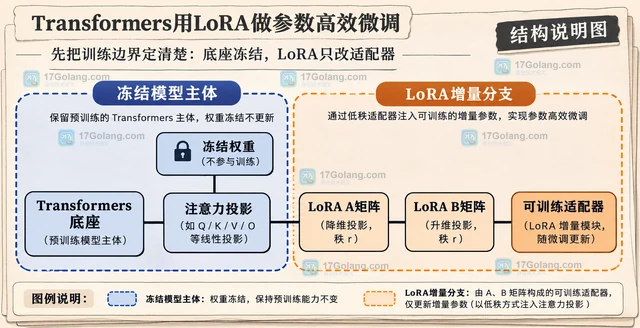 用 Transformers 与 PEFT 配置 LoRA:冻结预训练底座,只训练低秩适配器,并通过 Trainer 保存和恢复轻量检查点。460 收藏
-
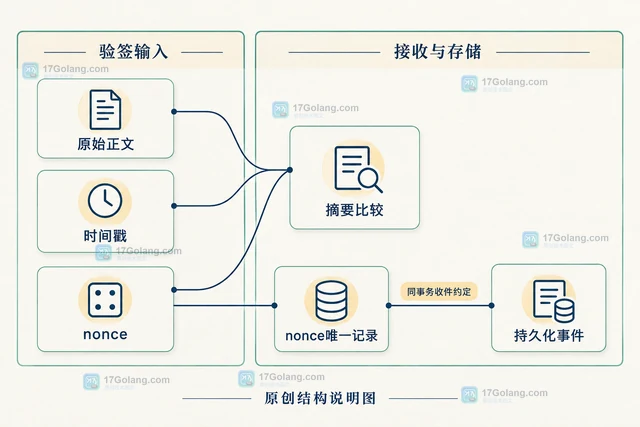 Label Studio 普通 webhook 可配置认证头,动态 HMAC 需另行实现。本文区分标注创建与任务完成,给出自建中继签名约定、原始正文校验及防重放与持久化边界。459 收藏
-
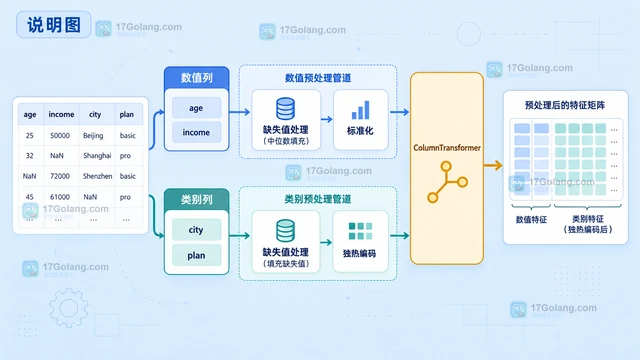 用 scikit-learn ColumnTransformer 把数值列与类别列分开处理:数值列填补并标准化,类别列填补并独热编码,再统一接入 Pipeline,避免列遗漏、未知类别和数据泄漏。459 收藏
-
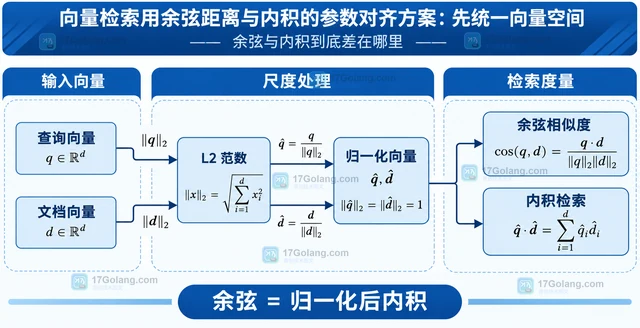 向量检索从余弦距离切换到内积时,关键不是只改 metric,而是确认查询向量和库内向量是否都做了 L2 归一化。本文用公式、Python 检查代码和迁移清单说明两种参数如何对齐,以及未归一化时为什么会改变排序。459 收藏
-
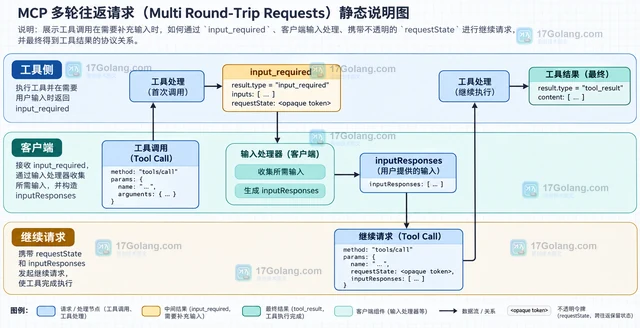 MCP 工具调用返回 input_required 时,如何保存不透明 requestState,处理 sampling、elicitation 或 roots 输入,并携带 inputResponses 重试原始调用。458 收藏
-
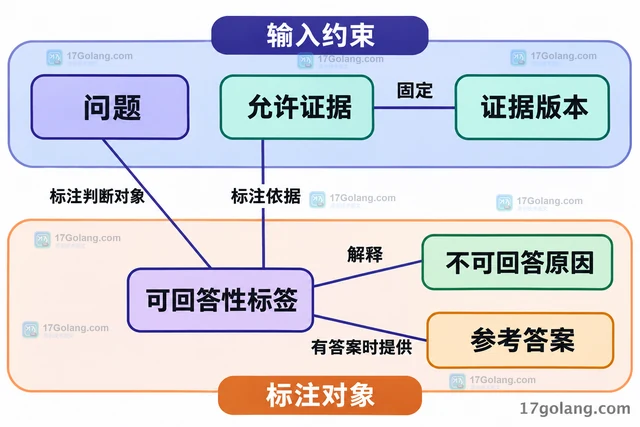 以允许证据定义不可回答标签,将正确拒答、错误拒答和无依据作答分开统计,说明拒答率与拒答精确率的分母、回答质量和拒答表达评分,以及版本比较的样本边界。457 收藏
-
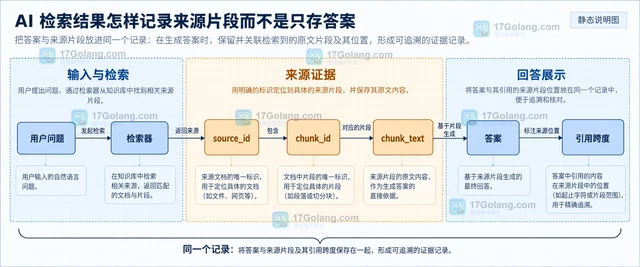 AI 应用不要只保存最终答案。本文用检索增强的常见数据模型说明如何保存 source_id、chunk_id、chunk_text、回答片段和支持关系,并结合 Gemini groundingMetadata 的 groundingChunks 与 groundingSupports 设计可追溯记录。456 收藏
-
 用 MLflow GenAI 把真实 trace 中的已知失败行为固化为 pytest 回归测试,配置 @mlflow.test,组合 scorer,并用 result.passed 与 result.reason 接入 CI 断言。456 收藏
-
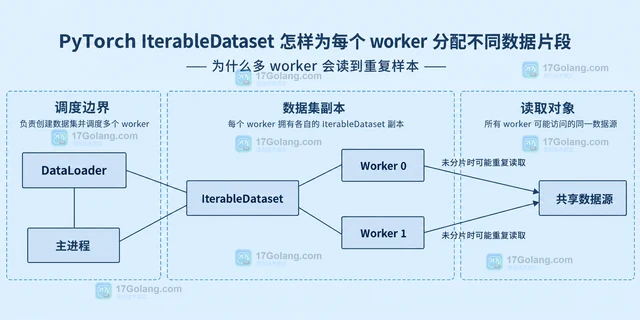 使用 PyTorch IterableDataset 配合 DataLoader 多 worker 时,数据集对象会复制到各个进程,直接迭代容易读到重复样本。本文用 get_worker_info 在 __iter__ 中计算半开区间,说明不整除、尾部数据和 drop_last 的边界。455 收藏
-
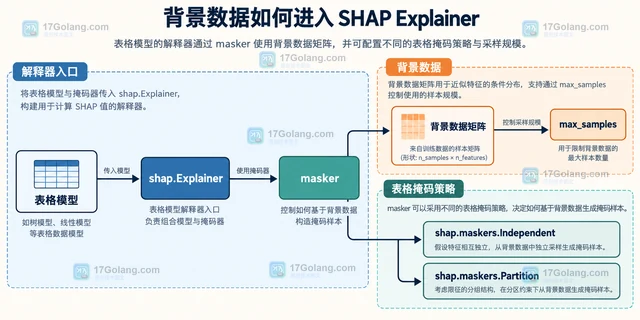 SHAP Explainer 可以用 NumPy 数组或 pandas DataFrame 作为表格背景数据。本文比较 Independent 与 Partition 的遮罩假设,说明 max_samples、特征相关性和字段一致性如何影响解释基线,并给出可直接改造的初始化代码。455 收藏
-
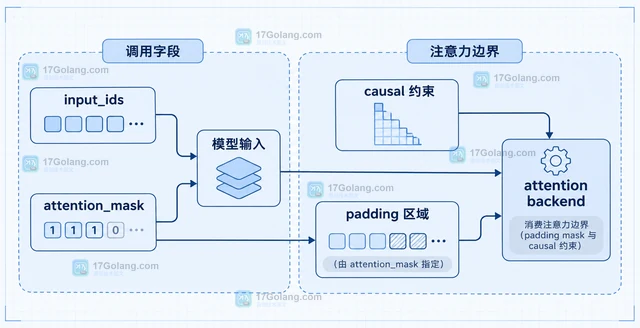 解释 Transformers 中 attention_mask 缺失的影响,区分单条输入、批量 padding、因果 mask 和 decoder mask,并给出 tokenizer 自动生成与检查掩码的实用示例。453 收藏
-
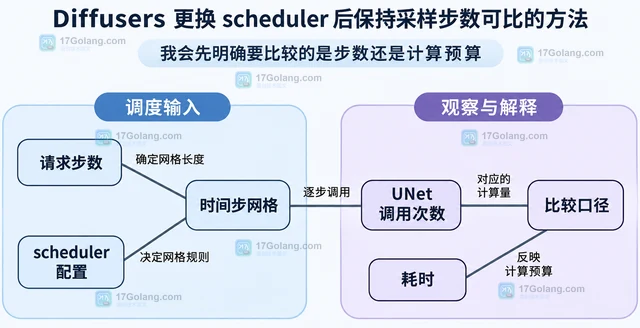 说明 Diffusers 更换 scheduler 时如何区分请求步数、时间步网格和实际网络调用,给出配置继承、独立随机生成器及 UNet 调用记录示例,建立同预算比较方法。451 收藏