
人工智能技术文章
-
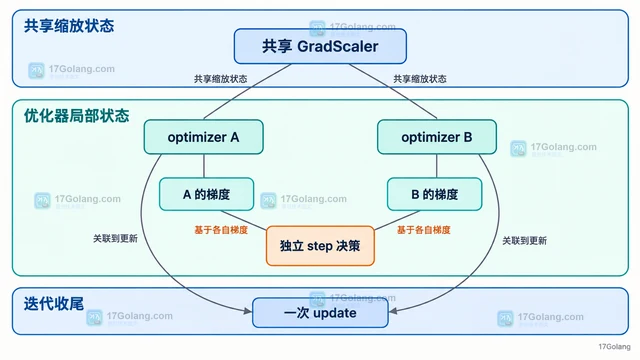 GradScaler 会在反缩放后的梯度含 inf 或 NaN 时跳过对应优化器的 step。本文说明单优化器、多优化器、scale 回退与学习率调度器的判断边界。268 收藏
-
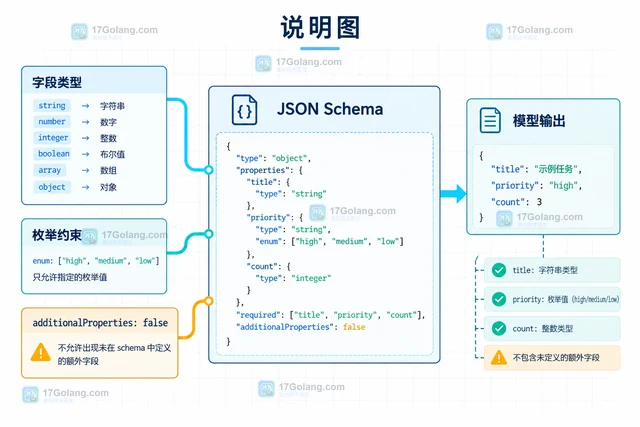 OpenAI API 需要固定输出格式时,应优先使用 Structured Outputs,在 Responses API 的 text.format 中声明 JSON Schema,并处理拒答、截断和旧版参数迁移边界。268 收藏
-
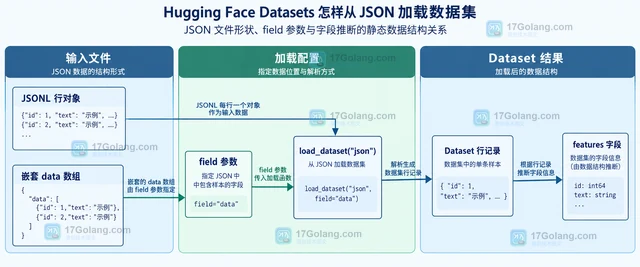 Hugging Face Datasets 读取 JSON 的关键是先判断根结构:JSONL 通常直接加载,嵌套数组要用 field 指向数据字段;多个文件则用 data_files 映射到 train、validation 等 split。本文给出最小写法、字段推断观察方式和常见排错边界。266 收藏
-
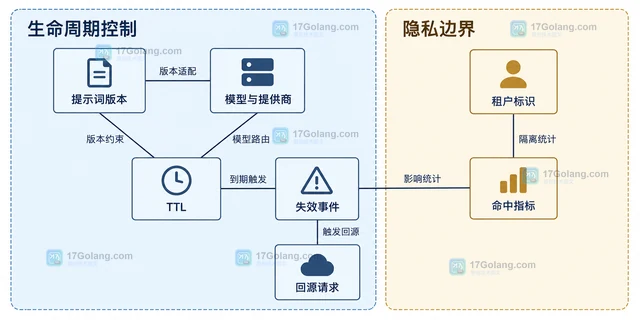 围绕稳定前缀、动态变量、失效策略和租户隔离,说明提示词缓存怎样减少重复上下文开销,以及缓存未命中时如何分层排查。263 收藏
-
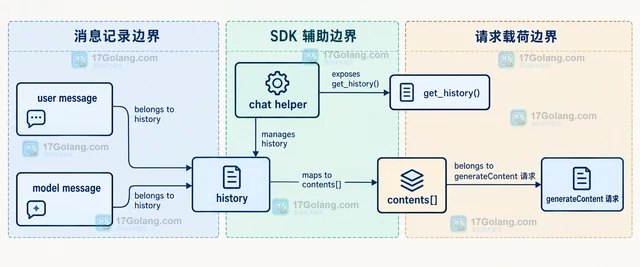 Gemini API 多轮对话不能只发送当前问题:新项目可保存 interaction_id 续接服务端状态,generateContent 则要维护并重新提交 contents 历史。263 收藏
-
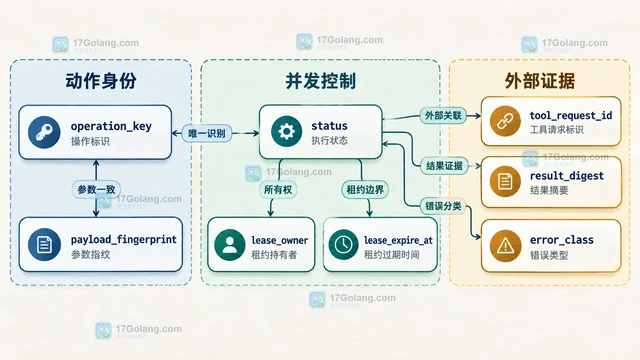 工具调用型智能体会因超时、重试、工作流回放和多副本竞争重复触发有副作用的动作。本文给出稳定动作键、参数指纹、动作账本、租约、结果复用与外部幂等键的完整设计,并说明未知结果、补偿和监控边界。262 收藏
-
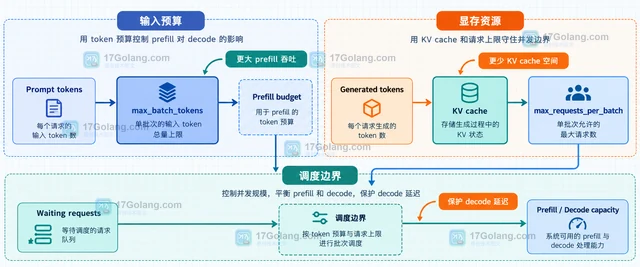 连续批处理会同时影响推理吞吐与首 token 延迟。本文从 TTFT 分解、prefill token 预算、KV cache、调度策略和分位数指标入手,说明怎样按负载逐步调参。262 收藏
-
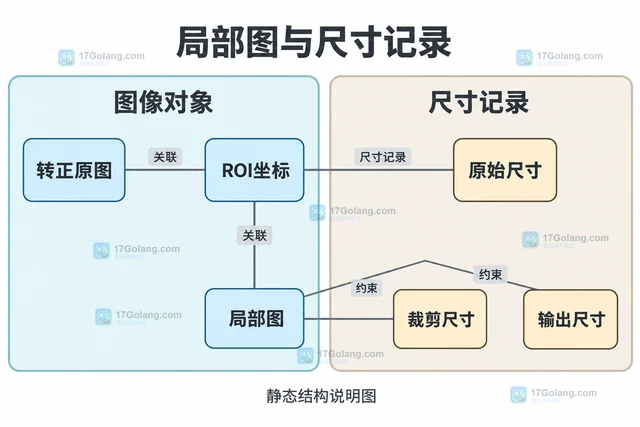 视觉模型图片预处理需兼顾长宽比、裁剪范围和细节保留。本文用Pillow函数示例说明转正、只缩不放大与ROI尺寸记录,并区分业务图片准备和模型processor要求。261 收藏
-
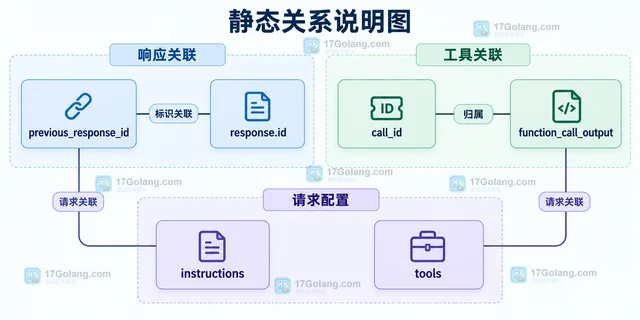 OpenAI Responses API 迁移旧工具调用代码,需要调整工具声明、输出项解析与 call_id 结果回传。本文以只读查询示例解释响应链续接、严格参数和失败出口。260 收藏
-
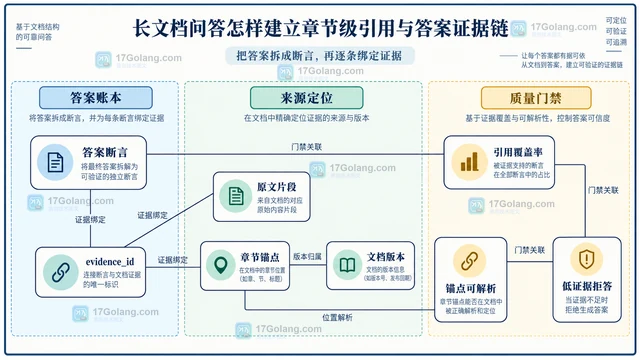 长文档问答不能只返回文件名。本文给出文档版本、章节锚点、内容块、引用卡片和答案断言的完整映射方法,并补充覆盖率、锚点解析、版本一致性、低证据拒答与回滚检查。257 收藏
-
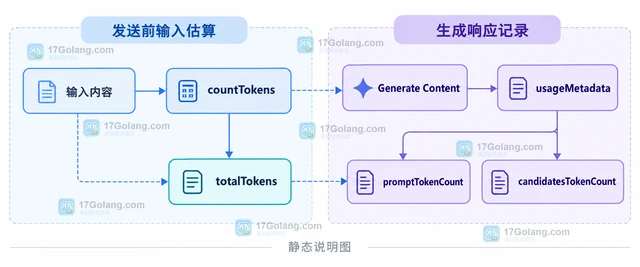 Gemini API 的 countTokens 只用于发送前估算输入规模,生成响应中的 usage metadata 才记录本次请求的实际输入、输出、缓存、工具调用与思考 token。本文用 Python 区分两类数字及其使用场景。254 收藏
-
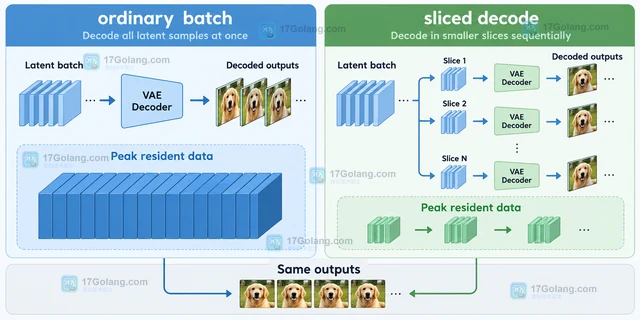 本文围绕 Diffusers enable_vae_slicing,说明多图 VAE 解码的显存峰值来源、管线级启用方式、受控测量方法和速度与显存之间的取舍。252 收藏
-
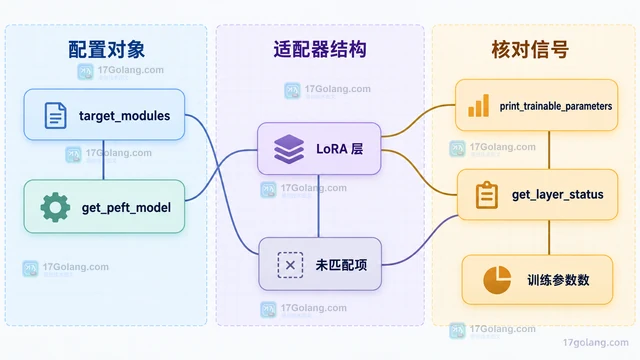 说明 PEFT LoRA 的 target_modules 如何按模型模块树、任务范围和参数预算选择,并给出默认目标、all-linear、MoE 特例与命中检查方法。251 收藏
-
科技周边 · 人工智能 | 3星期前 | JSON · python · 人工智能 · 工程实践 · 结构化输出 · Pydantic JSON Schema AI 结构化输出 模型重试 兜底解析 大模型工程
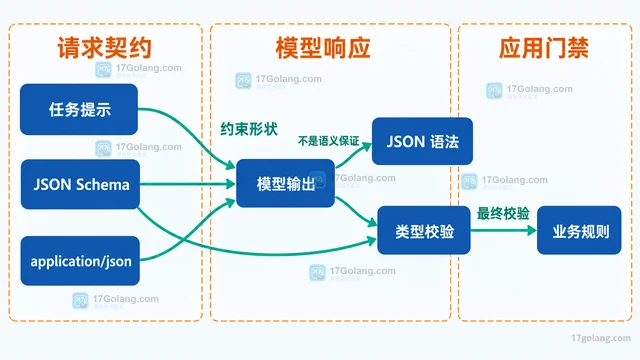 模型稳定输出 JSON 不能只靠提示词。本文用 JSON Schema、Pydantic 校验、分类重试与受控兜底解析,搭建一条可观测的结构化输出链路。250 收藏
-
科技周边 · 人工智能 | 2星期前 | 人工智能 · 深度学习 · Keras RaggedTensor keras.Input ragged=True TensorFlow backend 模型保存 load_model 变长序列
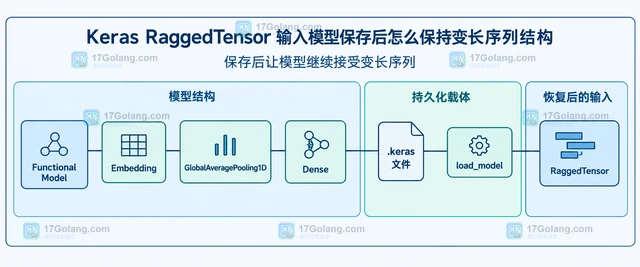 Keras RaggedTensor 输入要把 TensorFlow backend、Input(ragged=True) 和调用时的 RaggedTensor 视为同一个契约。本文用一个最小变长序列模型演示如何保存为 .keras 并重新加载,解释动态长度、保存结构和多后端边界。250 收藏