
人工智能技术文章
-
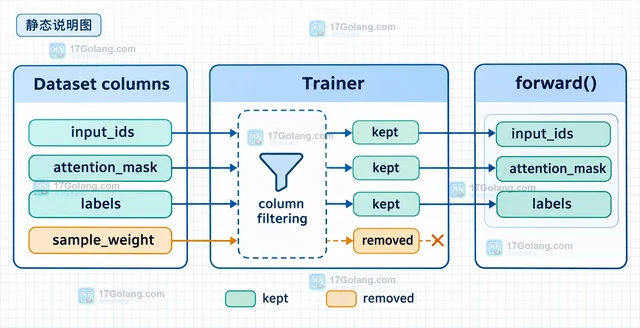 Transformers Trainer 默认会移除模型 forward 未声明的数据集列。本文用 sample_weight 说明如何配置 remove_unused_columns 和 forward 参数,让自定义字段继续传入模型。344 收藏
-
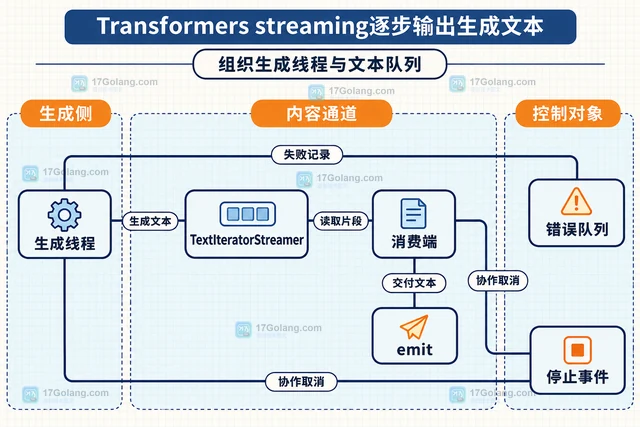 Transformers用TextIteratorStreamer将生成与文本消费分开,实现逐步输出。本文提供单请求原创函数,说明队列超时、协作取消、后台异常回传和完成事件,并给出服务接入的观察指标。340 收藏
-
科技周边 · 人工智能 | 4星期前 | python · 人工智能 · 结构化输出 · AI Hugging Face 结构化输出 JSON Schema TGI Inference Providers grammar response_format
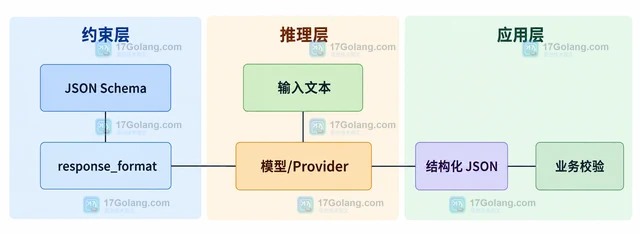 AI JSON Schema 约束输出时,应把 Schema 作为 response_format 或 TGI grammar 的协议参数,并按解析、业务校验和下游处理的生命周期区分格式正确与答案正确。339 收藏
-
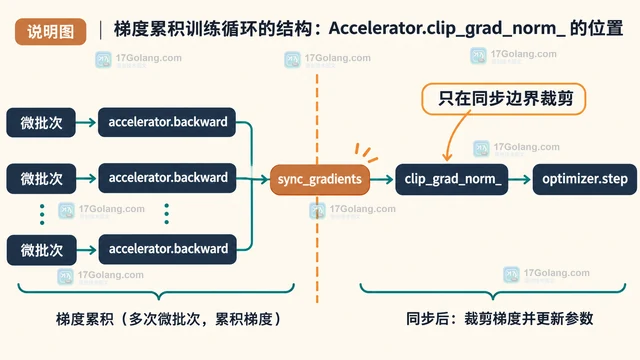 在 Accelerate 的梯度累积和混合精度训练中,使用 Accelerator.clip_grad_norm_ 统一裁剪模型梯度;本文说明调用时机、参数含义、返回值和与 sync_gradients 的配合方式。339 收藏
-
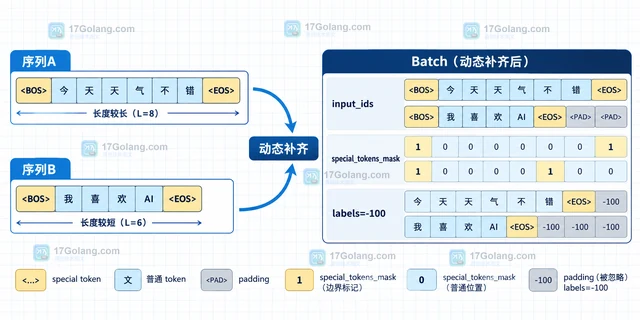 用 DataCollatorForLanguageModeling 组织语言模型训练批次,掌握 mlm、mlm_probability、padding 与 labels=-100 的对应关系。336 收藏
-
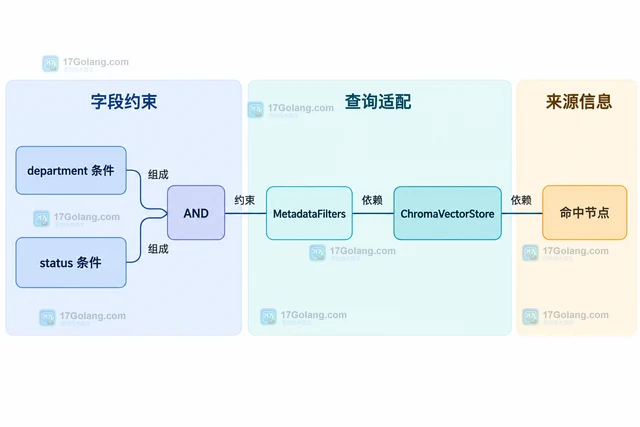 以 Chroma 为例,把节点 metadata 与 MetadataFilters 对应起来,演示等值 AND 过滤、模拟嵌入检索和临时集合清理,并解释字段类型、top-k、空结果及后端支持范围。334 收藏
-
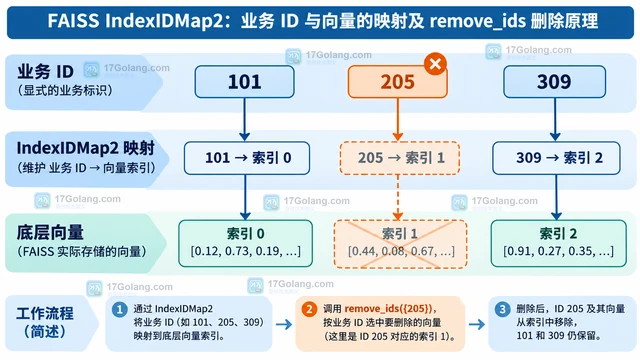 FAISS IndexIDMap2 适合把业务 ID 与向量绑定后再维护索引。本文用 Python 说明怎样写入自定义 ID、按 ID 批量删除、读取删除数量,并解释删除后其他 ID 为什么不会像顺序位置那样整体前移。334 收藏
-
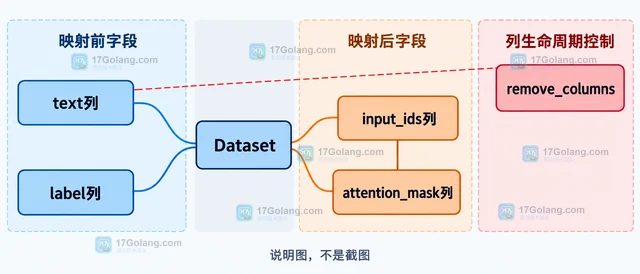 Hugging Face Datasets 的 map 在 batched=True 时按列传入一批样本。本文用一个可复用的 Python 示例说明怎样新增处理列、保留原始列,并用 remove_columns 控制最终字段。329 收藏
-
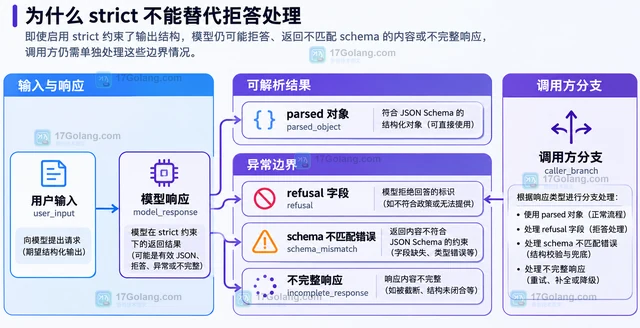 Structured Outputs 解决的不是“返回一段看起来像 JSON”,而是让模型输出尽量贴合调用方定义的 JSON Schema。本文用 schema、strict=true 和 refusal 三个边界,整理 Responses API 与 Chat Completions API 的写法、适用条件和常见误区。328 收藏
-
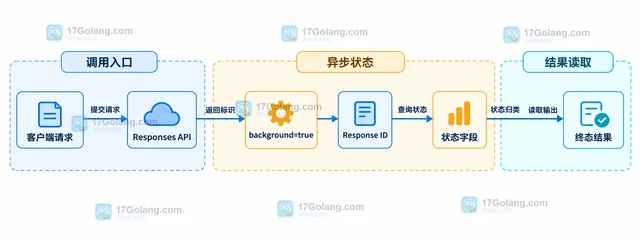 OpenAI Responses API 的 background 模式可以让长耗时任务异步运行。本文用一个可复用的轮询骨架说明如何保存 response_id、区分处理中与终态,并比较取消、流式恢复和数据保留的取舍。327 收藏
-
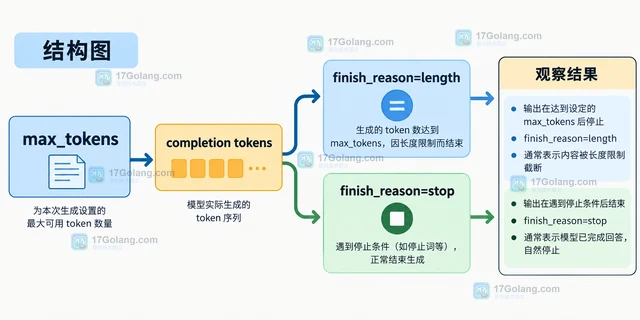 讲清 vLLM 在线服务中请求级 max_tokens 的设置位置、上下文边界与 finish_reason 判断方法,帮助按业务预算控制输出长度。326 收藏
-
 StoppingCriteriaList 是 Transformers 生成过程中的停止条件容器。本文用长度、时间和自定义条件说明如何组合它们,并解释按 batch 样本合并布尔结果、scores 依赖和 max_length 冲突。325 收藏
-
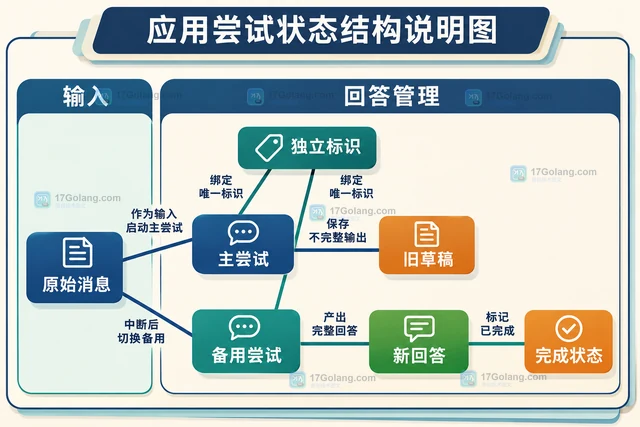 解释 LiteLLM Chat Completions 流已输出内容后的异常行为,给出应用层备用生成与 attempt 隔离写法,避免把重新生成误当成断点续传。325 收藏
-
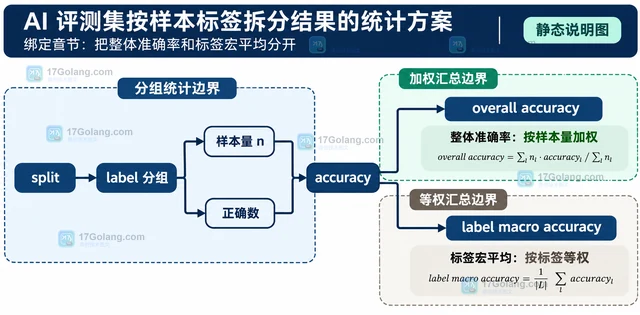 围绕 AI 评测集的样本标签拆分,给出从行式结果、分组计数到整体准确率与标签宏平均的可复算统计方案,并说明小样本、缺失标签和重复样本的处理边界。324 收藏
-
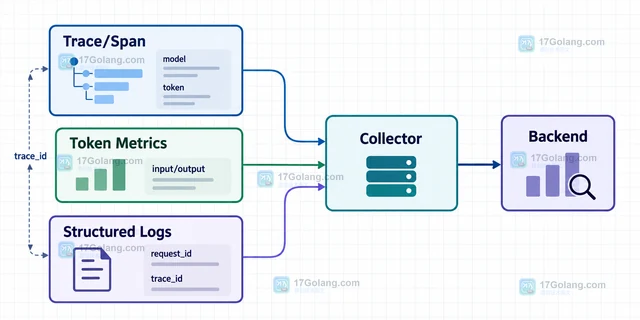 用 OpenTelemetry 的 trace、metric 和结构化日志记录 AI 应用的 token 用量与请求追踪信息,并比较日志、Collector 和厂商 SDK 的适用边界。323 收藏