
人工智能技术文章
-
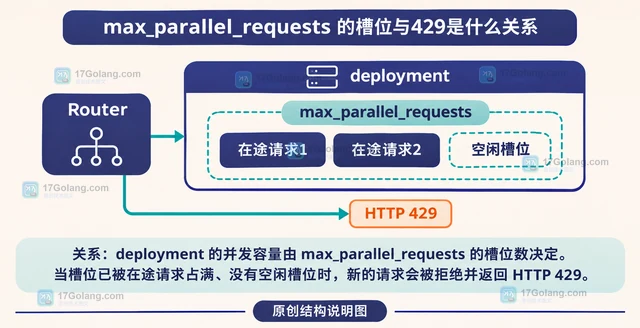 LiteLLM 的 max_parallel_requests 是部署级并发槽位上限,槽位全部占用时会在供应商调用前直接返回429。本文按配置优先级、进程边界和排查路径说明如何处理。384 收藏
-
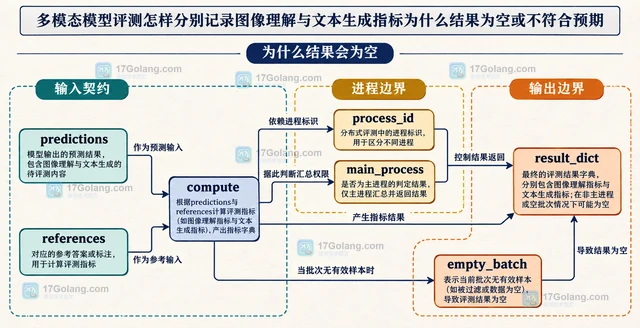 多模态模型评测不要把图像理解和文本生成塞进同一个指标调用。本文用统一样本记录、分离指标计算和结果命名空间,说明如何分别保存图像理解与文本生成指标,并从空数据、字段契约、分布式主进程和指标依赖四层排查结果为空或不符合预期。383 收藏
-
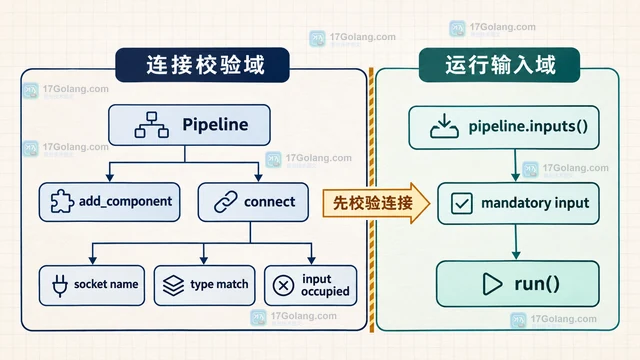 Haystack Pipeline 在 connect() 阶段发现组件连接类型不匹配时,按 socket 名称、多输出选择、类型适配和输入占用四层排查,并用最小转换组件修复。383 收藏
-
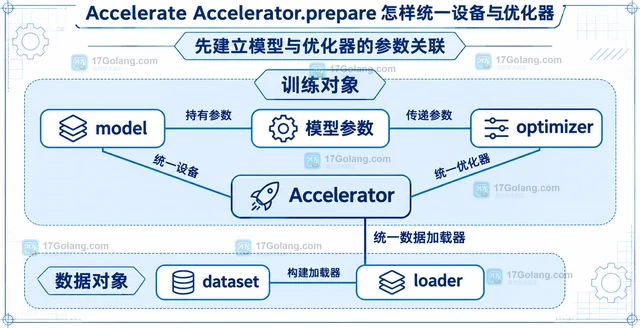 说明 Accelerate Accelerator.prepare 如何一起准备模型、优化器和数据加载器,给出普通训练循环迁移示例,澄清返回值顺序、设备放置、反向入口与分布式启动的责任。382 收藏
-
科技周边 · 人工智能 | 4星期前 | python · 人工智能 · AI 文本分类 pipeline padding Transformers 批量推理 truncation batch_size
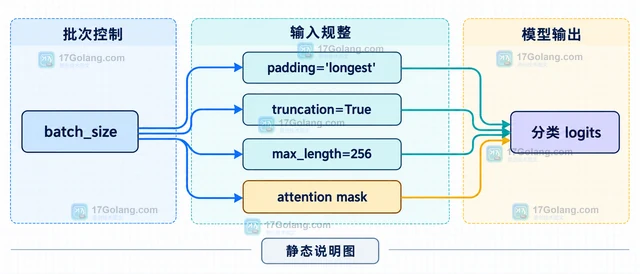 用 Transformers 文本分类 Pipeline 处理批量文本时,分别说明列表、数据集和生成器的入口,padding、truncation、max_length 与 batch_size 的边界,并给出带稳定 ID 的 Python 示例。379 收藏
-
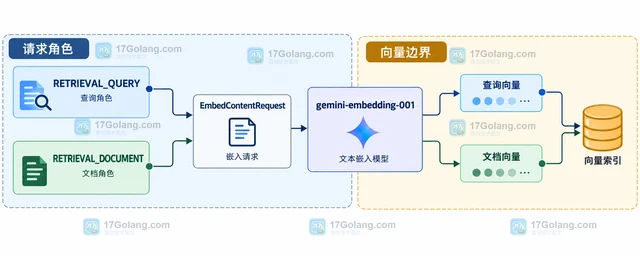 Gemini embeddings 的对称与非对称任务不能混用。本文结合 gemini-embedding-2 的文本任务前缀和 gemini-embedding-001 的 TaskType,说明搜索、语义相似度与向量索引迁移时如何保持查询和文档角色一致。378 收藏
-
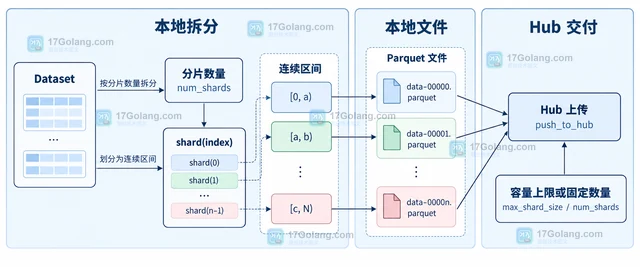 Hugging Face Datasets 里,to_parquet 的 batch_size 主要控制写入批次与内存,不等于输出文件数量;本地固定文件数要用 Dataset.shard,上传 Hub 则可用 max_shard_size 或 num_shards。378 收藏
-
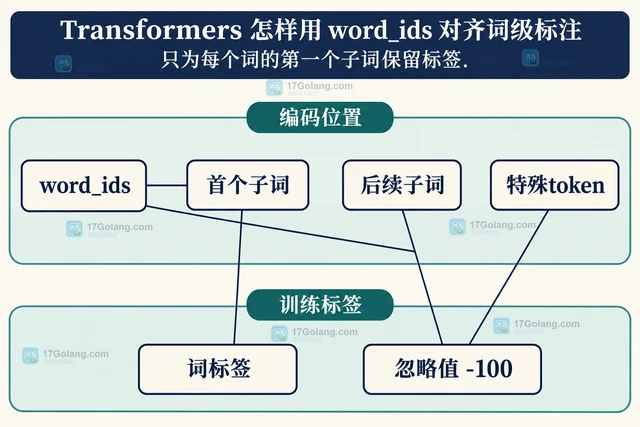 Transformers word_ids 将 token 映射到原始词索引。本文给出 Fast tokenizer 批量词级标注示例,说明首子词监督、特殊位置忽略、截断及标签补齐的处理。378 收藏
-
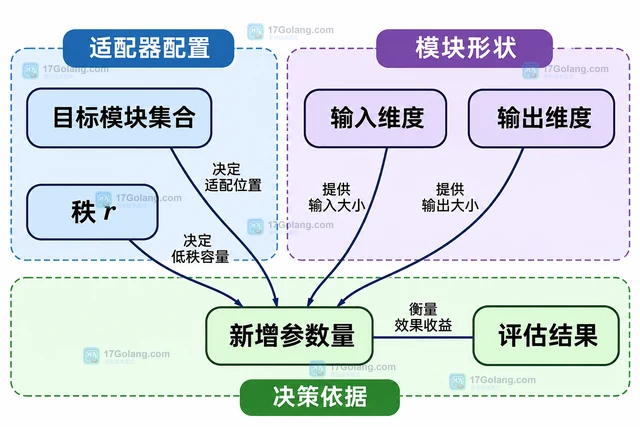 从模型真实模块名称出发,比较窄范围注意力投影与 all-linear 的适用条件,说明 LoRA 最小配置、参数预算及融合投影、MoE 等特殊结构的选择边界。378 收藏
-
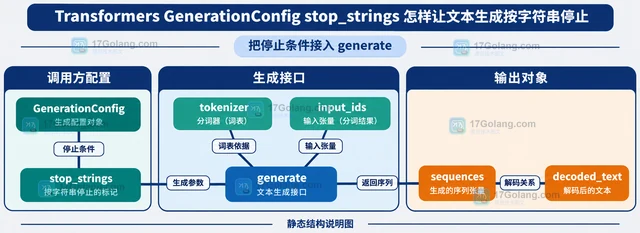 Transformers 文本生成需要在指定字符串出现后停止时,不能只写 stop_strings;还要把同一个 tokenizer 传给 generate,并区分 prompt、新生成 token 和最终展示文本。本文给出配置、批量输入和边界处理的完整写法。375 收藏
-
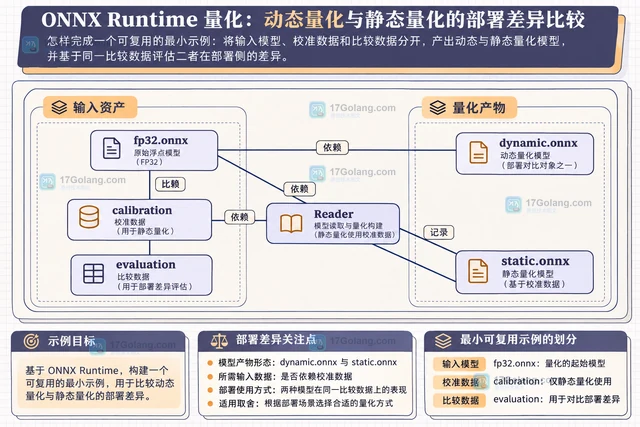 用自造 MatMul 模型演示 ONNX Runtime 动态与静态量化,分列产物大小、输出误差和热推理延迟,并说明校准数据、目标硬件、记录与回退的部署边界。374 收藏
-
科技周边 · 人工智能 | 4星期前 | python · 数据处理 · 人工智能 · AI Hugging Face Datasets select_columns remove_columns DatasetDict 数据集字段
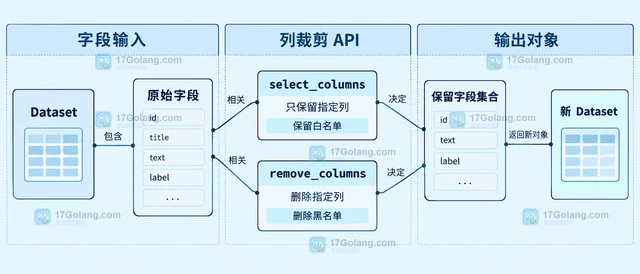 Hugging Face Datasets 按列处理时,先区分 select_columns 与 remove_columns,再确认 Dataset 和 DatasetDict 的作用范围,并说明 map 转换、缺列检查和新对象赋值的常见误区。373 收藏
-
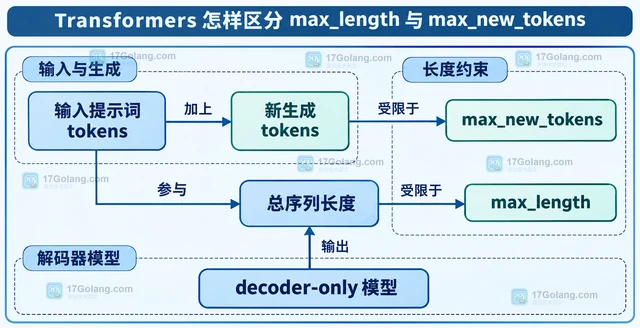 Transformers 的 max_length 控制序列总长度,而 max_new_tokens 只控制本次新增 token 数。本文用 decoder-only 与 encoder-decoder 两类场景说明怎样选择参数,避免提示词变长后输出预算失控。373 收藏
-
 ONNX Runtime 通过 SessionOptions 的图优化级别和 optimized_model_filepath 在创建推理会话时保存优化后的模型。本文说明 Python 写法、ONNX 与 ORT 格式边界,以及文件未生成时的排查方向。372 收藏
-
 ONNX Runtime 的执行提供者应结合硬件、依赖、算子覆盖与模型形状选择。本文说明 CUDA、TensorRT、OpenVINO、DirectML 和 CoreML 的候选范围,提供注册顺序与性能比较示例,区分可用、注册和实际分配。371 收藏