-
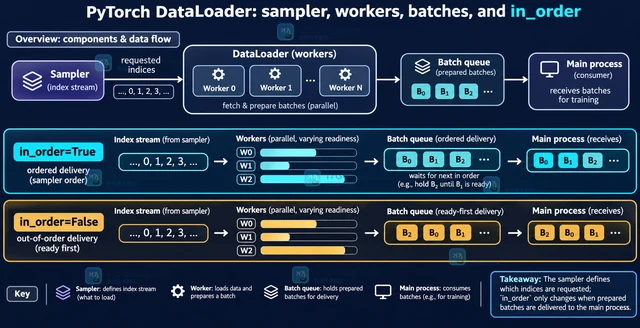
PyTorch DataLoader 的 in_order=False 改变的是多进程 batch 的交付顺序,不是简单改写 sampler。本文解释加载耗时如何与返回顺序产生关联,并给出训练、验证和数据审计的选择与对照排障方法。
-
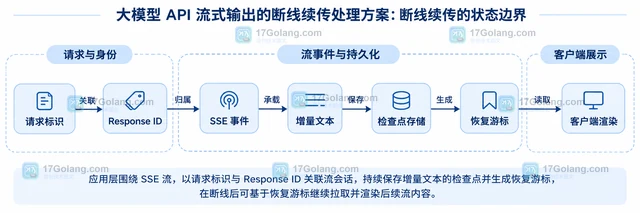
大模型 API 的 stream=true 通常通过 SSE 发送增量事件,但客户端重连并不等于上游模型自动续流。本文用服务端检查点、游标重放和幂等任务记录,设计一套可控的断线恢复方案,并说明不能直接拼接两次生成结果的边界。
-
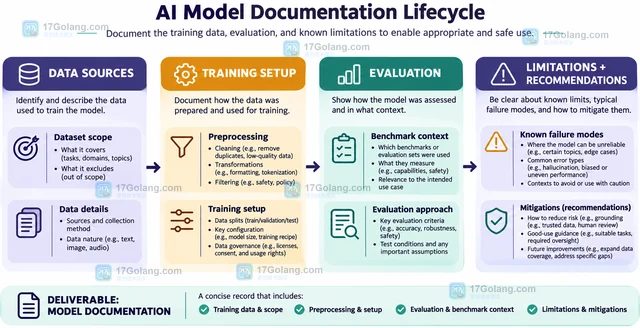
模型卡不只是模型简介,而是把用途、训练数据、训练过程、评估结果和已知限制放在同一份可维护文档中。本文以 Hugging Face Hub 的 README.md 模型卡为例,说明 YAML 元数据与正文怎样分工,以及未知信息如何如实标记。
-

Captum IntegratedGradients 返回的 convergence delta 是完整性差值的逐样本近似误差信号。本文说明它比较什么、如何读取,以及怎样结合 n_steps 和 method 做有边界的判断。
-
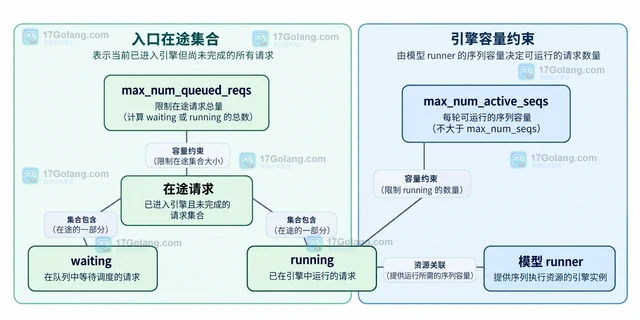
区分 vLLM 连续批处理的序列容量、token 预算、活跃请求和入口在途限制,给出配置示例、版本条件以及排队和多副本的适用边界。
-
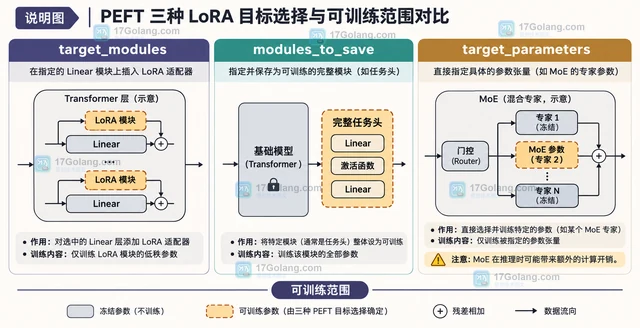
用 target_modules 选择 LoRA 插入位置,用 modules_to_save 保留需要完整训练的模块,并用 target_parameters 处理 MoE 参数级目标;最后通过参数统计清点实际训练范围。
-
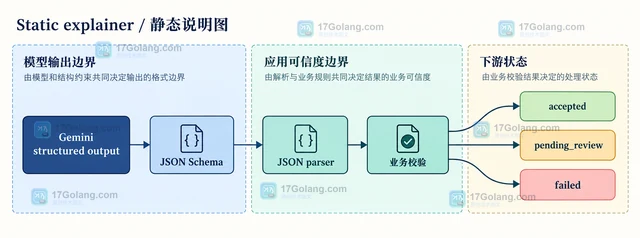
AI 结构化输出并不等于业务数据已经可信。本文用 Gemini API 演示如何区分接口失败、JSON 解析失败和语义校验失败,并把不可用结果安全降级到待审核流程。
-
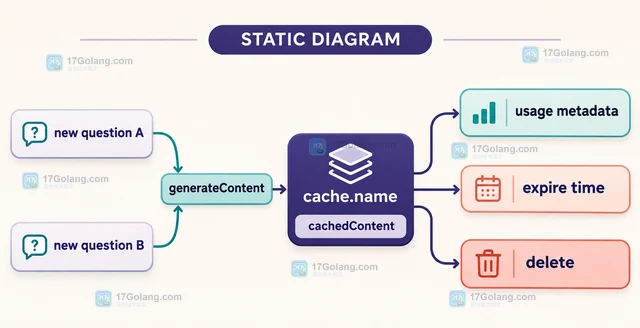
Gemini API 复用长文档的关键是创建显式 context cache,后续请求只发送新问题并引用 cachedContent。本文用 Python 示例说明 Files API、TTL、模型绑定、usage metadata 与文档版本切换。
-
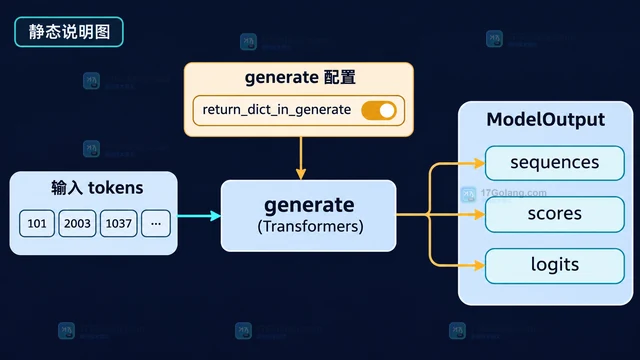
Transformers generate 的 output_scores 与 output_logits 都保存生成步分数,但前者是经过生成处理的 scores,后者更接近未处理的模型 logits。本文说明返回开关、数据结构和实际选择方法。
-

JiWER 不只返回 WER 数字,还能通过 process_words 得到逐句的 AlignmentChunk 对齐对象。本文说明 WordOutput.alignments 的结构、四类词位操作、四个索引字段,以及如何用 visualize_alignment 输出可读的对齐文本。
-
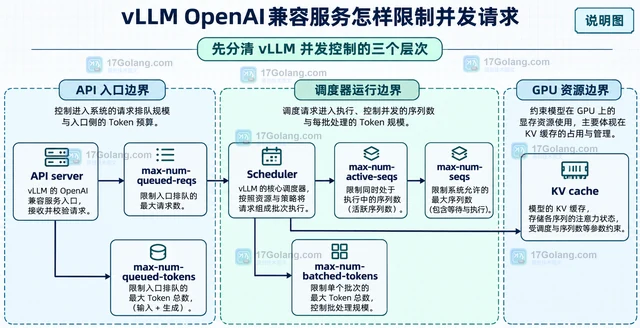
vLLM OpenAI 兼容服务的并发限制要分三层:入口请求队列、运行态序列数和 token 预算。本文给出启动参数组合、503 边界与客户端退避思路。
-
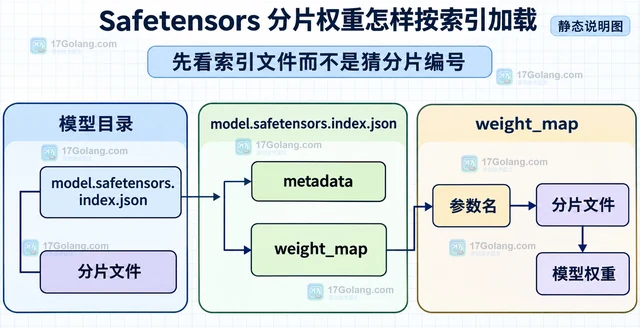
Safetensors 分片模型的关键不是按文件名猜顺序,而是读取 model.safetensors.index.json 的 weight_map。本文给出 Transformers 自动加载和 safe_open 按索引读取两种做法,并说明缺片、键名不匹配与内存取舍。
-
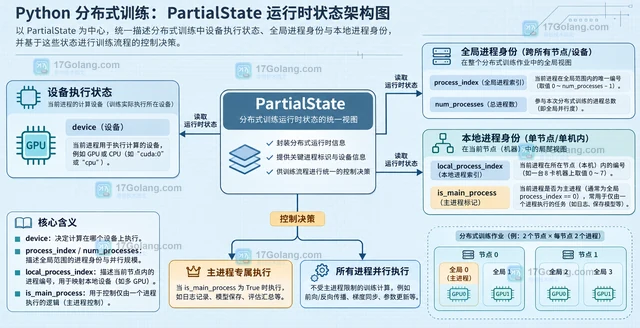
只需要读取分布式脚本的当前设备、全局进程编号、本机进程编号和进程总数时,可以直接使用 Hugging Face Accelerate 的 PartialState。本文用一个最小示例拆开四个属性的区别,并说明主进程输出与多机逻辑的写法。
-
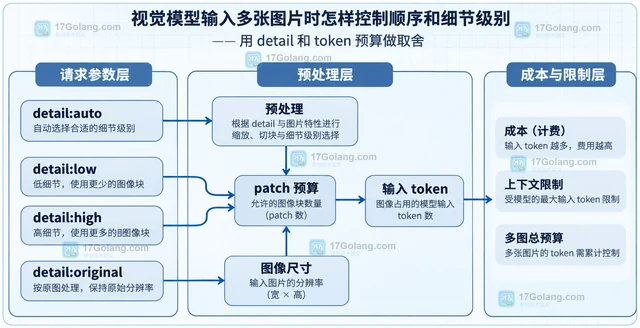
多张图片一起交给视觉模型时,稳定的图片顺序和合理的 detail 比盲目提高分辨率更重要。本文用一个多图分析请求说明 content 数组的语义组织、low/high/original 的选择,以及尺寸、patch 与输入 token 预算之间的关系。
-
Captum Saliency 对多分类输出需指定归因目标。本文用线性三分类模型演示统一类别与逐样本 target,说明梯度形状、abs 参数及真实模型接入条件。
