
人工智能技术文章
-
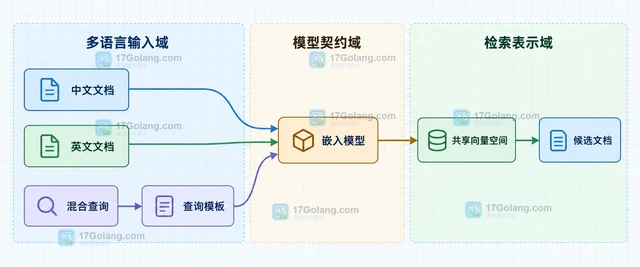 多语言文档混合检索的关键不是盲目更换模型,而是让文档和查询进入同一向量空间,并统一查询模板、输入长度、归一化与相似度计算。本文结合 BGE-M3 和 multilingual-e5-large-instruct 的官方规则,给出跨语言召回与排序漂移的排查清单。381 收藏
-
科技周边 · 人工智能 | 6天前 | python · 人工智能 · AI 文本分类 pipeline padding Transformers 批量推理 truncation batch_size
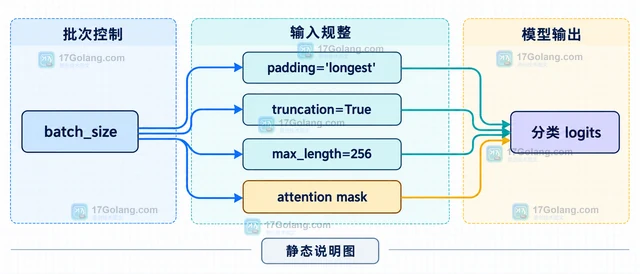 用 Transformers 文本分类 Pipeline 处理批量文本时,分别说明列表、数据集和生成器的入口,padding、truncation、max_length 与 batch_size 的边界,并给出带稳定 ID 的 Python 示例。379 收藏
-
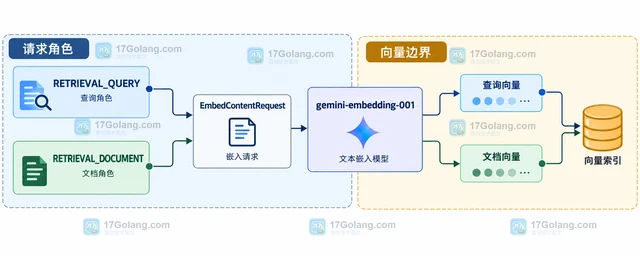 Gemini embeddings 的对称与非对称任务不能混用。本文结合 gemini-embedding-2 的文本任务前缀和 gemini-embedding-001 的 TaskType,说明搜索、语义相似度与向量索引迁移时如何保持查询和文档角色一致。378 收藏
-
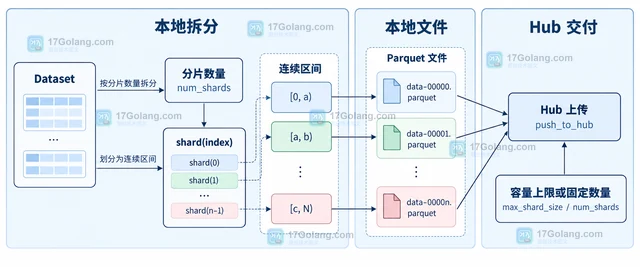 Hugging Face Datasets 里,to_parquet 的 batch_size 主要控制写入批次与内存,不等于输出文件数量;本地固定文件数要用 Dataset.shard,上传 Hub 则可用 max_shard_size 或 num_shards。378 收藏
-
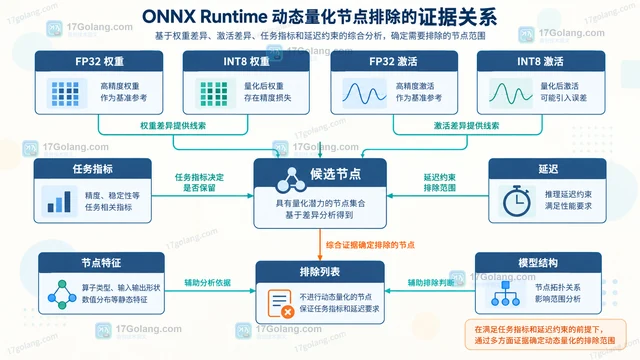 ONNX Runtime 动态量化中的 nodes_to_exclude 应按节点名称精确控制。本文给出节点清单、全量量化基线、差异定位、逐组复测和配置冻结的方法。377 收藏
-
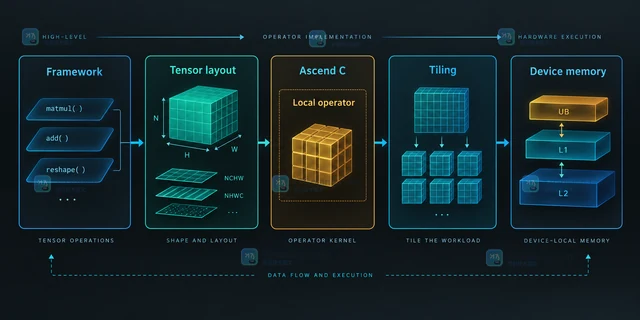 在 DeepSeek 相关 Ascend NPU 项目中,算子负责单卡计算,HCCL/HCOMM 负责跨卡通信,框架后端负责编排。本文按职责边界拆解 Ascend C、通信原语、MoE dispatch/combine 与多卡排查顺序。375 收藏
-
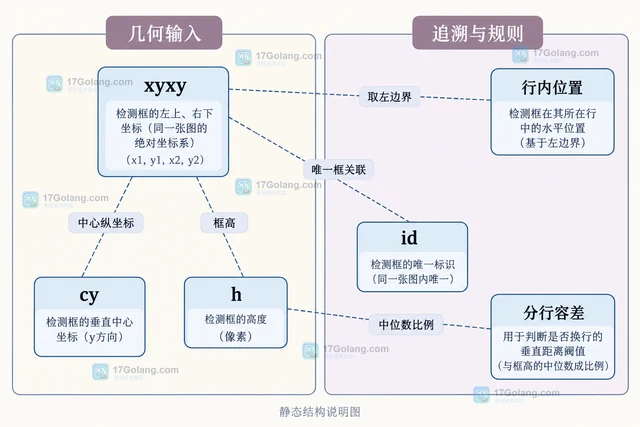 面向单栏横排文本,统一检测框坐标,以固定行锚点分行并在行内按横坐标排序。提供 Python 示例,说明坐标抖动、稳定 ID、多栏与复杂版面的适用边界。375 收藏
-
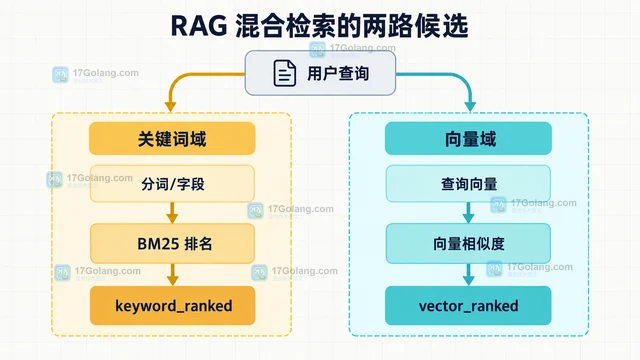 从零实现一个 RRF 混合检索融合器,把关键词与向量排名统一去重、计分,并输出可直接交给 RAG 的候选文档。373 收藏
-
科技周边 · 人工智能 | 6天前 | python · 数据处理 · 人工智能 · AI Hugging Face Datasets select_columns remove_columns DatasetDict 数据集字段
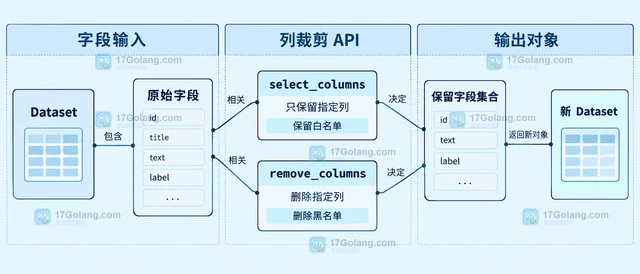 Hugging Face Datasets 按列处理时,先区分 select_columns 与 remove_columns,再确认 Dataset 和 DatasetDict 的作用范围,并说明 map 转换、缺列检查和新对象赋值的常见误区。373 收藏
-
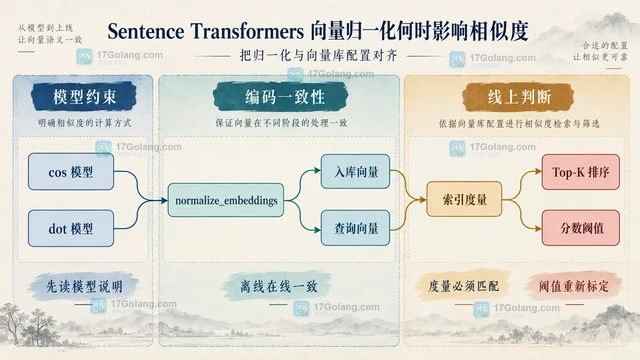 Sentence Transformers 的 L2 归一化不会改变余弦方向,但会改变原始点积和部分距离。本文用对照实验说明何时开启 normalize_embeddings。372 收藏
-
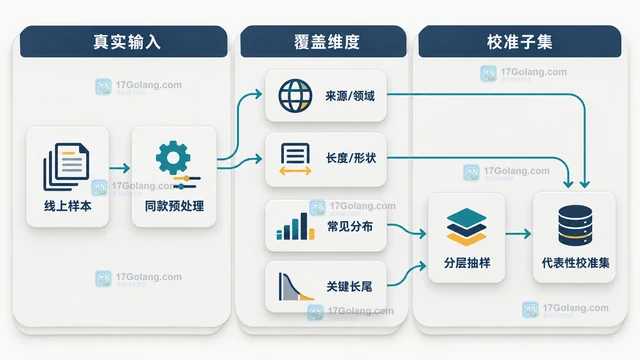 静态量化的校准集不能只随机抽训练样本。本文从线上预处理、来源领域、长度形状、常见分布和关键长尾建立覆盖矩阵,并说明如何用独立评估与漂移监控判断校准是否可靠。372 收藏
-
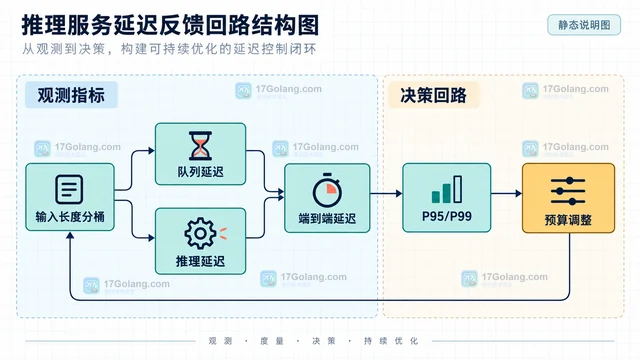 把推理请求的输入 token、输出上限、排队等待和生成吞吐拆开计算,再配合 TGI 的 token 与并发参数设置可解释的超时预算。371 收藏
-
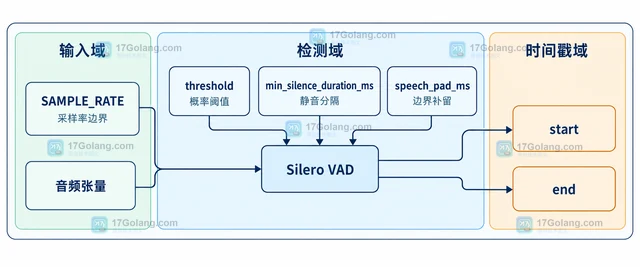 介绍语音转写前用 VAD 检测语音区间的方法,说明采样率、阈值、静音时长、边界 padding 和原始时间偏移如何配合,避免切掉词头词尾或让字幕时间轴失真。371 收藏
-
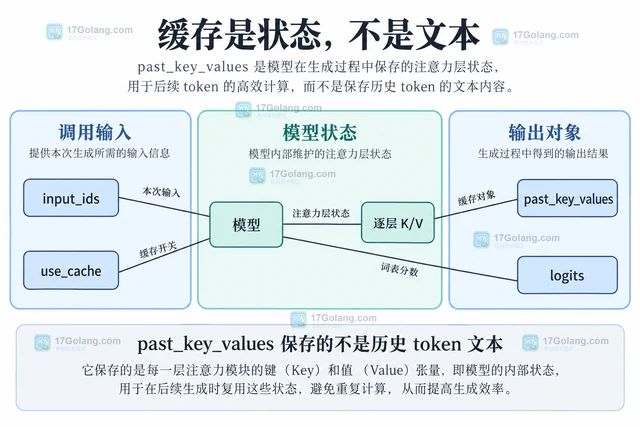 Transformers 的 past_key_values 保存已处理上下文的逐层 K/V,use_cache 控制缓存输出。本文用 GPT-2 原创示例解释新增 token、完整掩码与缓存长度的配合,并说明对象复用和内存边界。370 收藏
-
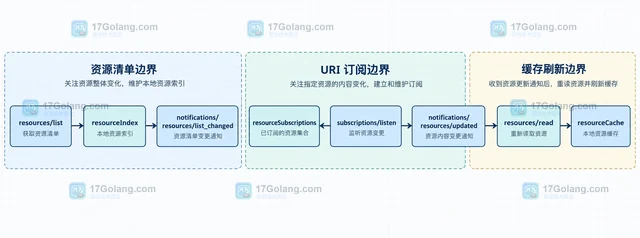 讲清 MCP 资源清单变更与单资源更新通知的区别,演示当前 subscriptions/listen 的 URI 订阅、旧协议兼容、缓存刷新和断线边界。369 收藏