-
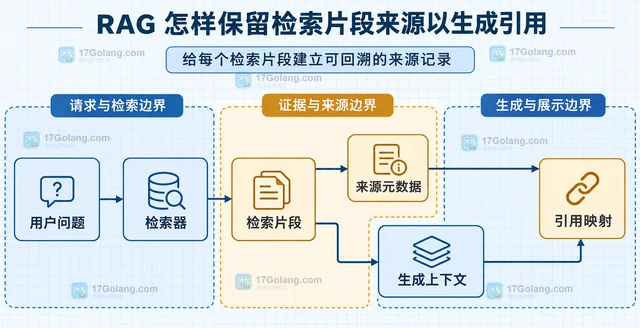
本文说明 RAG 如何在切片、检索、上下文拼接和回答渲染之间保留 chunk_id 与来源元数据,并把短引用标记映射回标题、章节和 URL。
-
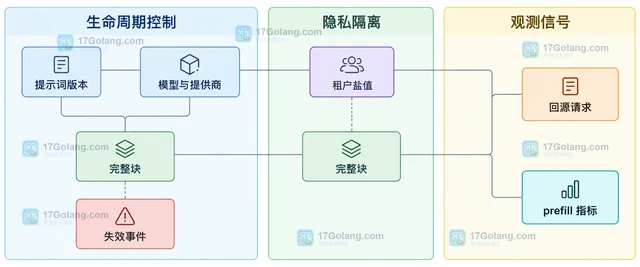
从稳定前缀、动态后缀、完整块、路由条件和租户隔离入手,说明 AI Prompt 前缀缓存怎样处理,以及为什么看起来相似的请求仍可能未命中。
-
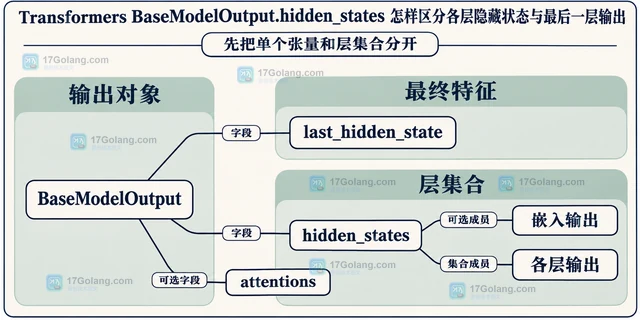
区分 Transformers BaseModelOutput 的 hidden_states 层集合与 last_hidden_state 最终特征,说明开启方式、嵌入输出索引和张量形状,并提醒跨模型不保证二者末项恒等。
-
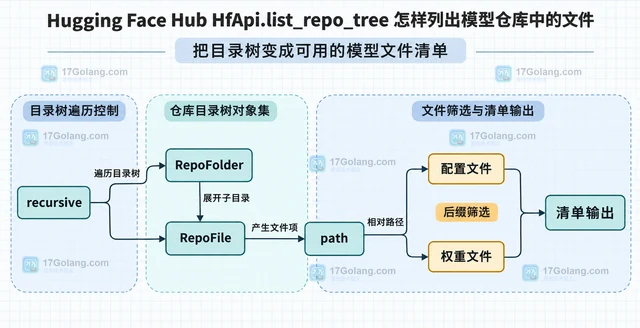
HfApi.list_repo_tree 返回 Hugging Face Hub 仓库的文件和目录对象,适合在不下载权重的前提下检查模型清单。本文从 repo_id、revision 和 repo_type 开始,演示如何递归读取、区分 RepoFile 与 RepoFolder、筛选配置文件,并说明 expand、顺序不保证和异常边界。
-
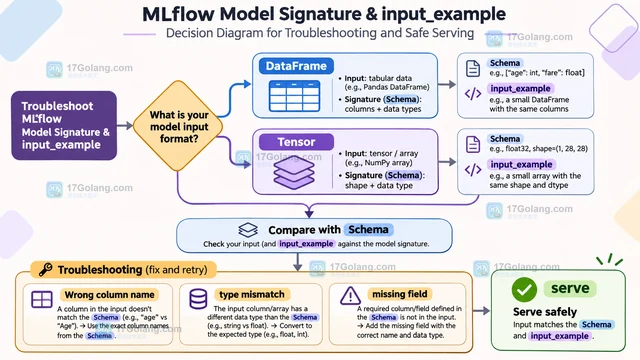
用一个 scikit-learn 分类小项目说明 MLflow 如何通过 input_example 自动记录模型签名,并从输入输出 schema 排查列名、类型和必填字段不匹配。
-
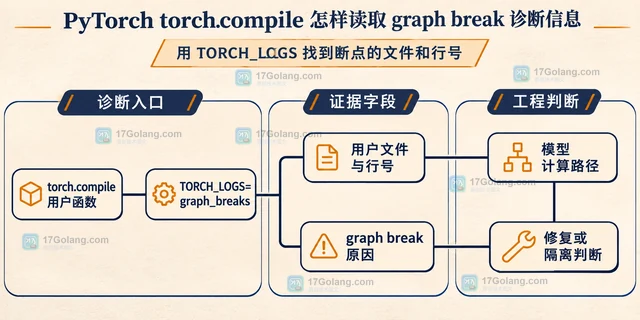
PyTorch torch.compile 遇到 graph break 时,先用 eager 基线确认问题,再通过 TORCH_LOGS=graph_breaks 和 torch._dynamo.explain 读取位置、原因与断点数量,最后根据代码错误、暂不支持行为或函数隔离选择修复方向。
-
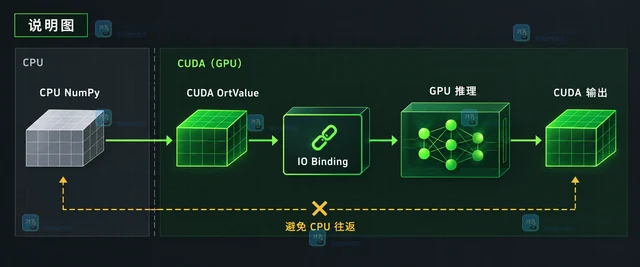
说明 ONNX Runtime Python 推理中 IO Binding 的设备驻留方式:用 CUDA OrtValue 绑定输入、在 GPU 上绑定或分配输出,并判断何时应该回传 CPU。
-
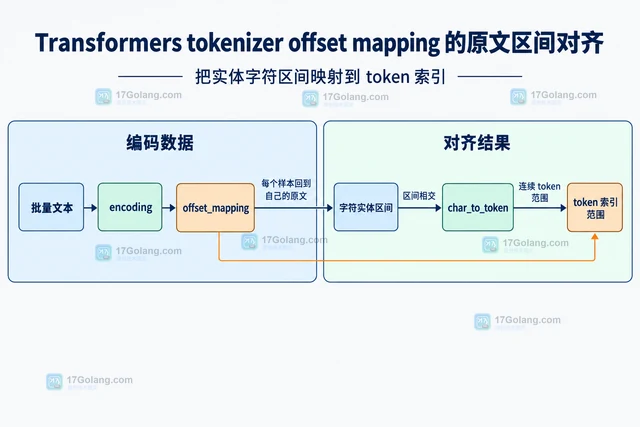
围绕 Hugging Face Transformers 的 Fast tokenizer 说明 offset_mapping 如何返回 token 对应的原文半开区间,处理特殊 token、空白、批量句对和截断,并给出实体字符区间转换为 token 范围的 Python 示例。
-
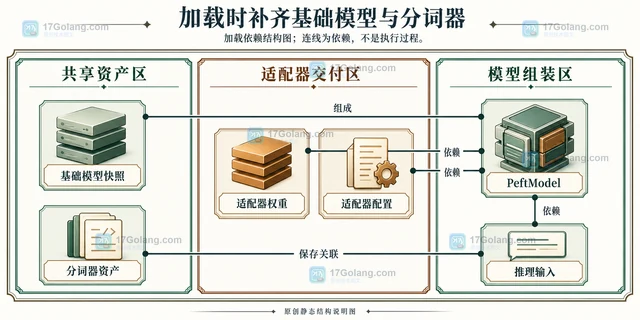
通过 PeftModel.save_pretrained 导出 LoRA 适配器,说明额外训练模块、嵌入层、基础模型依赖与训练断点的区别,并提供参数体积推算和文件统计写法。
-
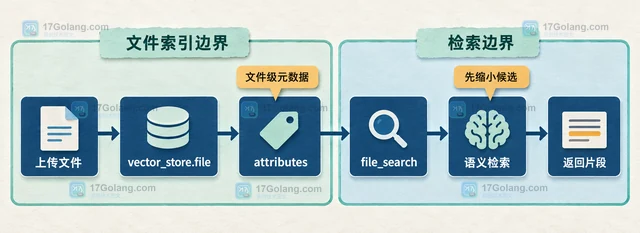
file search 的 filters 不是正文关键词过滤,而是先按 vector_store.file 的 attributes 缩小候选文件,再做语义和关键词检索。本文用 Python 示例说明 attributes、比较过滤、and/or 组合和无结果排查。
-
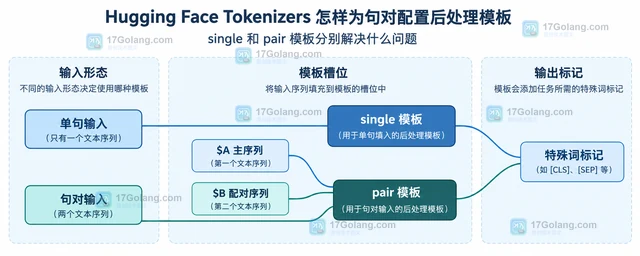
用 TemplateProcessing 为 Hugging Face Tokenizers 配置 single 与 pair 模板,说明 $A、$B、special_tokens 和 type_id 的对应关系,并整理句对长度与常见配置错误。
-
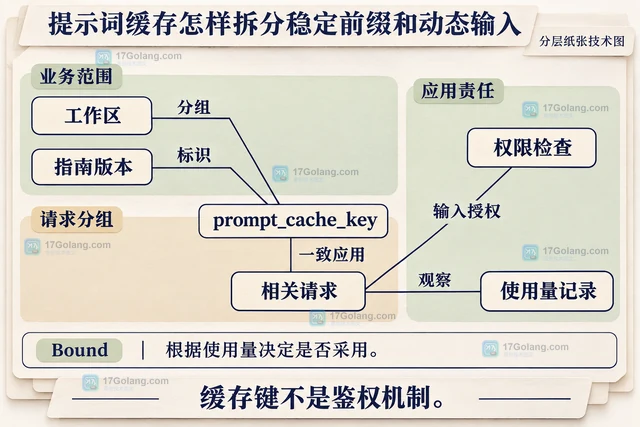
以 OpenAI Responses API 为例,说明稳定规则与动态输入的拆分方式,区分缓存键和显式断点,并给出请求组装、使用量读取与权限边界的实践建议。
-
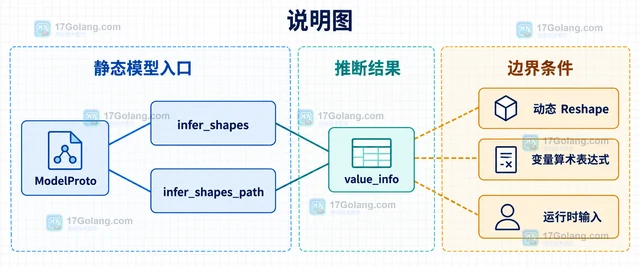
本文围绕 ONNX 动态输入的符号维度,说明 dim_param 与 dim_value 的区别、infer_shapes 的调用方式、value_info 的读取方法,以及动态 Reshape 和变量表达式带来的推断边界。
-
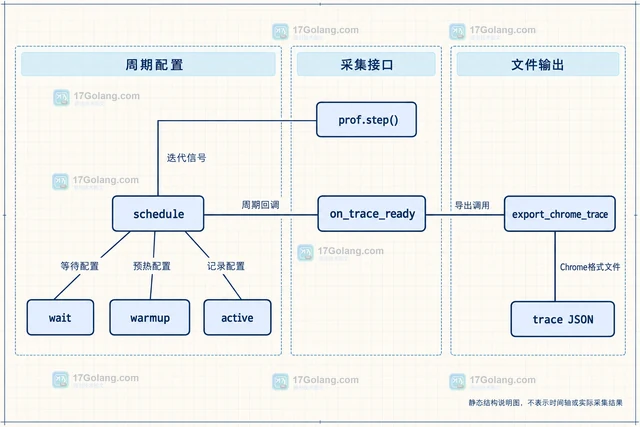
用一个最小 PyTorch 分析项目说明 torch.profiler 的采集范围、schedule 与 export_chrome_trace 的配合方式,导出可分享的 Chrome trace 文件,并区分静态示例、采集时机和结果解释边界。
-
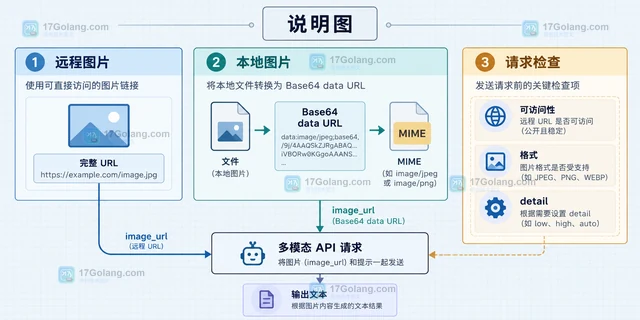
用 OpenAI Responses API 同时提交图片和文本问题,掌握 input_text、input_image、URL、Base64 data URL 与 detail 参数的写法、检查方法和边界。
