
Transformers bitsandbytes 量化后怎么保留部分模块精度
来源:17golang原创
时间:2026-10-05 17:34:39 359浏览 收藏
我在把一个 Transformers 模型压到 8-bit 时,最先遇到的不是显存不够,而是某个输出头的结果开始不稳定。解决办法不是把整个模型退回全精度,而是把敏感模块排除在 bitsandbytes 的线性层替换之外。官方文档把这个参数命名为 llm_int8_skip_modules:它表达的是“不要量化这些模块”,不等于“所有被跳过的权重都自动变成 float32”。
官方地址:https://huggingface.co/docs/transformers/main/en/quantization/bitsandbytes
- 8-bit 和 4-bit 都围绕同一份跳过模块清单工作,参数名里的
int8不代表 4-bit 不能使用。 - 显式传入清单时,把模型默认保护的
lm_head一并写入,避免覆盖默认排除项。 - 跳过量化只保证不替换为 bitsandbytes 线性层;实际 dtype 还要看
dtype、模型配置和设备映射。
先区分跳过量化与强制 fp32
“保留部分模块精度”通常有两种意思。第一种是让指定模块继续使用普通的 torch.nn.Linear,不转换成 Linear8bitLt 或 Linear4bit;第二种是无论设备和模型配置如何,都要求它以 float32 保存。前者用跳过清单,后者还涉及 dtype 与 CPU offload,不能只改一个参数。
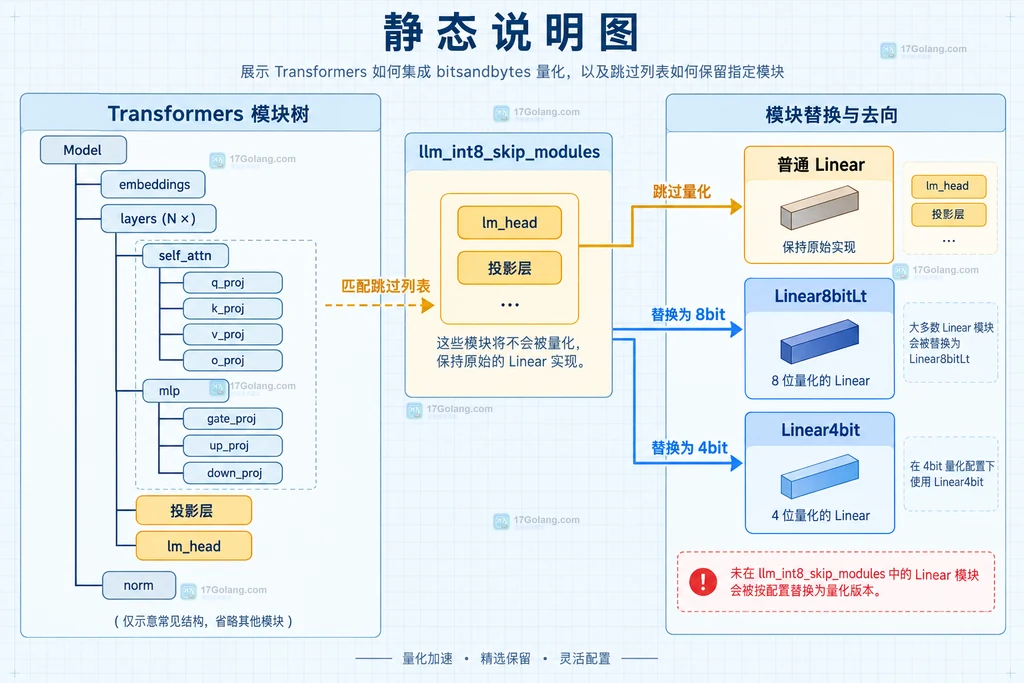
例如只想保护语言模型输出头,可以先用 8-bit 配置:
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

# 只保护输出头,其他线性层仍按 8-bit 方式加载
quant_config = BitsAndBytesConfig(
    load_in_8bit=True,
    llm_int8_skip_modules=["lm_head"],
)

model = AutoModelForCausalLM.from_pretrained(
    "your-model-id",
    quantization_config=quant_config,
    dtype="auto",  # 未量化模块沿用模型配置中的 dtype
    device_map="auto",
)
这里的关键是模块路径必须来自目标模型自己的模块树。不同架构的输出头可能叫 lm_head、language_model.lm_head 或其他名称,不能只凭模型类型猜。
8 位与 4 位都要维护完整跳过清单
8-bit 文档直接示范了 llm_int8_skip_modules=["lm_head"]。如果是 QLoRA 或 4-bit 推理,仍然使用这份字段把视觉塔、投影层或输出头加入跳过列表。字段名称虽然带有 int8,但在 Transformers 的 bitsandbytes 量化器中会被交给模块排除逻辑共同处理。
实际项目中更稳妥的写法是显式合并默认保护项:
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

# 显式列表可能替换自动识别的默认跳过项,因此把 lm_head 写进去
skip_modules = [
    "lm_head",                 # 保留输出头,避免输出投影被量化
    "model.vision_tower",      # 多模态模型中的视觉编码器示例
    "model.multi_modal_projector",  # 视觉到语言的投影层示例
]

quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",       # 训练型 4-bit 基座常用 NF4
    bnb_4bit_compute_dtype=torch.bfloat16,
    llm_int8_skip_modules=skip_modules,
)

model = AutoModelForCausalLM.from_pretrained(
    "your-model-id",
    quantization_config=quant_config,
    dtype="auto",
    device_map="auto",
)
这里的模块名只是配置示例,必须替换成目标模型真实存在的路径。近期 Transformers 代码中的排除逻辑会把用户清单和内部保留项合并,但不同模型、版本和量化器组合仍可能改变默认行为,所以显式保留 lm_head 是更容易排查的做法。
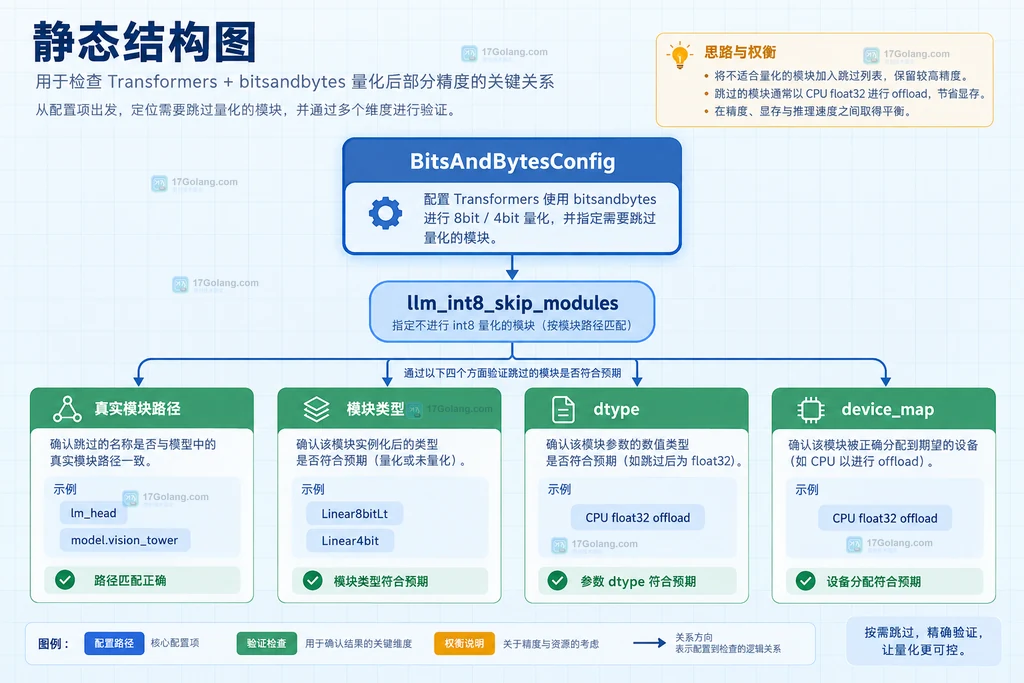
加载后按模块树核对四个结果
不要只看显存下降就判断配置生效。至少检查模块是否仍是普通线性层、参数 dtype、所在设备以及量化配置中的跳过列表。
import torch

# 用真实模块路径替换下面的名称,避免把路径错误当成量化结果
names = ["lm_head", "model.vision_tower"]
for name in names:
    module = model.get_submodule(name)
    first_param = next(module.parameters(), None)
    print(
        name,
        type(module).__name__,
        getattr(first_param, "dtype", None),
        getattr(first_param, "device", None),
    )

# 只观察配置,不把它当作运行验证的唯一证据
print(model.config.quantization_config)
结果判断可以按下面的表来做:
| 检查项 | 符合预期 | 异常时先查什么 |
|---|---|---|
| 模块类型 | 目标层不是 Linear8bitLt/Linear4bit | 模块路径是否写对,是否命中了嵌套名称 |
| dtype | 与 dtype="auto" 或显式 dtype 一致 | 不要把 skipped 直接等同于 float32 |
| 设备 | 与 device_map 和显存计划一致 | CPU offload 是否被误当作 GPU 精度保护 |
| 默认保护项 | lm_head 等敏感层仍在清单内 | 显式列表是否覆盖了自动排除项 |
如果 8-bit 模型需要把一部分权重放到 CPU 并保持 float32,应额外使用 llm_int8_enable_fp32_cpu_offload=True,再配合把对应模块放到 CPU 的 device_map。这会增加 CPU 内存和数据搬运成本,不能当成免费的精度开关。
常见问题
为什么写了模块名,加载后仍然像被量化了?
先确认路径是否和 named_modules() 完全一致,再看模块类型,而不是只看参数 dtype。一个模块内部可能还包含其他线性子层,跳过父模块并不等于递归覆盖所有自定义子模块。
4-bit 的参数为什么叫 llm_int8_skip_modules?
这是 Transformers 与 bitsandbytes 集成层沿用的字段名。它描述的是排除模块转换的配置入口,不能仅因为名称包含 int8 就判断 4-bit 不支持。
跳过模块后显存为什么增加?
被跳过的层不再使用 4-bit 或 8-bit 权重,自然会占用更多显存;如果再启用 CPU float32 offload,还会增加 CPU 内存和传输开销。应优先保护确实敏感的层,再用显存和输出质量对比决定范围。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
499 收藏
-
164 收藏
-
291 收藏
-
372 收藏
-
314 收藏
-
293 收藏
-
247 收藏
-
194 收藏
-
268 收藏
-
316 收藏
-
150 收藏
-
148 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习