
AI 提示词缓存如何按稳定前缀组织请求
来源:17golang原创
时间:2026-09-15 14:18:25 357浏览 收藏
同一个 AI 应用明明反复使用同一套角色说明、工具定义和格式约束,输入成本却没有明显下降,常见原因不是“缓存坏了”,而是动态内容放到了前缀里。提示词缓存按渲染后的连续前缀复用已经计算过的 KV 状态;只要变化发生在前缀中间,变化点后面的内容就不能继续复用。
官方地址:https://developers.openai.com/api/docs/guides/prompt-caching
- 固定指令、工具 schema、输出格式和稳定示例放前面,用户问题、检索片段和时间戳放最后。
- GPT-5.6 及以后可按模型能力选择显式或隐式断点;较早模型更需要稳定的
prompt_cache_key来帮助路由。 - 不要只看延迟,用
cached_tokens、cache_write_tokens和模型维度判断缓存读取、首次写入还是失效。
先把请求拆成稳定区和动态区
可以把一次请求想成三层:最前面是不会随用户变化的应用契约,中间是尽量固定的工具与格式定义,末尾才是本轮问题和检索结果。稳定区不是“越长越好”,而是应该包含会被同一工作流反复使用的内容,并达到目标模型的可缓存长度。
| 内容 | 建议位置 | 变化时的影响 |
|---|---|---|
| 角色说明、业务规则 | 前缀 | 改动会使后续前缀无法继续复用 |
| 工具名称、描述、参数 schema | 前缀 | 顺序或字段变化都可能改变渲染结果 |
| 输出格式与固定示例 | 前缀 | 应按版本一起发布 |
| 用户问题、RAG 片段、请求时间 | 末尾 | 只影响本轮新增输入 |
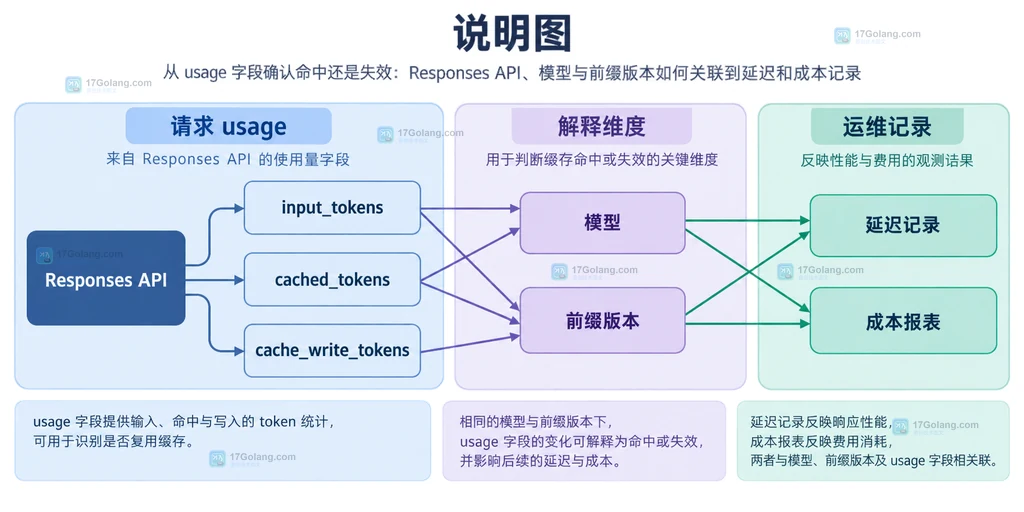
用固定前缀组织一次 Responses API 请求
下面的示例故意把可变的订单问题放在最后。示例使用当前文档中的 GPT-5.6 参数形态:默认按隐式断点工作,并把保留时间写成请求选项。较早模型的参数名和支持范围不同,部署前要按目标模型文档调整。
import OpenAI from "openai";

const client = new OpenAI();

const stableInput = [
  {
    role: "developer",
    content: [
      {
        type: "input_text",
        // 固定业务规则放在动态问题前,保证前缀连续且可复用。
        text: "你是订单支持助手。只根据提供的订单资料回答;不确定时返回 need_review。"
      }
    ]
  },
  {
    role: "developer",
    content: [
      {
        type: "input_text",
        // 固定输出契约不要混入本轮订单内容。
        text: "输出 JSON:{status, answer, reasons, need_review},reasons 必须是数组。"
      }
    ]
  }
];

const response = await client.responses.create({
  model: "gpt-5.6",
  input: [
    ...stableInput,
    {
      role: "user",
      // 动态问题、检索片段和请求标识统一放在末尾。
      content: [{ type: "input_text", text: JSON.stringify({
        question: "订单 A-102 是否可以退款?",
        retrieved_facts: ["已签收 3 天", "商品未使用"],
        request_id: "req-20260915-01"
      }) }]
    }
  ],
  prompt_cache_options: { mode: "implicit", ttl: "30m" }
});

console.log(response.usage?.input_tokens_details);
// 记录 cached_tokens 与 cache_write_tokens,便于按前缀版本排障。
如果应用还带工具定义,工具的名称、描述、参数 schema 和排列顺序也应作为稳定区的一部分。不要为了给每个租户拼接一段欢迎词,就把这段可复用内容插入工具定义前面;租户差异可以放在动态消息末尾,或者用稳定、可审计的前缀版本做隔离。
按模型选择 key、断点和保留策略
缓存键解决的是“哪些请求属于同一组”的路由和统计问题,不是命中保证。当前文档对 GPT-5.6 及以后模型建议由平台自动处理路由,prompt_cache_key 可用于客户或工作区的独立核算;较早模型则应给共享稳定前缀的请求使用稳定 key,高流量时再按确定性规则拆分多个 key。
处理线上变更时,把提示词模板视为有版本的配置:固定规则从 order-assistant-v3 升到 v4,就接受一次新的缓存写入,不要在旧 key 下混放两套 schema。对于 GPT-5.6 及以后,如果只有前缀值得复用,可使用显式模式并在固定内容后设置断点;如果请求后半段也会被同一工作流复用,再考虑让隐式模式覆盖更多内容。
回滚也要回滚前缀版本和工具 schema。只改 key 而保留不一致的开发者指令,会制造多个不可解释的缓存分组;只改动态问题的位置,则可能把每次请求都变成全新的前缀。
从 usage 字段确认命中还是失效
值班时至少保存模型、前缀版本、请求总输入 token、缓存读取 token、缓存写入 token 和首字节延迟。第一次写入可能看到 cache_write_tokens,后续共享前缀的请求会看到 cached_tokens;这两者都为零时,优先比较从开发者指令到断点之间的实际渲染内容,再检查缓存保留期、模型切换、工具 schema 变化和路由分散。
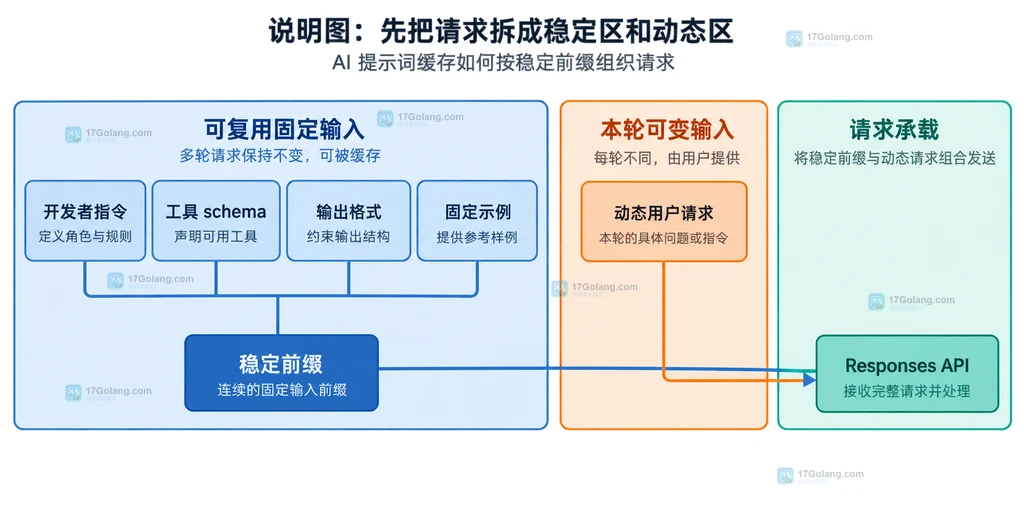
告警不要只设一个“命中率低”。更实用的分层是:前缀版本变更告警、连续窗口内 cached_tokens / input_tokens 下降告警、cache_write_tokens 异常上升告警,以及首字节延迟随未缓存输入同步上升的告警。这样可以区分正常发布后的冷缓存和真正的模板漂移。
常见问题
同一个 prompt_cache_key 能保证缓存命中吗?
不能。它影响分组或路由,仍要求渲染前缀匹配、达到模型要求的长度,并且缓存条目尚未过期。
把用户问题放在 developer 消息里会更容易命中吗?
不会。角色名称不是关键,关键是动态文本是否出现在可复用前缀中。把变化内容放到末尾更容易保留前面的共享前缀。
缓存命中后输出会完全一样吗?
不会。缓存只复用输入处理的中间状态,模型仍会为本轮输入生成新输出,也不等于结果具备幂等性。
缓存 token 还计入限流吗?
会。缓存输入 token 仍计入 tokens-per-minute 等速率限制,成本降低不代表可以忽略限流预算。
最终检查清单可以压缩成四项:固定内容是否连续、动态内容是否在末尾、key 与模型版本是否匹配、usage 是否能解释每次缓存读写。四项都能回答,提示词缓存才真正进入可运维状态。
-
485 收藏
-
207 收藏
-
493 收藏
-
433 收藏
-
489 收藏
-
473 收藏
-
381 收藏
-
195 收藏
-
162 收藏
-
246 收藏
-
145 收藏
-
科技周边 · 人工智能 | 10小时前 | 人工智能 · rag · 向量检索 · 检索增强生成 · rerank · 向量数据库 metadata filter 向量检索过滤条件 rerank顺序 RAG检索409 收藏
-
科技周边 · 人工智能 | 11小时前 | 上下文管理 · 向量检索 · AI工程 · RAG实践 · 文档切片 · chunk overlap RAG文档切片 RAG重叠窗口 上下文膨胀 向量检索召回238 收藏
-
科技周边 · 人工智能 | 12小时前 | API · 人工智能 · 结构化输出 · 函数调用 · Responses API Structured Outputs function_call_output111 收藏
-
312 收藏
-
111 收藏
-
356 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习