-
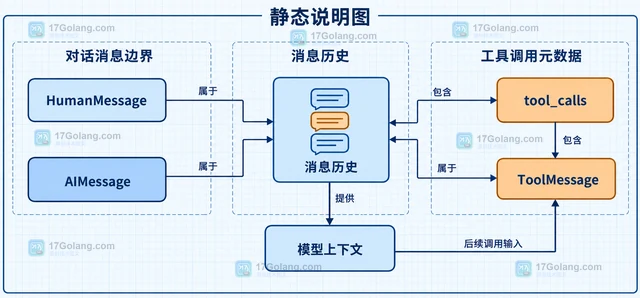
LangChain 工具调用需要保留完整 messages,而不是只取最终文本。本文说明 AIMessage、ToolMessage、tool_call_id、content 与 artifact 的关系,以及如何保存中间消息并继续交给模型。
-
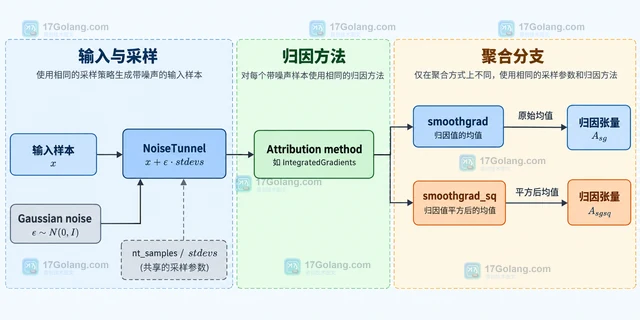
Captum NoiseTunnel 的 SmoothGrad 与 SmoothGradSquared 都会对加噪输入重复计算归因,但前者聚合原始归因均值,后者聚合平方后的归因均值。本文用公式、代码和选型表说明符号、强度与参数边界。
-
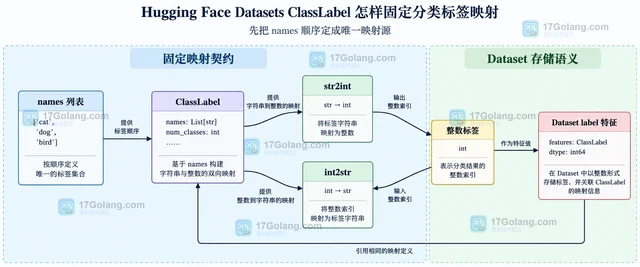
Hugging Face Datasets 的 ClassLabel 不应根据每个数据切片临时推导。本文用固定 names 顺序统一训练、验证和推理标签,并说明 map、cast_column、names_file、int2str 与 str2int 的边界。
-
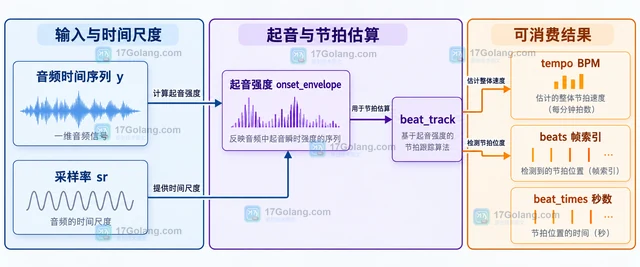
用 librosa.beat.beat_track 从音频的起音强度中估算 BPM 和节拍位置,并把帧索引稳定转换为秒;同时说明空结果、BPM 为 0 和 hop_length 不一致时怎样排查。
-
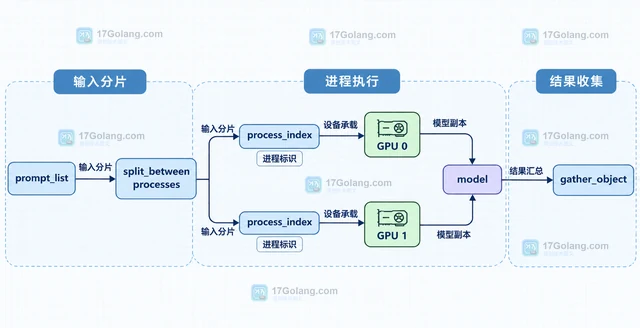
用 CUDA_VISIBLE_DEVICES 和 accelerate launch 明确可见 GPU 与进程数量,再通过 PartialState 读取每个进程的设备,给出多进程推理时的绑定、分片和排错方法。
-
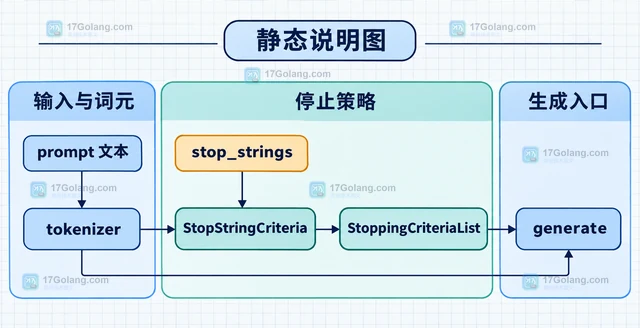
用 StopStringCriteria 和同一 tokenizer 组合生成终止条件,让 Transformers 在文本出现指定结束字符串后停止,并说明标记后处理与框架边界。
-
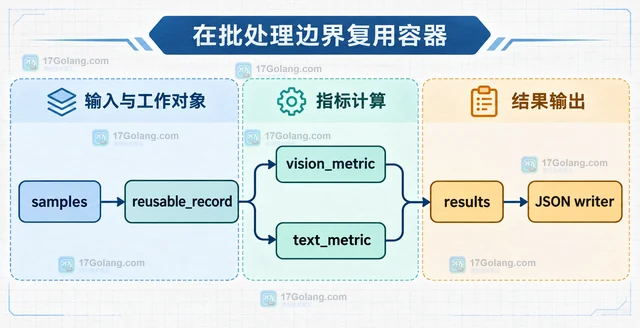
多模态评测同时包含图像理解和文本生成时,不要把所有分数塞进同一个字段。本文用 Hugging Face Evaluate 的指标分类思路设计分区结果对象,并通过复用容器、批量计算和一次序列化减少批处理中的额外分配。
-
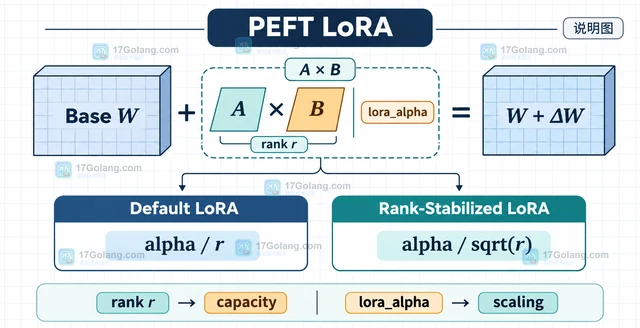
解释 PEFT LoRA 中 rank、lora_alpha 与适配器缩放因子的关系,比较默认 LoRA 和 rsLoRA 的公式,并给出可复查的 LoraConfig 配置与参数检查方法。
-
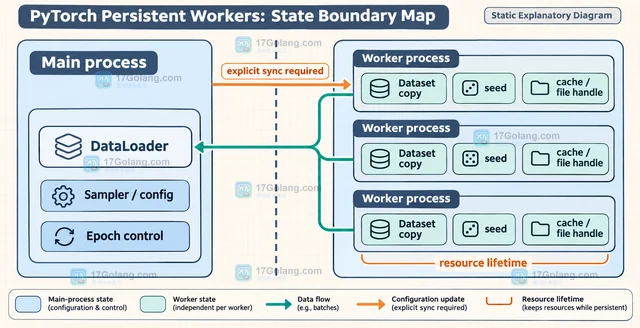
通过 persistent_workers=True 复用 PyTorch DataLoader 的多进程 worker,本文说明 DataLoader 的放置位置、Dataset 状态边界、参数取舍和关闭条件。
-
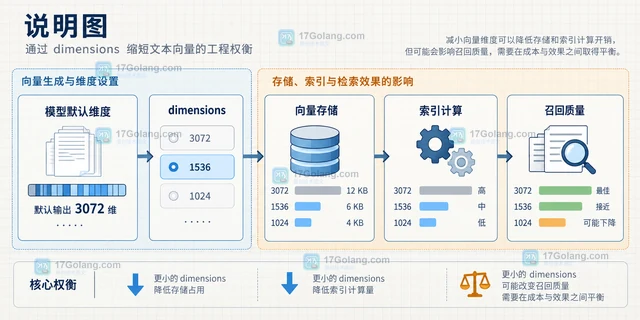
OpenAI embeddings 的 dimensions 不是越大越好。本文从默认维度、向量库限制、检索质量、存储与回滚几个方面,说明 text-embedding-3-small 和 text-embedding-3-large 怎样选择维度缩减参数。
-
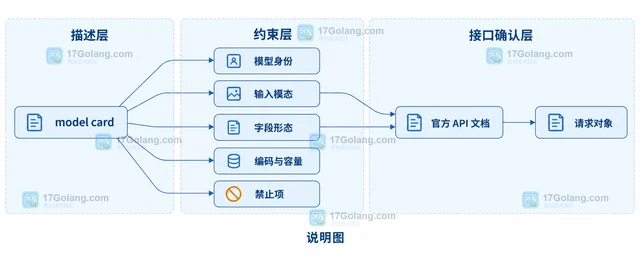
model card 更适合作为输入契约的索引,而不是可直接提交的接口 schema。本文按输入模态、字段形态、编码与容量、禁止项和已知局限拆读,再用官方 API 文档确认最终请求字段。
-
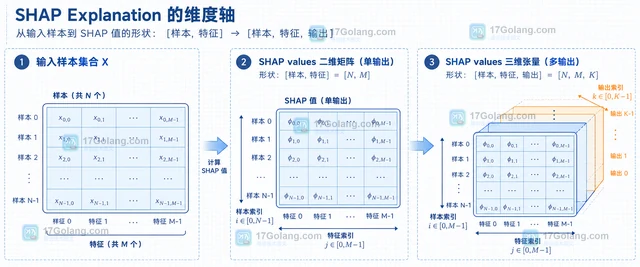
SHAP Explanation 的 values 形状需要结合样本、特征和模型输出一起读取。本文用单输出与多输出示例说明 shape、feature_names、output_names 的对应关系,以及如何按样本和输出安全切片。
-
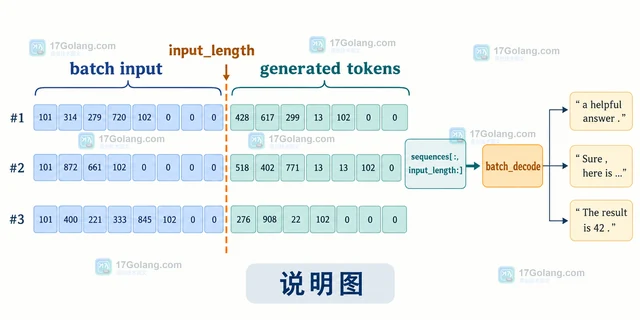
用 Hugging Face Transformers generate 控制新生成 token 数,厘清 max_new_tokens 与 max_length 的区别,并给出批量解码和长度边界的实用写法。
-
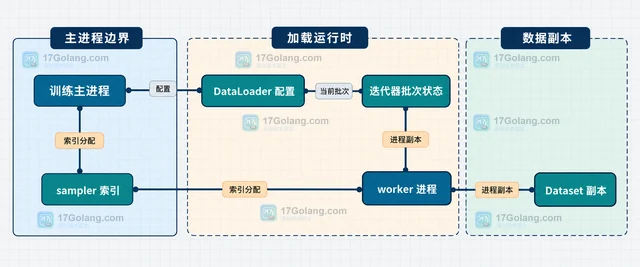
本文说明 PyTorch DataLoader 的 persistent_workers 如何影响 worker 进程、迭代器和 Dataset 副本的生命周期,给出跨 epoch 复用的最小配置,并说明内存、状态管理、IterableDataset 分片和调试边界。
-
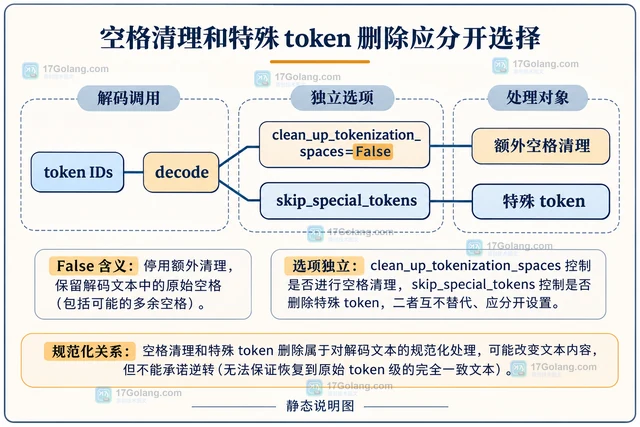
Transformers decode 可用 clean_up_tokenization_spaces=False 停用额外空格清理。结合示例区分特殊 token 删除、后端解码与原文保存,给出展示和诊断场景的参数选择。
