
ONNX Runtime 动态量化怎么选择需要排除的节点
来源:17golang原创
时间:2026-10-06 23:09:16 377浏览 收藏
ONNX Runtime 的动态量化并不是“精度下降就排除最后几层”。nodes_to_exclude 接受的是节点名称列表,不是算子类型或张量名称。可靠的做法是先得到全量动态量化基线,再用同一批样本找出误差集中的节点,每次只排除一个节点或一个紧邻小组,重新比较任务指标与延迟。
官方文档:https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html
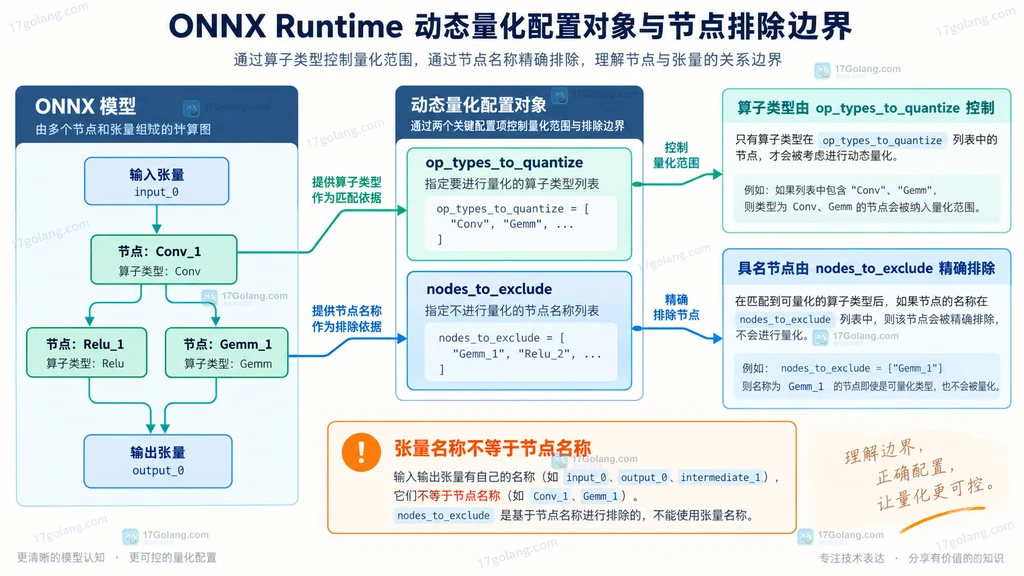
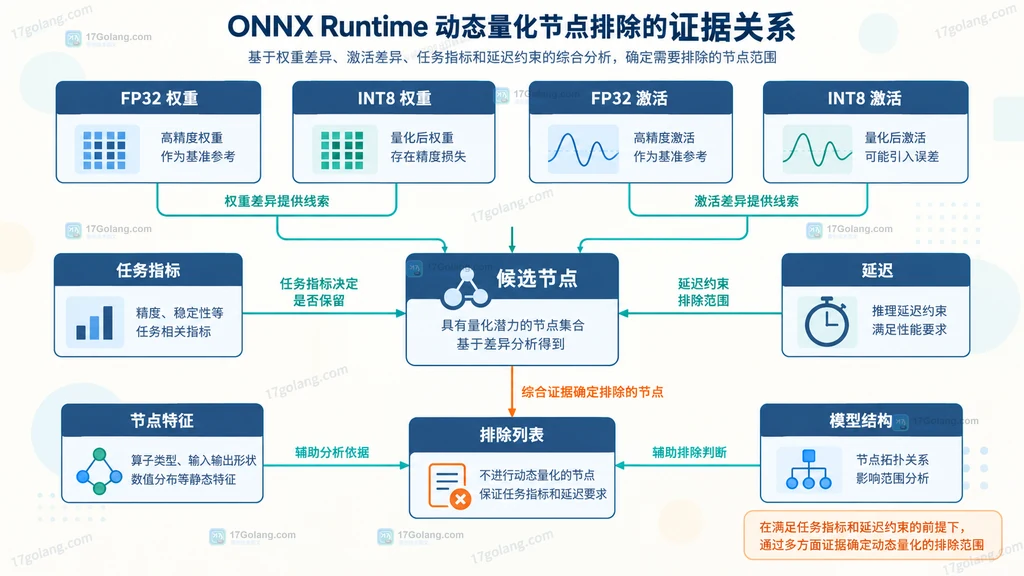
op_types_to_quantize控制算子类别,nodes_to_exclude精确控制具名节点。- 候选节点来自任务指标和权重/激活差异,而不是固定的“敏感层名单”。
- 每次只改变少量排除项,并同时记录准确率、延迟和模型大小,才能判断取舍是否有效。
先确认排除列表匹配的是节点名称
官方源码对 nodes_to_exclude 的说明是“要排除的节点名称列表”。因此,MatMul 这样的字符串通常是算子类型,不是可直接排除的节点;某个权重张量名也不等于节点名。先导出模型中可能参与动态量化的节点:
import onnx

model = onnx.load("model.onnx")
target_ops = {"MatMul", "Gemm", "LSTM", "GRU"}

for node in model.graph.node:
    # nodes_to_exclude 使用 node.name,不能误填输出张量名。
    if node.op_type in target_ops:
        print({
            "name": node.name,
            "op_type": node.op_type,
            "inputs": list(node.input),
            "outputs": list(node.output),
        })
如果候选节点的 name 为空,先在导出阶段为节点生成稳定名称,再开始量化对比。否则排除配置很难跨版本复用,也无法确认一次修改命中了哪个节点。
建立“全量量化”基线后再找候选节点
先保留 FP32 模型,再生成不排除任何节点的动态量化模型。两份模型必须使用同一执行环境、同一预处理和同一评测样本。动态量化会在运行时计算激活的量化参数,因此可能比静态量化多出开销;不能只看模型体积就判断收益。
from onnxruntime.quantization import QuantType, quantize_dynamic

quantize_dynamic(
    model_input="model.onnx",
    model_output="model.int8.all.onnx",
    # 先限制计划量化的算子类别,便于解释比较结果。
    op_types_to_quantize=["MatMul", "Gemm"],
    weight_type=QuantType.QInt8,
    # 基线不排除节点,后续实验只修改这一项。
    nodes_to_exclude=[],
)
基线至少记录三类结果:业务任务指标、端到端延迟、模型文件大小。任务指标可以是分类准确率、F1、困惑度或业务自定义评分,但必须固定样本和计算方式。延迟要包含预热,并明确批量大小与执行提供程序。
用差异定位,而不是按层名猜测
ONNX Runtime 提供 qdq_loss_debug 相关 API,可匹配量化前后的权重和中间激活。它们的价值不是自动给出排除名单,而是帮助找到差异最大的张量,再回查产生这些张量的节点。动态量化模型的可比较范围取决于模型结构与量化方式,因此最终仍要以任务指标为准。
候选节点可以按下面的证据顺序进入列表:首先是量化后任务指标明显恶化的样本;其次是这些样本中差异集中的权重或激活;最后才是对应的具名节点。若一次排除大量同类节点才能恢复精度,应该重新检查 op_types_to_quantize、预处理、权重类型或目标硬件,而不是无限扩张排除列表。
每轮只排除一个节点或一个小组
下面的节点名只是格式示例,必须替换成当前模型里真实存在的 node.name:
from onnxruntime.quantization import QuantType, quantize_dynamic

# 示例名称来自假想模型,仅演示精确节点排除的写法。
excluded_nodes = [
    "encoder.layer.11.output.dense/MatMul",
]

quantize_dynamic(
    model_input="model.onnx",
    model_output="model.int8.exclude-01.onnx",
    op_types_to_quantize=["MatMul", "Gemm"],
    weight_type=QuantType.QInt8,
    nodes_to_exclude=excluded_nodes,
)
先测试单个节点;只有相邻节点共同影响同一误差时,才把它们作为一个小组。若任务指标恢复但延迟接近 FP32,说明排除范围过大。若精度没有变化,应撤回该项,避免把偶然相关写进长期配置。
| 实验 | 排除节点 | 任务指标 | P50/P95 延迟 | 结论 |
|---|---|---|---|---|
| FP32 基线 | 不适用 | 填写实测值 | 填写实测值 | 质量与性能参照 |
| 全量动态量化 | 空列表 | 填写实测值 | 填写实测值 | 确认量化收益与损失 |
| 候选实验 A | 单个具名节点 | 填写实测值 | 填写实测值 | 保留或撤回 |
| 候选实验 B | 紧邻小组 | 填写实测值 | 填写实测值 | 与 A 对比 |
冻结配置前检查四个边界
- 名称边界:排除项都能在当前 ONNX 图中按
node.name唯一命中。 - 数据边界:候选节点由代表性评测集产生,不只对一条异常样本有效。
- 性能边界:排除后仍保留可接受的端到端加速,且目标硬件实际受益。
- 版本边界:重新导出或优化模型后再次核对节点名,不盲目复用旧列表。
相关问题
可以直接把 LayerNorm、Softmax 全部排除吗?
不建议。它们是否进入当前动态量化范围取决于支持的算子和配置。先查看实际被量化的节点,再根据差异证据决定;不要把经验名单当成模型无关规则。
nodes_to_exclude 和 op_types_to_quantize 怎么配合?
前者适合保留少量例外节点,后者适合定义允许量化的算子类别。排除项不断增多时,优先重新收紧算子类别或检查量化参数。
排除节点后还需要比较 FP32 吗?
需要。每轮实验都应同时参照 FP32 与全量量化基线,才能区分“恢复质量”和“只是改变了结果”,并判断性能收益是否仍然存在。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
165 收藏
-
454 收藏
-
358 收藏
-
328 收藏
-
科技周边 · 人工智能 | 11小时前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size470 收藏
-
308 收藏
-
309 收藏
-
175 收藏
-
359 收藏
-
499 收藏
-
164 收藏
-
291 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习