-
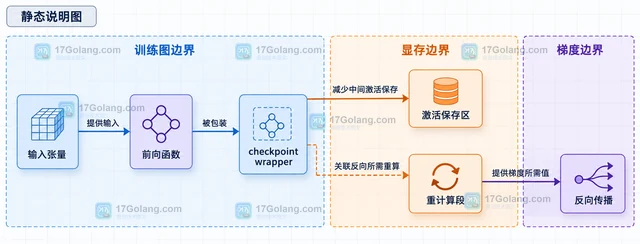
PyTorch activation checkpointing 用减少前向激活保存、反向阶段重计算来换取训练显存。本文围绕 torch.utils.checkpoint、use_reentrant=False、随机状态和 early_stop,说明适用边界与生产检查要点。
-
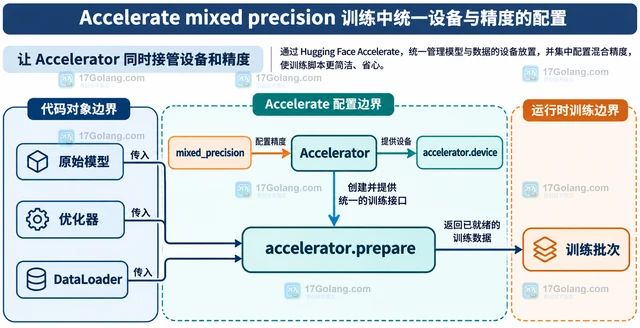
Accelerate 训练时,把设备放置、mixed precision 和启动参数集中到同一个 Accelerator 配置中,能减少手动 to 设备造成的冲突。本文用一段可迁移的 PyTorch 训练骨架说明 prepare、autocast、backward 以及常见排查方法。
-
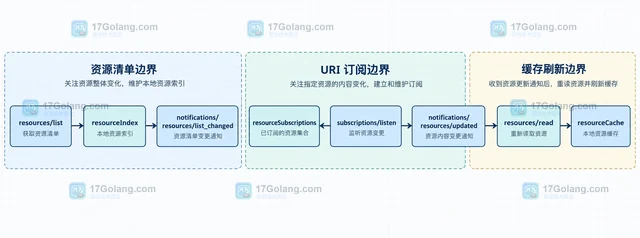
讲清 MCP 资源清单变更与单资源更新通知的区别,演示当前 subscriptions/listen 的 URI 订阅、旧协议兼容、缓存刷新和断线边界。
-
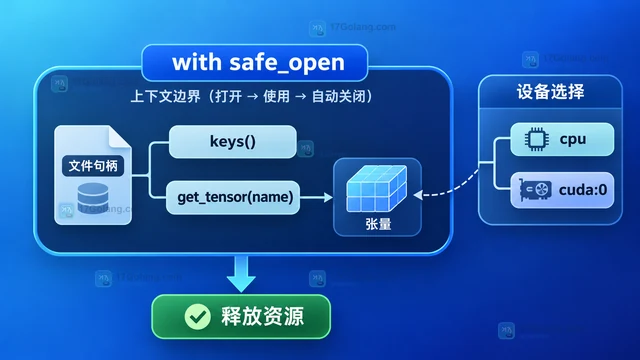
用 safe_open 读取 Safetensors 中的单个张量时,先确认真实键名,再在上下文管理器中调用 get_tensor,并正确处理 framework、device 与键名错误。
-
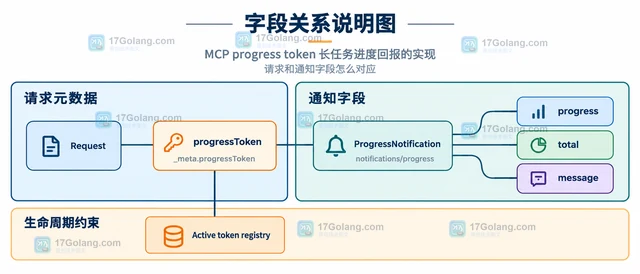
MCP 长任务进度回报依赖请求中的 progressToken 与 notifications/progress 通知。本文用 TypeScript 示例说明 token 关联、progress 递增、total 缺失、最终结果分离和取消资源边界。
-
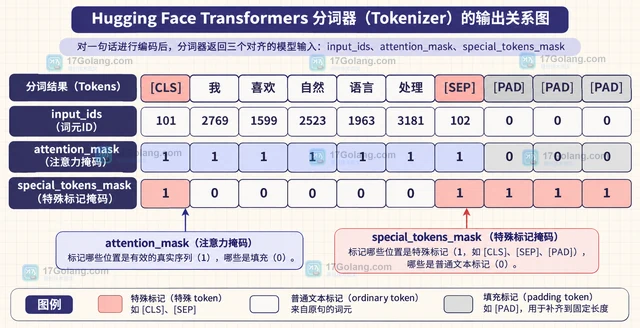
Transformers 的特殊 token 位置掩码由 return_special_tokens_mask=True 返回,1 表示 [CLS]、[SEP]、[PAD] 等特殊 token,0 表示普通序列 token。文章区分它与 attention_mask 的用途,并给出句对、padding 以及手动拼接 token ID 时的处理方式。
-
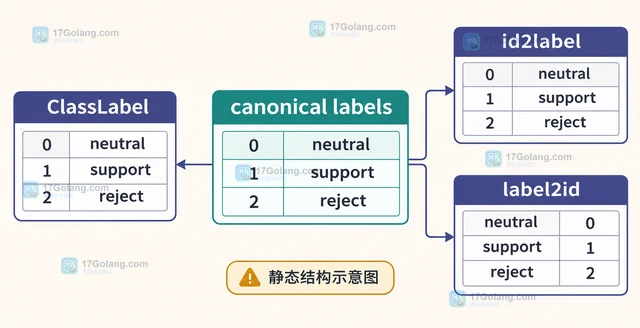
用同一份有序标签表同步 Hugging Face Datasets 的 ClassLabel 与模型的 id2label、label2id,避免训练和评估阶段出现标签名称错位。
-
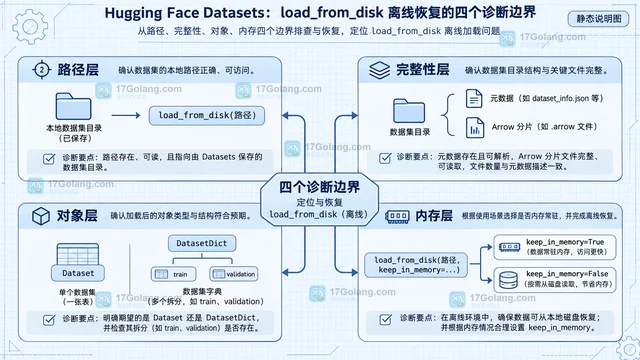
Hugging Face Datasets 的 save_to_disk 可以把 Dataset 或 DatasetDict 写入固定目录,load_from_disk 再从该目录恢复。本文从离线场景出发,说明单数据集与多 split 的保存方式、分片参数、路径边界,以及目录缺失和内存占用的排查顺序。
-
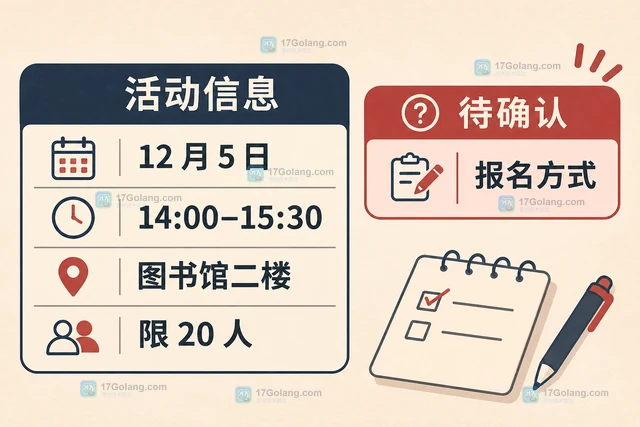
以读书分享会为例,用同一组活动信息在讯飞绘文写校内公告和群通知,逐项核对时间、地点和人数,单独处理待确认的报名方式。
-
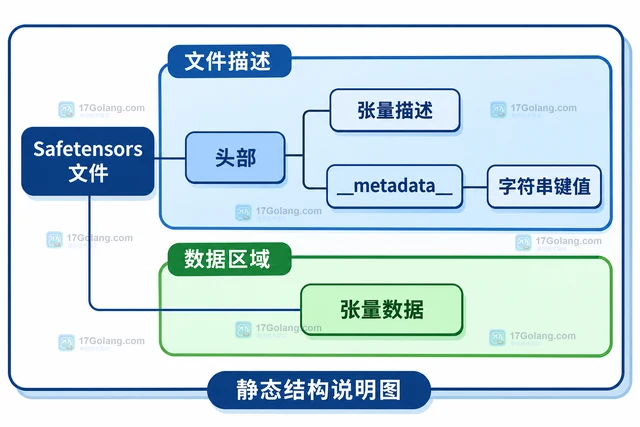
通过safe_open和metadata()读取Safetensors文件级字符串标签,区分None、字段缺失与读取失败,并用临时小文件说明元数据与张量结构、配置文件的区别。
-
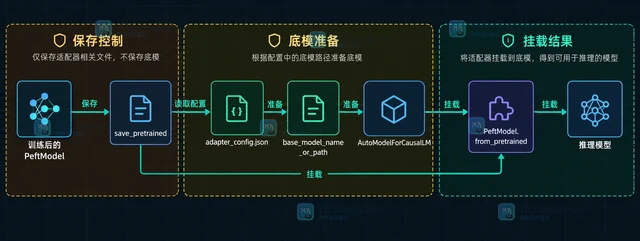
用 Hugging Face PEFT 训练 LoRA 后,怎样只保存 adapter_model.safetensors 与 adapter_config.json,而不把底模权重打进交付包?本文按资产、风险路径、保存加载代码和文件审计说明适配器交付边界。
-
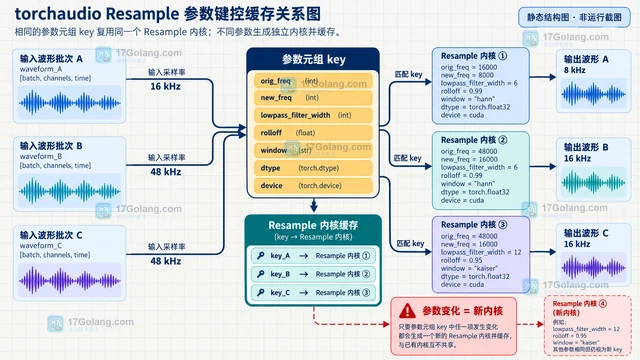
固定采样率的音频批处理不必反复生成重采样卷积核。本文说明 torchaudio.transforms.Resample 与 functional.resample 的缓存边界,并给出按采样率、滤波参数、dtype 和设备分层复用的实现方式。
-
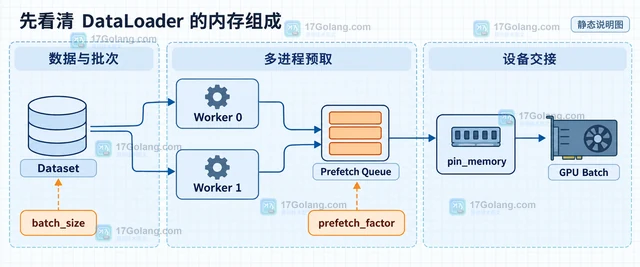
OpenAI Realtime API 断线后不会替应用自动恢复业务上下文,稳定做法是把连接与会话状态分开保存,重连后重新配置 session,再按确认点重放摘要和未确认输入,最后只对完整的新输入触发 response.create。
-
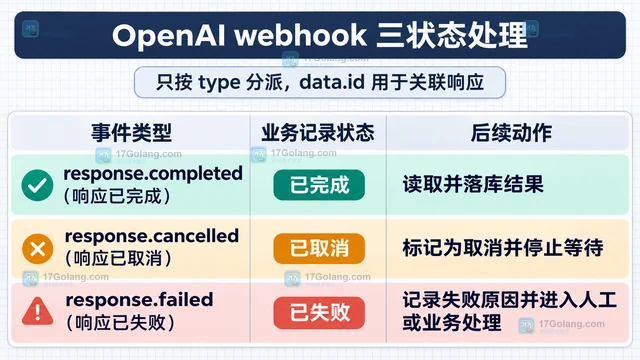
OpenAI webhook 的 response.completed、response.cancelled 和 response.failed 都通过 data.id 关联后台响应,但业务含义不同。本文用一个保留原始请求体验签的 Node.js 分派示例,说明三种状态如何落库、哪些分支不能合并,以及怎样处理重复和未知事件。
-
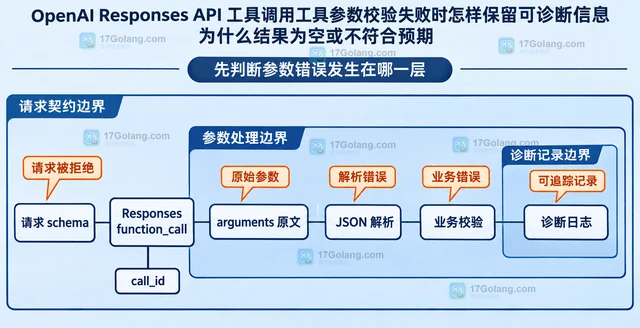
Responses API 的工具调用出现参数校验失败时,空的 output_text 不一定代表没有结果。本文区分 schema 请求拒绝、function_call 返回和应用侧校验失败,给出保留原始参数、call_id 与结构化错误的处理方式。
