
人工智能技术文章
-
 LLM评测集不要只放正常问答。更稳妥的做法是把样本分成正常任务、明确拒答和可澄清的边界请求,为每条记录期望行为、原因标签和替代方向,再按分片统计完成率、拒答准确率、澄清率与不必要拒答率。177 收藏
-
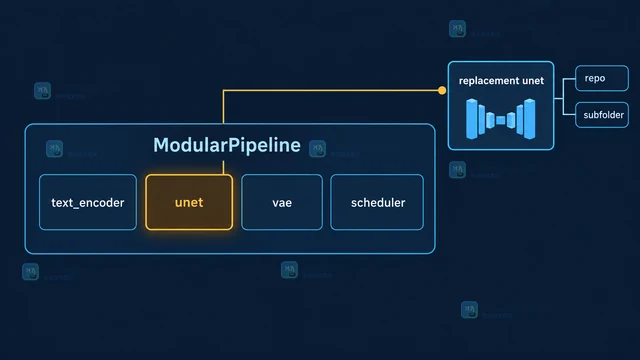 Diffusers ModularPipeline 替换单个模型组件时,应先取得组件规格并加载兼容对象,再用 update_components 更新同名槽位。本文说明两种替换写法、加载顺序、配置型组件区别和排错清单。175 收藏
-
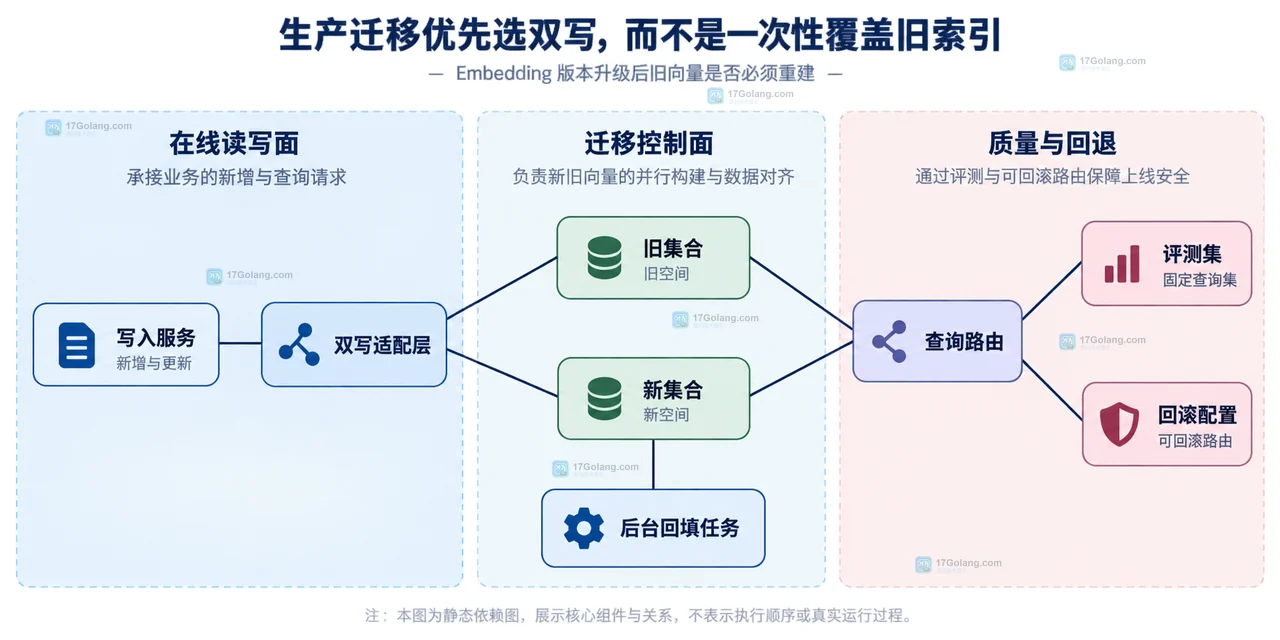 Embedding 模型、维度或距离度量升级后,旧向量通常不能直接混用。本文说明如何判断空间兼容性,并用双写、后台回填、灰度评测和可回滚切换完成生产迁移。173 收藏
-
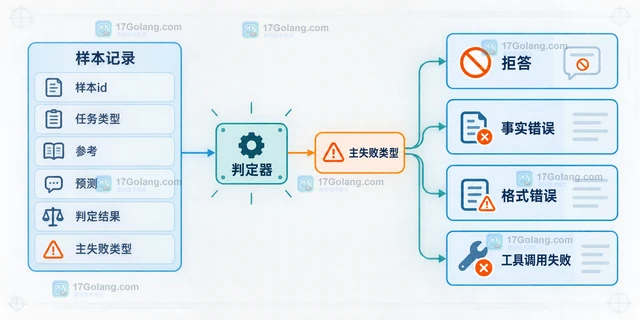 把模型评测样本按拒答、事实错误、格式错误和工具调用失败等类型切桶,分别计算指标,再用固定分桶对比模型版本,避免总分掩盖局部回归。173 收藏
-
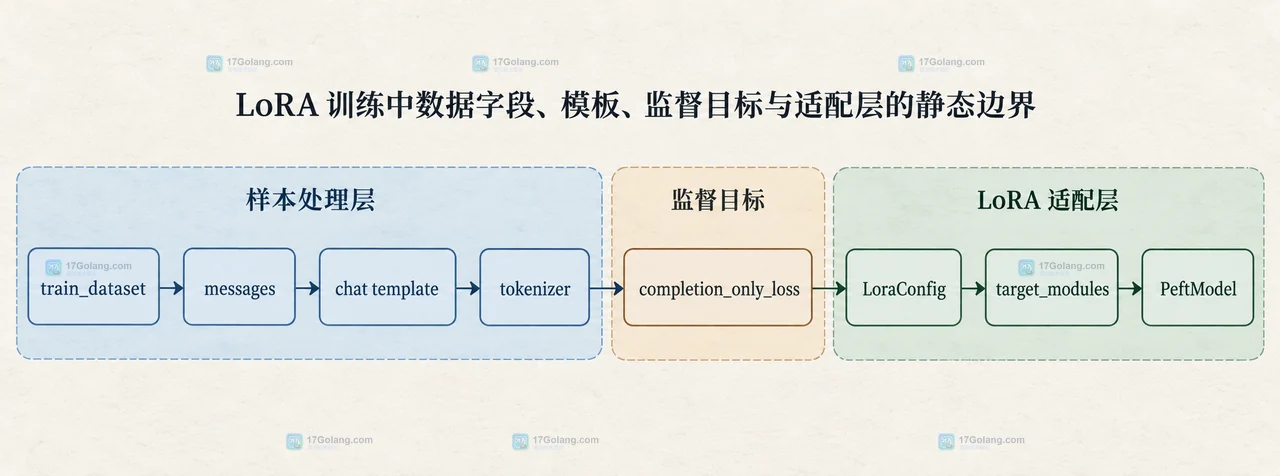 使用 Hugging Face TRL 做 LoRA 微调时,先把 instruction、input、output 等业务字段统一为 text、messages 或 prompt/completion,再分别排查聊天模板、损失目标和 target_modules 配置。171 收藏
-
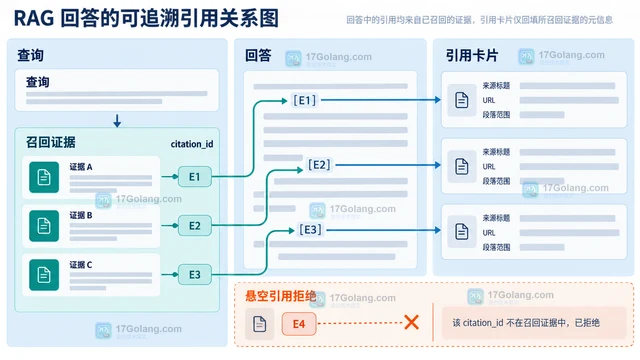 RAG回答要可追溯,关键不是把链接拼到末尾,而是让每个检索片段从入库开始就带有稳定来源身份、位置和引用编号。本文给出证据记录、提示词传递、引用渲染与回归检查的实现方法。171 收藏
-
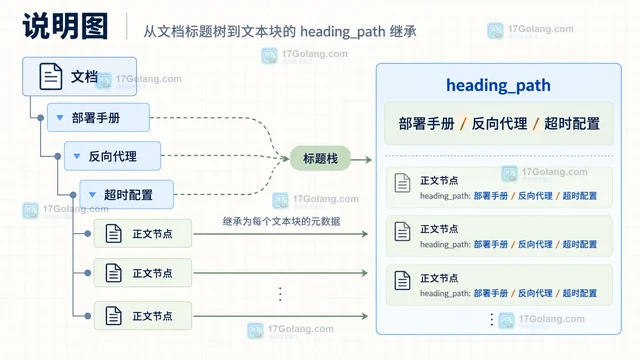 长文档做RAG时,先解析标题树并把标题路径、来源位置和版本写入chunk metadata,再按语义边界切分和重建上下文,减少检索片段丢失章节语境的问题。170 收藏
-
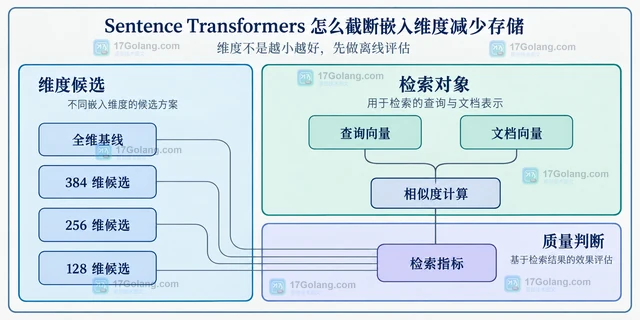 本文介绍如何用 Sentence Transformers 的 truncate_dim 与 truncate_embeddings 缩短嵌入向量,计算理论存储节省,并通过离线检索指标选择维度,说明 Matryoshka 模型、归一化、索引迁移和推理性能的边界。165 收藏
-
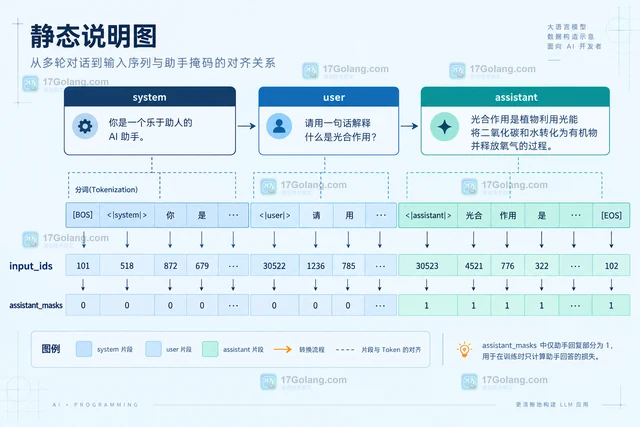 Transformers 的 apply_chat_template 可以通过 generation 块记录 assistant 内容,并返回与 input_ids 对齐的 assistant_masks。本文说明参数组合、模板写法、训练标签转换和全零掩码排查边界。164 收藏
-
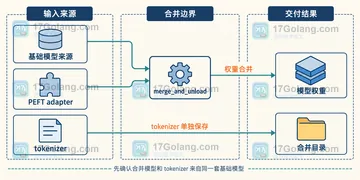 LoRA 合并只处理 adapter 权重,不会自动替你保存正确的 tokenizer。本文用一套可复用的核对脚本检查词表、特殊 token、长度配置和嵌入尺寸,避免合并模型上线后出现输入映射不一致。162 收藏
-
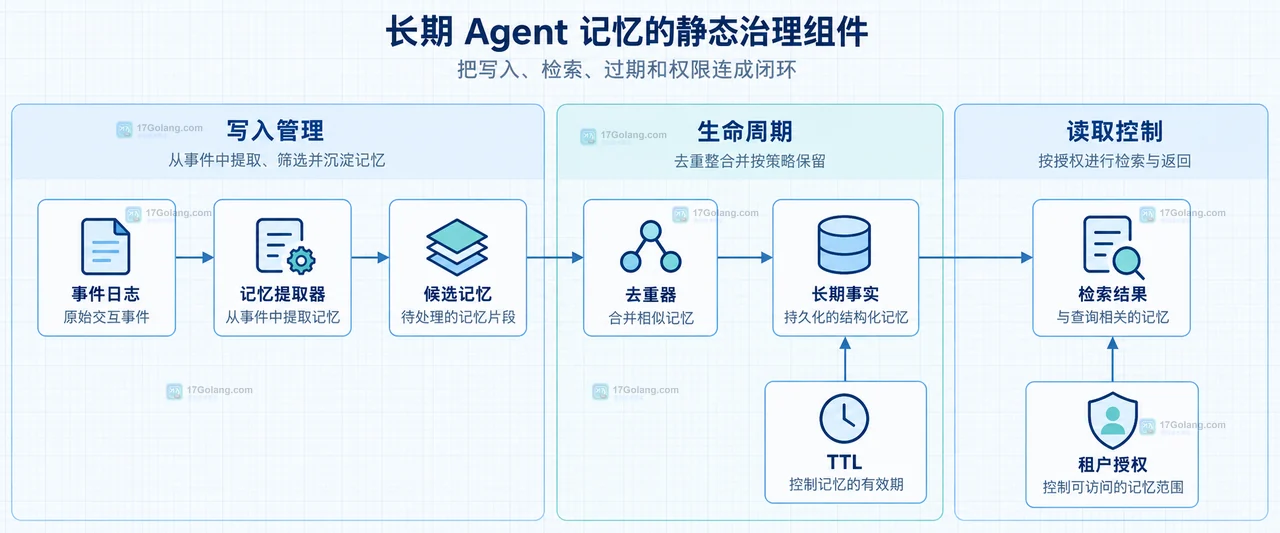 AI Agent 的短期上下文负责当前线程,长期存储负责跨会话复用。本文从边界、数据类型、写入检索和权限保留四个方面给出一套可落地的记忆设计方法。155 收藏
-
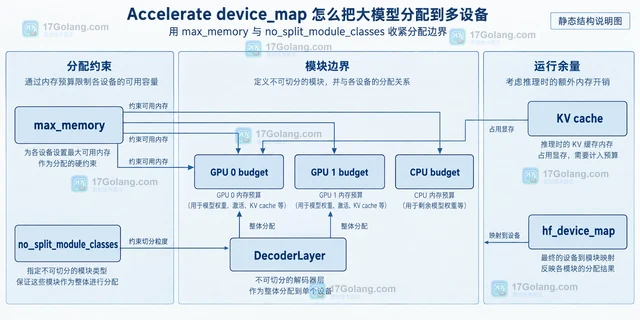 通过 Transformers 与 Accelerate 的 device_map=auto、max_memory 和 no_split_module_classes,把大模型稳妥分配到多张 GPU,并检查 CPU 或磁盘卸载边界。150 收藏
-
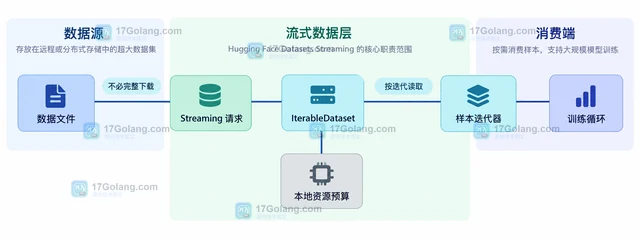 Hugging Face Datasets Streaming 通过 IterableDataset 边迭代边读取超大数据集。本文给出加载、抽样、缓冲打乱、在线变换、分片与训练观测的完整用法和适用边界。148 收藏
-
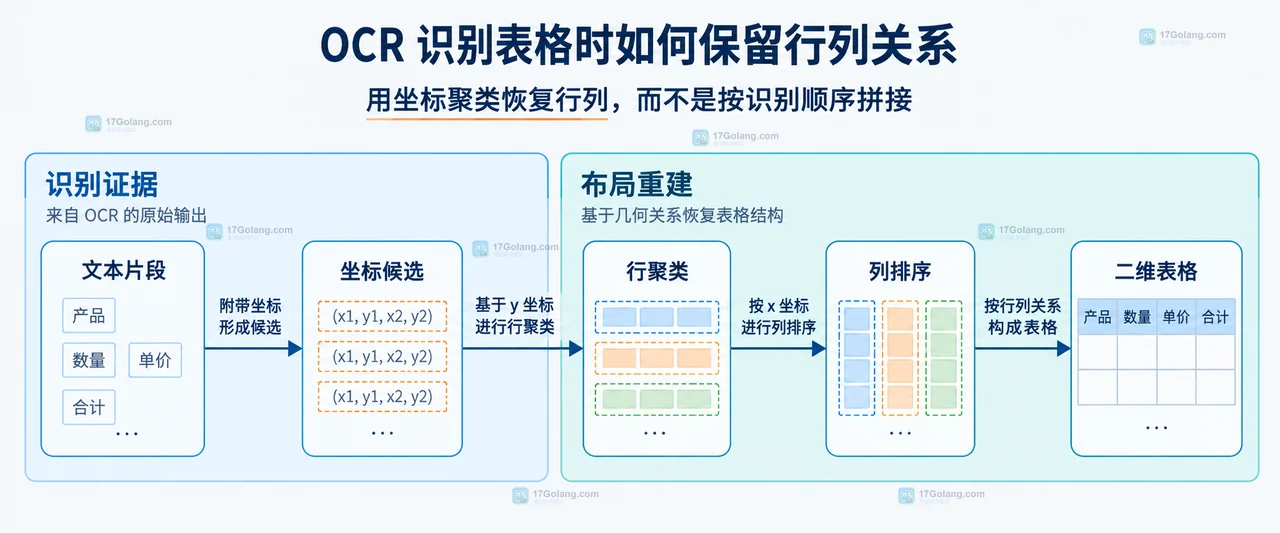 OCR 识别表格不能只保留文字,还要保存每个片段的坐标框,再通过行聚类、列排序和跨度判断重建二维结构。本文给出一套可落地的处理流程。147 收藏
-
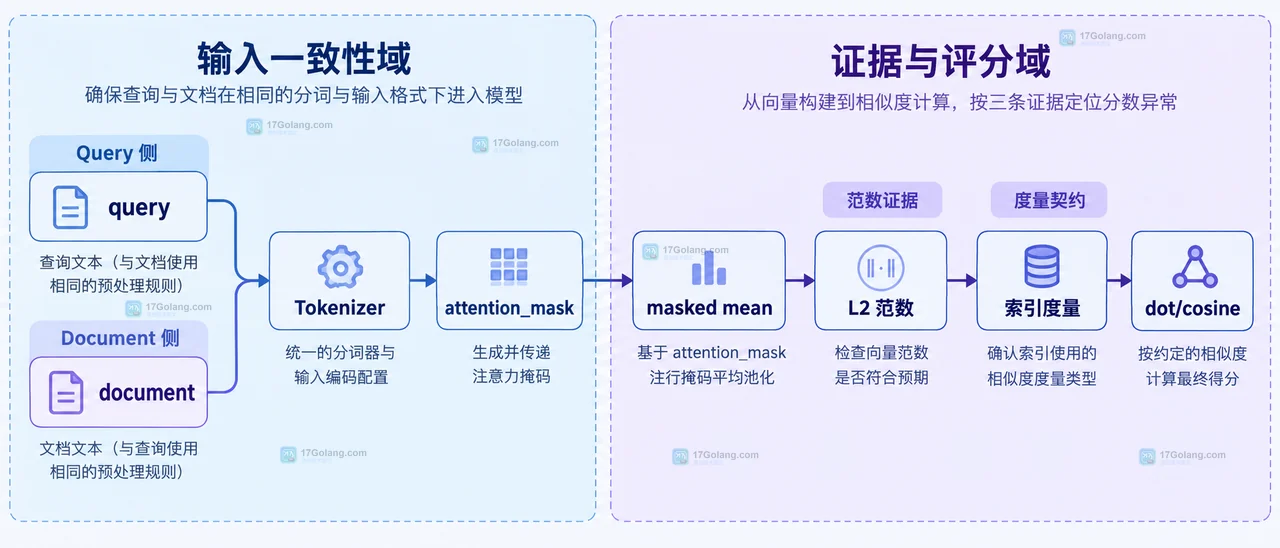 embedding 归一化不是简单打开一个开关:先统一 query 与 document 的向量契约,再检查池化、attention_mask 和相似度度量。本文给出两种配置方式和一套可复用的排查清单。147 收藏