
RAG 引用定位如何把 chunk ID 传回最终回答
来源:17golang原创
时间:2026-09-15 00:18:17 111浏览 收藏
我在做 RAG 问答时最容易踩的坑,不是“检索不到”,而是检索到了以后,回答里的引用无法回到原片段。解决办法是把 chunk_id 当成证据主键:检索层返回它,模型只负责选择它,应用层再把它映射成标题、页码和原文位置。这样即使答案改写了,引用仍然可追溯。
不要让模型直接生成来源 URL。让它返回检索上下文中已经存在的 chunk_id,并在服务端做一次白名单校验。
- 片段身份:
document_id+ 稳定的chunk_id。 - 回答格式:
answer与citations分开。 - 回填原则:无效 ID 不展示,缺失位置就标记待复核。
先把 chunk ID 设计成稳定的证据主键
我第一次实现时用检索结果数组下标当引用编号,重新排序或换 embedding 后,旧回答就指向了错误片段。更稳妥的记录至少包含下面几个字段:document_id 表示文档版本,chunk_id 表示片段,source_title 和 chunk_text 负责展示。
retrieved = [
    {
        "document_id": "handbook-v3",
        "chunk_id": "handbook-v3:c0012",
        "source_title": "部署手册",
        "chunk_text": "回滚前先保留上一版本的配置快照。",
    }
]
# 注释:chunk_id 不使用临时数组下标,重排结果后仍能定位原片段。
index = {item["chunk_id"]: item for item in retrieved}
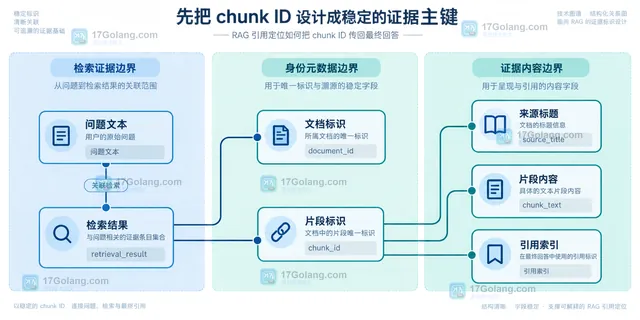
如果文档会重新切片,建议把版本写进 document_id,不要复用旧片段 ID。引用要能回答“来自哪份文档、哪一块内容”,而不是只回答“排在结果数组第几位”。
把带 ID 的证据上下文交给模型
检索结果不要直接拼成一段没有边界的长文本。可以给每个片段加上稳定标记,并明确告诉模型:只能引用这些标记。OpenAI 的 Responses API 支持调用 file search,也可以通过 include 请求检索结果;如果业务需要自己的 chunk_id,仍应在自建检索层或工具返回值中保留这个字段。
evidence = "\n\n".join(
    f"[chunk_id={item['chunk_id']}]\n{item['chunk_text']}"
    for item in retrieved
)
# 注释:提示词只允许引用本轮证据中的 ID,避免模型凭空创造链接。
instruction = f"只根据证据回答;引用必须来自已有 chunk_id。\n{evidence}"
官方参考:https://developers.openai.com/api/reference/overview
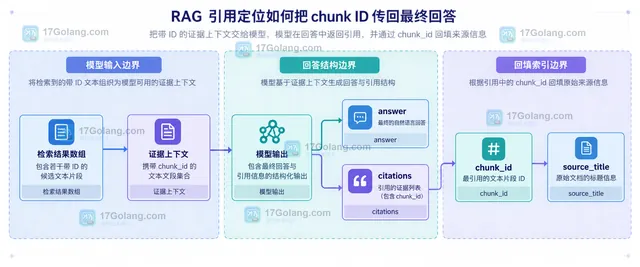
让最终回答返回可校验的 citations
不要只要求模型在自然语言里写“参考资料:……”。更好的是让结果包含两个字段:answer 是读者看到的正文,citations 是数组,每项只放 chunk_id 和可选的证据说明。若使用结构化输出或函数调用,应用层先解析 JSON,再检查引用是否存在于本轮检索结果。
payload = {
    "answer": "回滚前应保留上一版本配置快照。",
    "citations": [{"chunk_id": "handbook-v3:c0012", "claim": "回滚前保留配置快照"}],
}
# 注释:服务端白名单校验后才把标题、页码等展示字段补回去。
valid_citations = [
    {**citation, "source_title": index[citation["chunk_id"]]["source_title"]}
    for citation in payload.get("citations", [])
    if citation.get("chunk_id") in index
]
这里的取舍很明确:模型适合判断“哪一片证据支持这句话”,不适合决定数据库里的公开 URL、页码或权限。那些字段应从 index 或文档元数据服务回填。
什么时候该选内置引用,什么时候保留自定义 ID
| 场景 | 建议 | 原因 |
|---|---|---|
| 只展示文件级来源 | 优先使用平台返回的文件引用或 annotations | 接入成本低,来源由平台维护 |
| 需要页码、段落、权限过滤 | 自建 chunk_id 白名单 | 业务元数据必须由自己的服务回填 |
| 答案要进入审计或工单 | 保存回答、检索快照和 citations | 后续可重放当时的证据集合 |
我的经验是:平台内置引用适合快速验证链路,自定义 chunk_id 适合正式产品。两者可以并存,但不要把“模型输出了一个看起来像 URL 的字符串”当成引用成功。
常见问题
chunk_id 要不要直接用数据库自增 ID? 可以,但最好再带上文档版本或租户边界,避免不同知识库之间发生碰撞。
模型返回了不存在的 chunk_id 怎么办? 丢弃这条引用并记录待复核,不要为了让页面有引用而自动拼接未知链接。
为什么有 ID 仍然定位不准? 重点检查切片版本、重排后的检索快照和权限过滤;引用校验只能保证“指向存在的片段”,不能替代召回和排序质量。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
356 收藏
-
403 收藏
-
120 收藏
-
457 收藏
-
449 收藏
-
383 收藏
-
科技周边 · 人工智能 | 10小时前 | 人工智能 · openai api · 工程实践 · 批处理 · OpenAI Batch API custom_id 批量请求结果映射 JSONL 结果回配105 收藏
-
146 收藏
-
科技周边 · 人工智能 | 13小时前 | openai · json schema · Structured Outputs · OpenAI Nullable Schema JSON Schema Structured Outputs281 收藏
-
科技周边 · 人工智能 | 14小时前 | 人工智能 · openai api · 检索增强生成 · 文件搜索 · OpenAI Attributes 元数据过滤 Responses API File Search vector store426 收藏
-
科技周边 · 人工智能 | 15小时前 | 异步任务 · 人工智能 · openai api · 接口开发 · 轮询 后台任务 background true OpenAI Responses API response_id314 收藏
-
345 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习