
人工智能技术文章
-
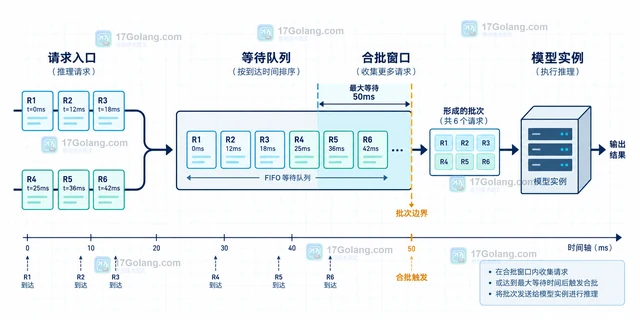 模型服务的批处理不是把 batch size 调大就结束。本文用 Triton 动态批处理和 TGI 连续批处理说明如何设置排队等待上限、批量或令牌预算,并用队列长度、prefill/decode 时长与端到端 p95 验证吞吐收益。479 收藏
-
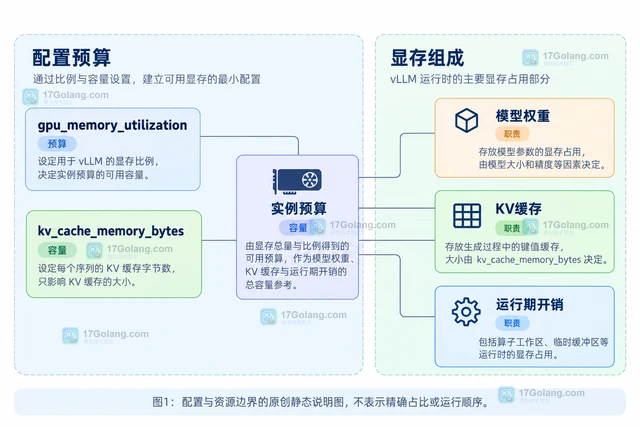 限制 vLLM 显存需区分实例比例预算、KV 缓存大小和上下文并发约束。本文给出保守启动示例,说明参数优先关系、共享GPU边界、失败回退与运行记录,不承诺固定节省比例。476 收藏
-
科技周边 · 人工智能 | 2星期前 | 人工智能 · 深度学习 · 内存优化 · 内存 PyTorch 按需加载 mmap checkpoint torch.load map_location state_dict
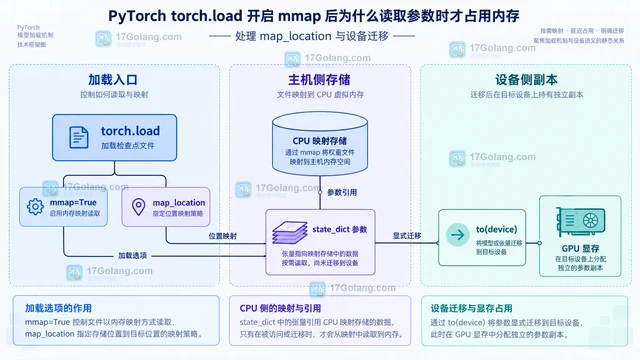 torch.load 的 mmap=True 建立的是检查点文件映射,不是把全部参数立即复制进物理内存。本文结合首次访问、CPU 映射和 to(device) 迁移,解释虚拟地址、驻留页与设备副本的区别,并给出大检查点的加载取舍。475 收藏
-
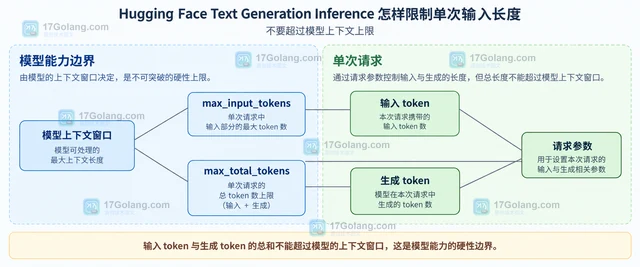 TGI 的输入长度不能只看 max_input_tokens。本文拆开 max_input_tokens、max_total_tokens、max_new_tokens 与模型上下文上限,给出配置示例、取舍和上线前检查方法。474 收藏
-
科技周边 · 人工智能 | 3星期前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size
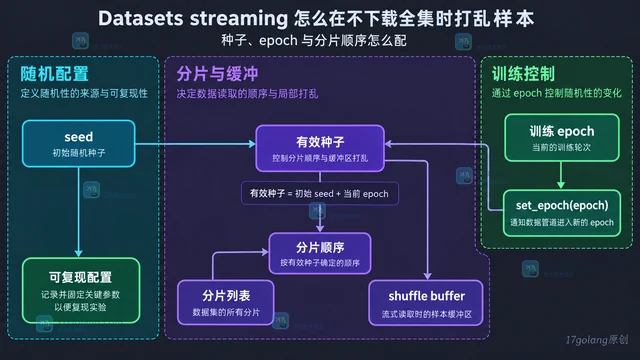 Hugging Face Datasets 的 streaming 模式可用 IterableDataset.shuffle 在有限缓冲区内随机采样,无需下载完整数据集。本文说明 buffer_size、seed、set_epoch、分片顺序以及 take/skip 的调用边界。470 收藏
-
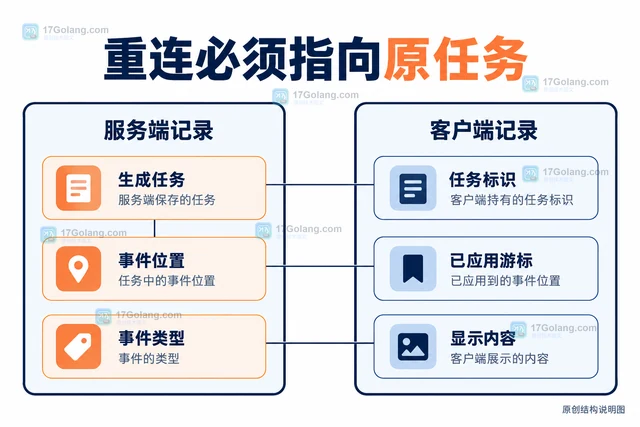 AI 流式断线恢复需区分连接重建、原任务事件重放与重新生成。本文说明 EventSource 和 fetch 的差异,给出任务标识、事件游标、去重、保留窗口与完成状态的设计方法。470 收藏
-
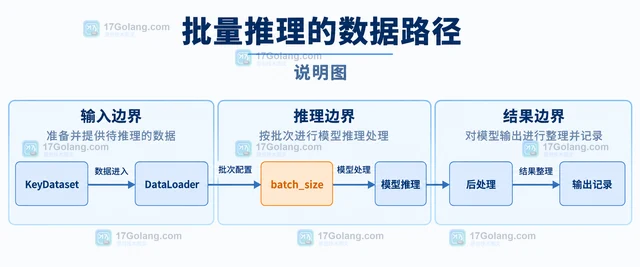 Hugging Face pipelines 的 batch_size 适合在可批处理的数据集推理中逐步调节。本文说明参数放在哪里、GPU 与 CPU 的边界、sequence_length 对显存的影响,以及如何记录吞吐、延迟和 OOM 风险。469 收藏
-
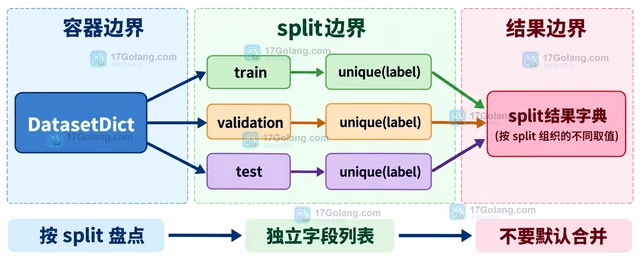 Hugging Face Datasets 的 Dataset.unique 和 DatasetDict.unique 可以直接列出字段的不同取值。本文用最小示例说明字段检查、split 结果、返回顺序以及高基数字段的内存边界。469 收藏
-
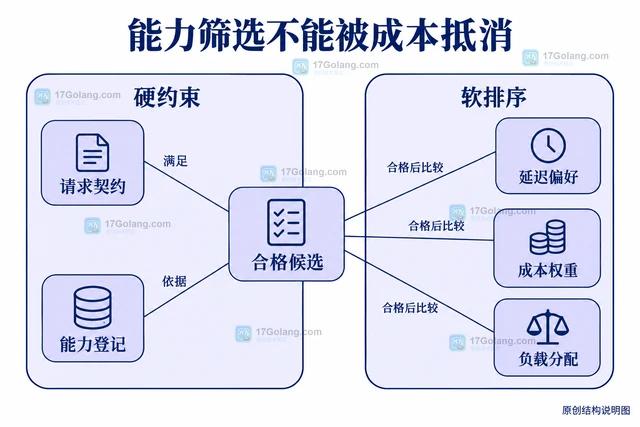 AI 网关应先按输入模态、工具、结构约束及业务允许范围过滤候选,再比较延迟和成本。本文说明端点能力登记、路由策略与故障回退边界,避免降级时丢失原请求语义。467 收藏
-
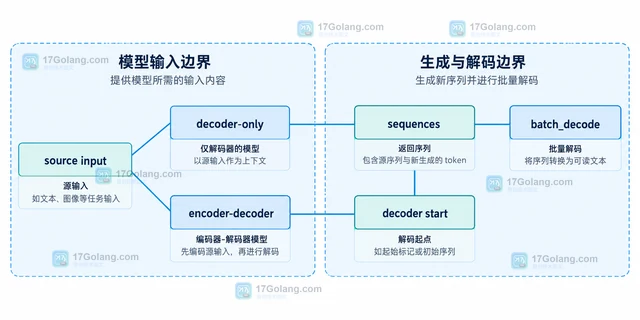 讲清 Transformers generate 返回完整序列的原因,分别处理 decoder-only 与 encoder-decoder 模型,用输入长度切出新生成 token,并给出批量解码、特殊 token 和空结果的处理方式。461 收藏
-
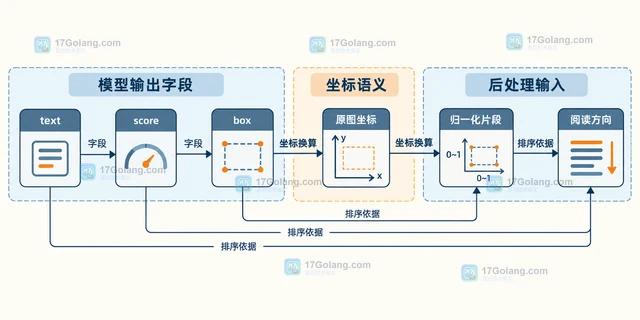 视觉模型返回的 OCR 片段常常不是阅读顺序。本文用统一坐标、垂直中心排序、动态行高阈值和行内 x 排序,把文字框稳定合并成可读文本,并说明多栏、竖排和低置信度结果的边界。461 收藏
-
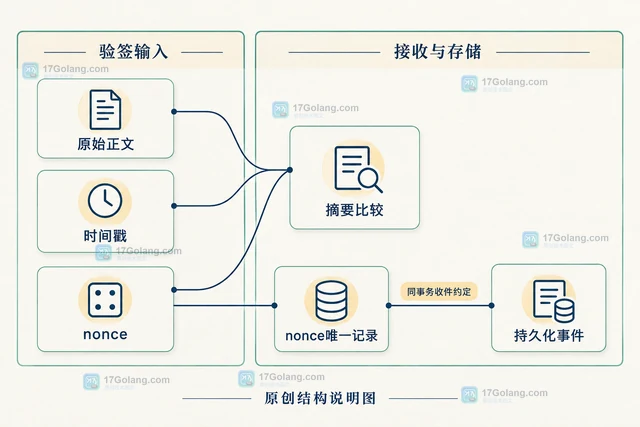 Label Studio 普通 webhook 可配置认证头,动态 HMAC 需另行实现。本文区分标注创建与任务完成,给出自建中继签名约定、原始正文校验及防重放与持久化边界。459 收藏
-
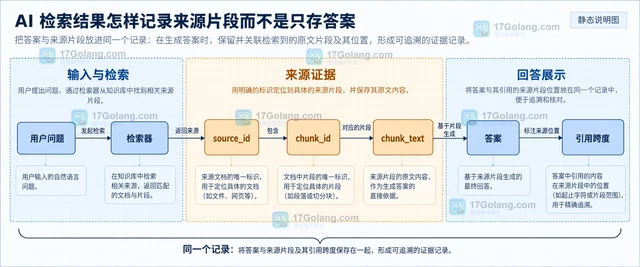 AI 应用不要只保存最终答案。本文用检索增强的常见数据模型说明如何保存 source_id、chunk_id、chunk_text、回答片段和支持关系,并结合 Gemini groundingMetadata 的 groundingChunks 与 groundingSupports 设计可追溯记录。456 收藏
-
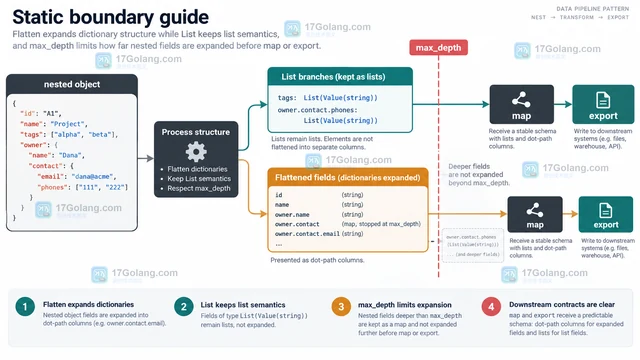 Hugging Face Datasets 的 flatten 会把嵌套字典字段展开为点号路径列,同时保留 Features 对字段类型的描述。本文用嵌套 struct、List 和 max_depth 说明如何安全接入后续 map 处理。455 收藏
-
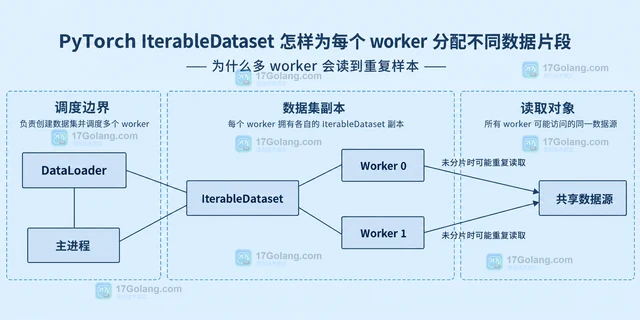 使用 PyTorch IterableDataset 配合 DataLoader 多 worker 时,数据集对象会复制到各个进程,直接迭代容易读到重复样本。本文用 get_worker_info 在 __iter__ 中计算半开区间,说明不整除、尾部数据和 drop_last 的边界。455 收藏