
人工智能技术文章
-
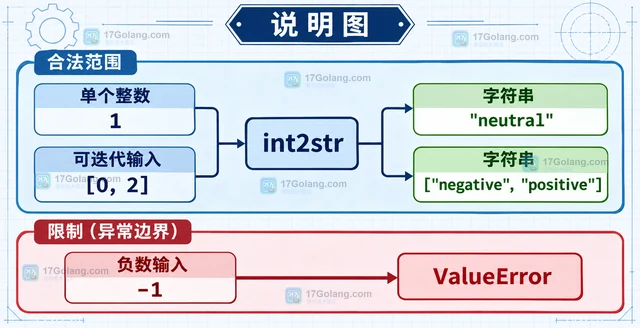 用 Hugging Face Datasets 的 ClassLabel.int2str,把整数标签还原为类别名称,并说明批量输入、负数异常与普通整数列的适用边界。175 收藏
-
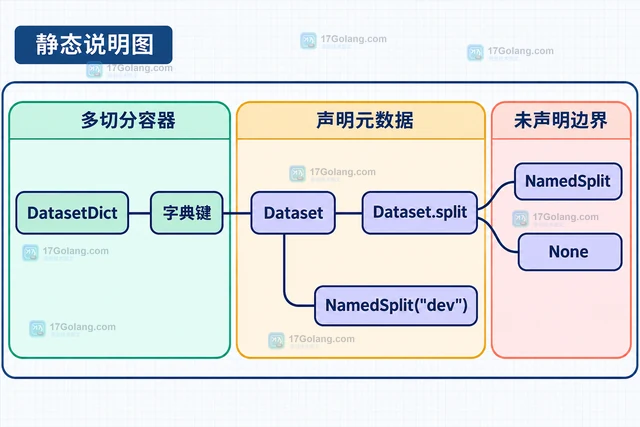 用 Hugging Face Dataset.split 和 NamedSplit.name 识别单个数据集对象的切分名称,区分 DatasetDict 的字典键、手工 Dataset 的 None 边界以及自定义切分的显式声明。476 收藏
-
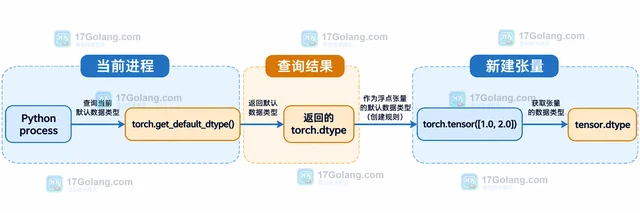 用 torch.get_default_dtype() 读取 PyTorch 当前默认浮点类型,分清已有张量 dtype、显式 dtype 与新建张量默认类型之间的关系。316 收藏
-
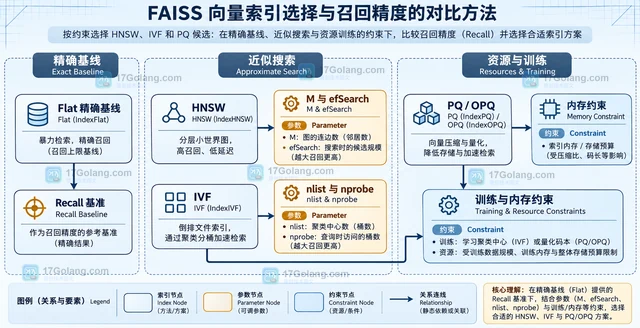 用 IndexFlat 建立精确基线,再比较 HNSW、IVF 与 PQ 组合的 Recall@K、查询延迟和内存占用,给出可复现的 FAISS 索引选型方法。212 收藏
-
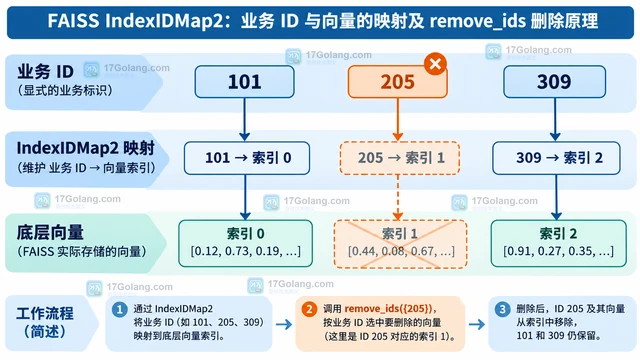 FAISS IndexIDMap2 适合把业务 ID 与向量绑定后再维护索引。本文用 Python 说明怎样写入自定义 ID、按 ID 批量删除、读取删除数量,并解释删除后其他 ID 为什么不会像顺序位置那样整体前移。334 收藏
-
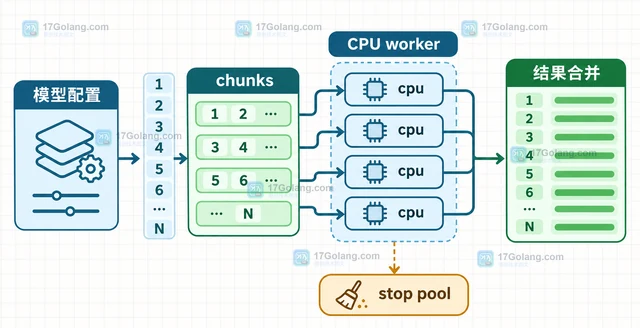 Sentence Transformers 多进程编码时,可以通过 device 列表把 CPU 或 GPU 显式映射到独立 worker,并用 chunk_size 控制任务切分。本文说明一卡一进程、CPU worker 数量、显式 pool 复用与 stop_multi_process_pool 释放的边界。301 收藏
-
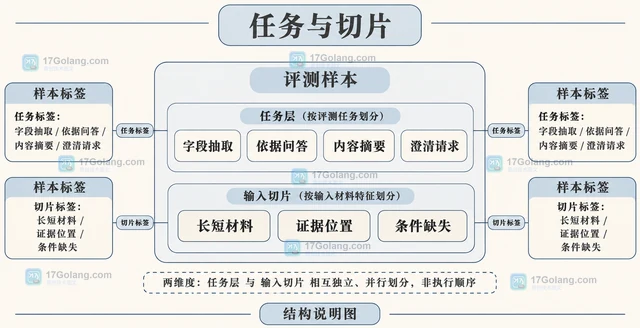 以客服助手为例,说明生成式模型评测集如何划分任务与切片、保存评分条件、配置常规集和挑战集,解释分层结果与加权汇总的区别,并维护固定测试集。313 收藏
-
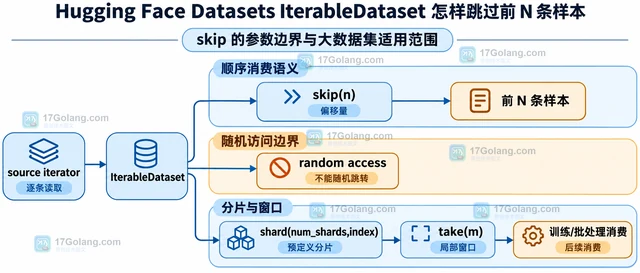 说明 Hugging Face Datasets 流式 IterableDataset 怎样用 skip(n) 跳过前 N 条样本,再用 take(m) 限制读取窗口;同时解释 shuffle 顺序、顺序消费成本、随机访问边界和 shard 分片选择。294 收藏
-
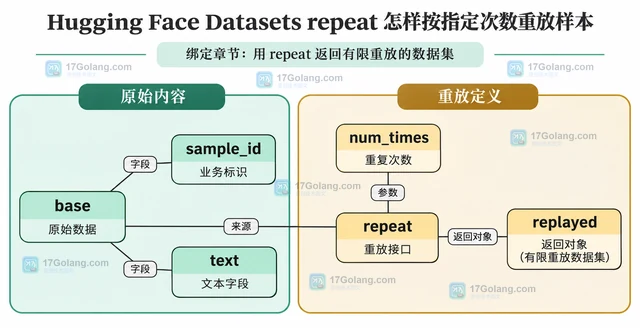 用两条本地样本说明 Hugging Face Datasets repeat 的有限次数重放,比较 Dataset 与 IterableDataset 的返回对象、样本顺序和可重复数据源,并给出有限消费约束。195 收藏
-
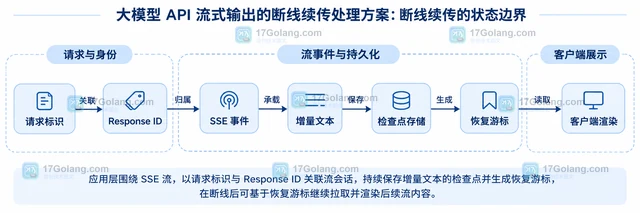 大模型 API 的 stream=true 通常通过 SSE 发送增量事件,但客户端重连并不等于上游模型自动续流。本文用服务端检查点、游标重放和幂等任务记录,设计一套可控的断线恢复方案,并说明不能直接拼接两次生成结果的边界。403 收藏
-
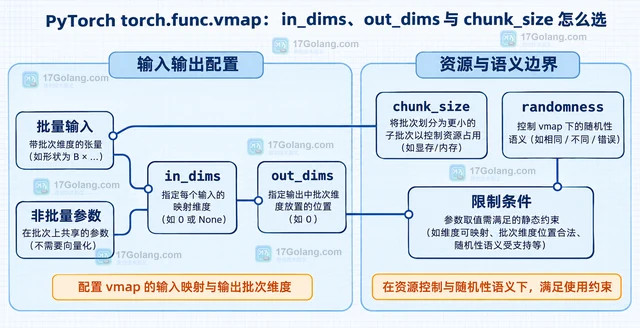 把单样本函数改成批量处理时,不必先手写一层 for 循环。PyTorch 的 torch.func.vmap 可以沿指定输入维度提升函数,同时用 in_dims、out_dims 和 chunk_size 控制维度与显存边界。230 收藏
-
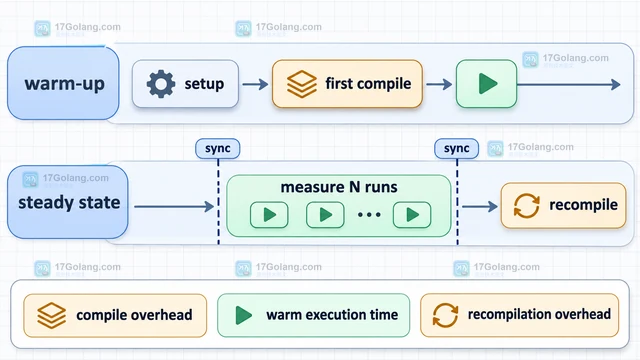 PyTorch torch.compile 的第一次调用可能包含图捕获、编译和缓存建立,不能直接与后续调用比较。本文用分阶段计时、设备同步、预热循环和 guards 日志,区分首次编译、缓存命中与输入变化触发的重新编译。231 收藏
-
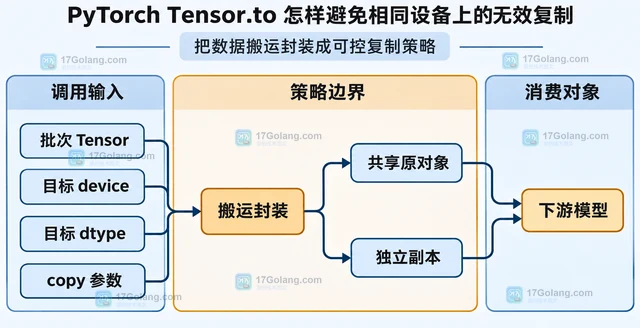 解释 PyTorch Tensor.to 在相同 dtype 和 device 下的返回语义,区分默认 no-op 与 copy=True 强制复制,并给出可复用的数据搬运封装。294 收藏
-
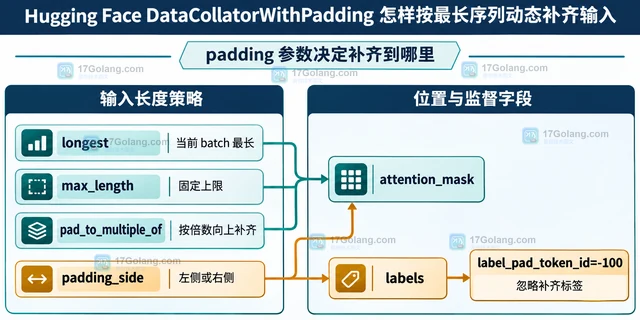 用 Hugging Face DataCollatorWithPadding 在组 batch 时按最长序列动态补齐输入,解释 padding、max_length、attention_mask、标签 collator 与 pad_to_multiple_of 的选择。144 收藏
-
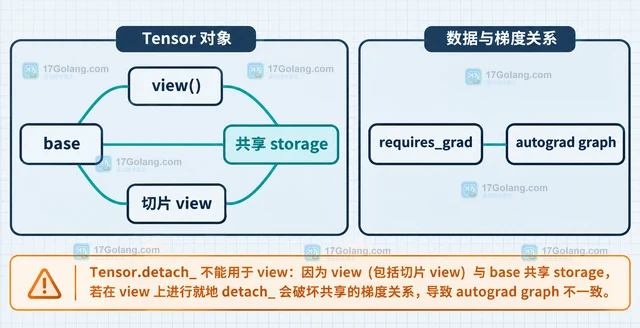 PyTorch 的 Tensor.detach_ 是原地切断计算图的方法,但 view 不能使用它。本文从共享底层数据的关系出发,说明 detach_、detach 和 clone().detach() 的选择边界。230 收藏