-
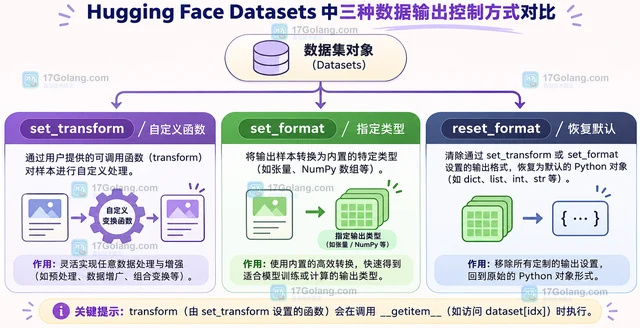
Hugging Face Datasets 的 set_transform 可以在索引或切片取样时按需生成模型输入和派生字段。本文说明 columns、output_all_columns、reset_format 与 with_transform 的边界,并给出保留原始列和生成 tokenizer 字段的原创示例。
-
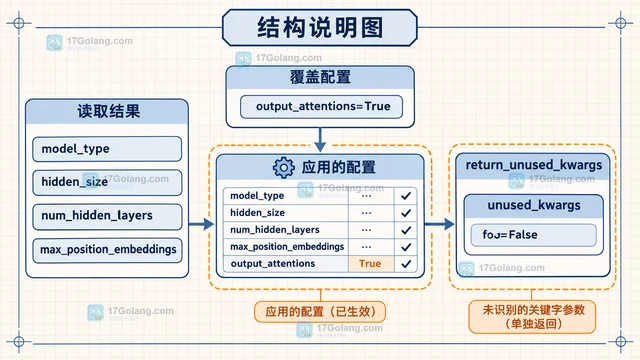
Transformers 的 AutoConfig.from_pretrained 可以在加载模型权重前读取配置对象。本文用一个窄而实用的流程说明如何查看 model_type、hidden_size、num_hidden_layers 和 max_position_embeddings,怎样覆盖配置字段,以及如何用 return_unused_kwargs 识别拼写或边界错误。
-
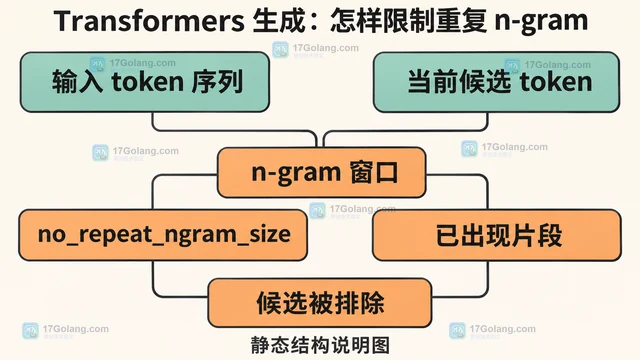
介绍 Transformers generate 中 no_repeat_ngram_size 的工作边界、最小配置和取值思路,解释 token 级 n-gram 约束与 repetition_penalty 的区别,并给出短文本、术语密集文本和 encoder-decoder 场景的落地清单。
-
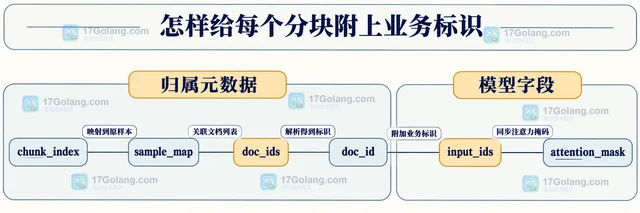
说明 Transformers BatchEncoding 的 overflow_to_sample_mapping 如何关联分块与原批样本,给出 truncation、stride 和业务文档 ID 的处理示例,并澄清分块编号与样本下标的区别。
-
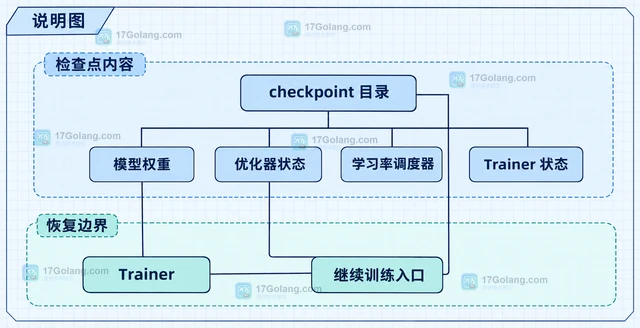
Transformers Trainer 继续训练时,不能只加载模型权重,而要把完整 checkpoint 交给 train(resume_from_checkpoint=...)。本文说明优化器、调度器、global_step、检查点目录和 ignore_data_skip 的关系,并给出显式路径与自动寻找最近检查点的写法。
-
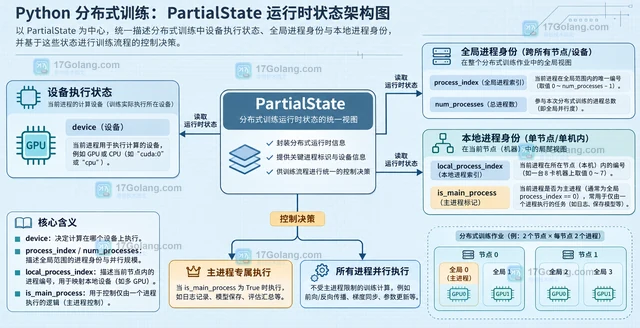
只需要读取分布式脚本的当前设备、全局进程编号、本机进程编号和进程总数时,可以直接使用 Hugging Face Accelerate 的 PartialState。本文用一个最小示例拆开四个属性的区别,并说明主进程输出与多机逻辑的写法。
-
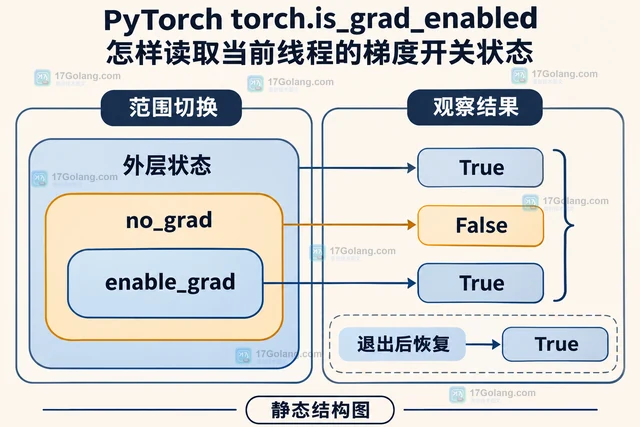
torch.is_grad_enabled() 用于读取当前执行上下文是否开启梯度记录。本文用最小示例说明它在默认模式、no_grad 和 enable_grad 中的变化,并区分它与 requires_grad、model.eval()、inference_mode 的职责。
-
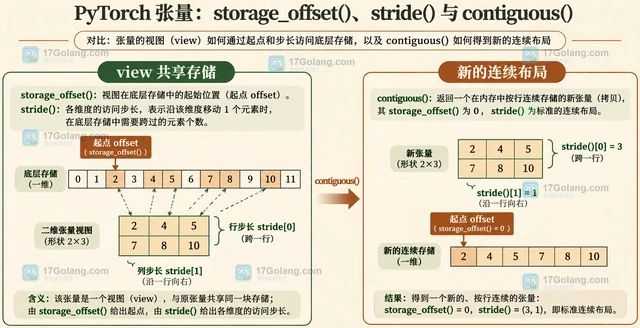
用切片和转置示例说明 PyTorch Tensor.storage_offset() 的读取方式,解释返回值是底层 storage 的元素偏移而非字节数,并把 storage_offset、stride、numel 与 contiguous() 放在同一套布局排查方法中。
-
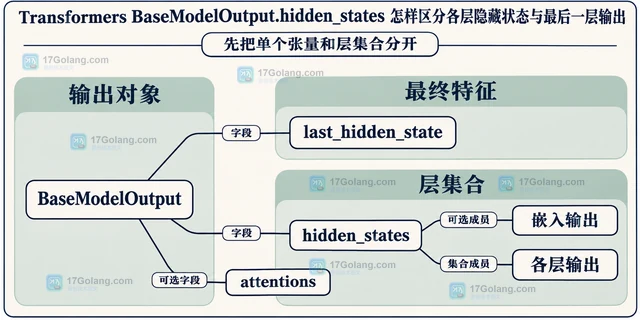
区分 Transformers BaseModelOutput 的 hidden_states 层集合与 last_hidden_state 最终特征,说明开启方式、嵌入输出索引和张量形状,并提醒跨模型不保证二者末项恒等。
-
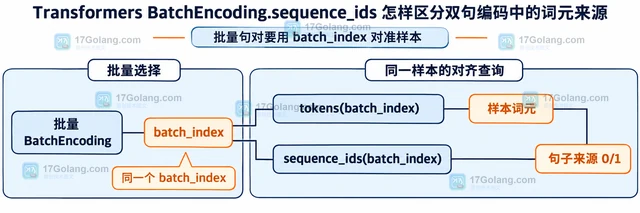
Transformers 的 BatchEncoding.sequence_ids 可以把双句编码中的词元映射回来源序列:特殊词元为 None,第一句为 0,第二句为 1。本文说明 Fast tokenizer、批量下标、padding 以及它和 token_type_ids 的边界。
-
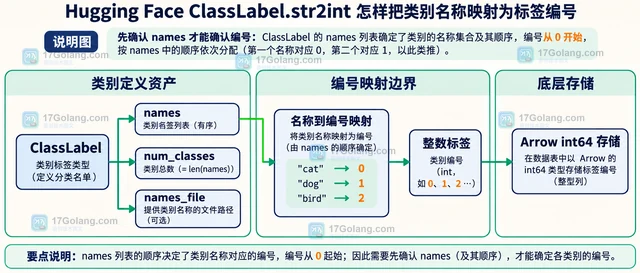
用 Hugging Face Datasets 的 ClassLabel.str2int 把类别名称转换成整数标签,说明 names 顺序、单值与批量返回、空白和数字字符串处理,以及非法标签的边界。
-
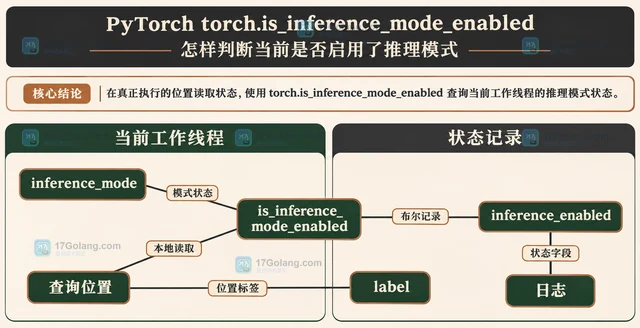
用局部上下文和预测入口示例说明 PyTorch 推理模式查询,解释布尔返回、线程局部性,并区分梯度开关、模型训练标记与推理状态。
-
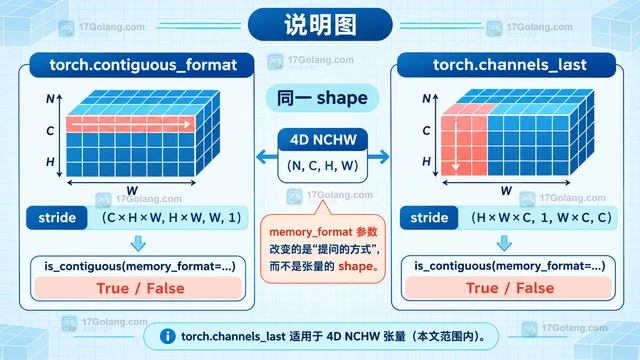
PyTorch Tensor.is_contiguous() 默认检查 contiguous_format,也可以传入 channels_last 等 memory_format。本文用 shape、stride 和对照代码说明怎样判断布局,以及尺寸为 1 时的边界。
-
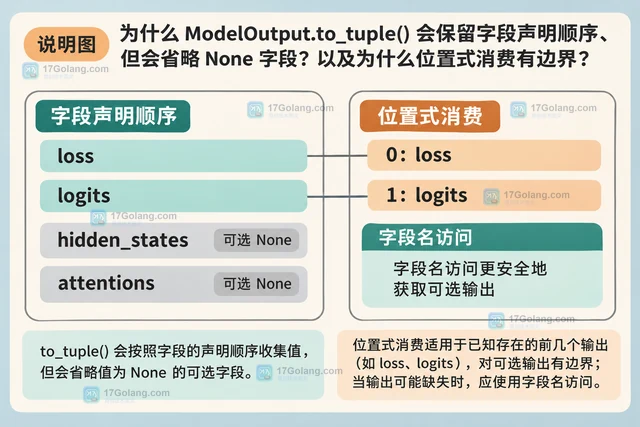
说明 Transformers ModelOutput.to_tuple 如何按字段声明顺序收集非 None 值,给出模型输出转元组的写法,并解释可选字段、位置错位和 return_dict=False 的边界。
-
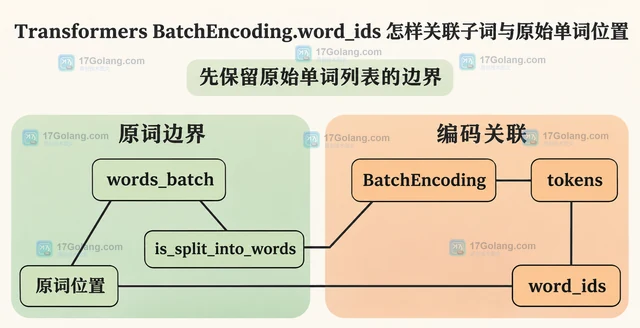
介绍 BatchEncoding.word_ids 如何把 token 关联到原词位置,提供 fast tokenizer 批次示例和首子词标签对齐写法,并解释 None、填充、截断与句对的限制。
